以下为已开放 4 个文件的静态全文(前言 · 第 6 章 GEO 核心概念 · 第 12 章 房地产与汽车赛道:意图定位与 Query Fan-out(高阶级) · 附录),可直接阅读;启用 JavaScript 后可获得章内导航、级别筛选与阅读进度。
前言:AI 时代为什么必须学 GEO
前言 · 11 节 / 39 小节 · 约 1.8 万字
版本说明(国内版):本书是国内版教程,面向中国大陆市场的 AI 引擎与内容生态(即正文所列的国内主流 AI 引擎与内容平台)。面向外贸与跨境电商场景的国际版教程正在开发中,将覆盖海外 AI 搜索引擎、英文信源生态与跨语言内容策略;国际版发布前,涉及海外场景的判断请以系统体检输出与公开文档为准。
命名口径:本书的「八引擎」指国内八大 AI 引擎(文心一言 / 元宝 / 千问 / DeepSeek / 豆包 / Kimi / 纳米搜索 / 智谱清言),与平台口径一致;海外引擎不在本书范围内。
本章导读
本文件是整本教材的「入口章」,回答三件事:为什么要学 GEO、GEO 是什么、怎么把这本书学完。读者在本章建立全局认知后,再进入第 1 章起的系统学习。
如果你是第一次接触「GEO」这个词,不要有压力——它并不玄。它的核心问题只有一句:在 AI 代为做决定的时代,你的品牌有没有被 AI 看见、被 AI 说到、被 AI 信任。看懂这句话,你就已经站在理解 GEO 的门口。
本章不会教你任何需要动手的操作,它的任务是先把「世界观」摆正:
- 0.1–0.2 讲变化的必然性:为什么消费决策入口正在从搜索框搬到对话框,用数据证明这不是炒作,而是正在发生的事实;
- 0.3 讲我们学的东西到底是什么:GEO 的定义、它与传统 SEO 的本质区别,以及最关键的认知升级;
- 0.4 讲学习的底层纪律:本教材坚持「数据驱动而非纸面」,你该怎么辨别哪些结论可信;
- 0.5 给出一张术语总览图:把 SEO/LSO/VSO/AEO/GEO 这条演进主线一次理顺;
- 最后的第 0 部分 + 使用指南:告诉你怎样用最短路径把这本教材吃透,五条学习路径怎么选、章节的级别徽标怎么读。
读完整章,你应当能:向别人一句话说清「为什么此刻必须学 GEO」,认出教材里的每个关键术语,并且选好自己的学习路径。这是一个「建立认知」的章节,后续所有章节都是在这张地图上逐格点亮。
0.1 一个正在发生的转变:消费决策入口从搜索框搬到对话框
0.1.1 过去二十年:货架时代
先从一个我们都熟悉的事实说起。过去二十年,线上获客的战场一直是「搜索结果列表」。用户输入关键词,搜索引擎返回十条蓝色链接,凡是排名靠前的品牌,就能获得绝大多数点击。这套机制的底层逻辑是排名:谁排前面,谁赢得点击;谁赢得点击,谁就有流量;有流量,才有转化。
于是,一个完整的产业围绕「排名」运转起来:
| 环节 | 做什么 | 对应工种 |
|---|---|---|
| 内容层 | 围绕关键词生产能排名的页面 | 编辑 / 写手 |
| 技术层 | 保证页面能被爬取、被索引、加载快 | 技术 SEO |
| 链接层 | 让更多页面把权重「票投」给你 | 外链 / 推广 |
| 数据层 | 监测关键词排名涨跌、点进来多少 | 数据分析 |
这一整套方法,业内统一称为 SEO——即「对搜索引擎优化」。它的目标词语是一个货架隐喻:
搜索引擎是超级市场的货架,用户是推着购物车逛的顾客,你的品牌只是一个「货品」。SEO 的活,就是给货品抢占一个靠前、显眼、被更多路过的顾客看到的货架位置。
在这个货架时代,很多生意是被「成为搜索结果的第 1 名」这件事驱动的。一个更靠前的结果位,可能就是数倍的流量差距,于是企业愿意花大价钱在排名上投入。这套玩法运行了二十多年,相当成熟,也相当内卷。
0.1.2 今天:战场开始搬家
但现在,情况悄悄变了。用户在搜索时的行为,正在从「输入关键词、翻遍历条结果、逐个打开网页」逐步变成「打开一个人工智能对话入口,问一句完整的话,然后直接采信 AI 组织的答案」。
你不需要想象这个场景,因为这大概率就是你我在最近几个月里的真实行为。用户不再逐一点开十个链接,而是打开几个主流的人工智能对话/内容引擎(文心一言、元宝、千问、DeepSeek、豆包、Kimi、纳米搜索、智谱清言 等),直接问一句:
「哪家的 CRM 适合 20 人的团队,还便宜?」
然后 AI 直接吐出一个它自己组织的答案,可能还带着几个引用来源,并排好了条理:谁更合适、为什么合适、要注意什么。
这一小步改变,意义极其深远:用户不再做「选择」,而是直接「采信」。
在货架时代,用户必须自己从十个链接里挑一个;而在对话框时代,AI 替用户做了筛选,用户拿到的是「结论」。用户不需要也不愿意再去验证,因为 AI 给的答案看起来已经足够完整、足够可信。
所以:
品牌要么在 AI 的答案里,要么就不存在。没有第二页。
0.1.3 一个关键的认知转折:迭代层级也变了
很多人以为,这只是「从搜索结果页换到了 AI 对话框」的界面变化,本质还是「争取被展示」。但这里藏着一个更微妙的转折——攒数据拼流量的旧打法的前提,正在被抽走。
传统 SEO 有效,前提是「大量同质化内容能被同时展示、我们以量取胜」。但当用户直接问 AI 时,AI 只会给出少数几个答案,而且它是从大量信源里筛选出的一个综合判断。这意味着:
- 你的内容不是和「你排第几名」竞争,而是和「AI 最终信不信你、讲不讲你」竞争;
- 同质化的铺量内容不再有优势,因为 AI 会去重、会只抽优质信源;
- 你面对的对象从「搜索引擎的算法」变成了「能对话、能推理、会持续追问的智能体」。
这已经不是一场界面升级,而是一场决策机制的变化。谁先看清楚这一点,谁就能在下一轮竞争中占得先机。
0.2 关键数据:入口已经变了
0.2.1 三个硬数据,不是感觉而是事实
「AI 正在成为第一决策入口」不是某个人的判断,而是可以被量化的事实。请看下面的数据(均来自对本课程相关真实实测与研究的一手汇总,口径见 0.4 方法论):
| 数据 | 含义 | 它说明什么 |
|---|---|---|
| 83% 的用户已用 AI 了解消费品 | 咨询、比较、甚至下单前,AI 已是第一站 | 「AI 决策入门」已经过半,不再是早期采用者的小众行为 |
| 传统搜索满意度约 3.62 | 用户对传统搜索结果的体验评分 | 传统体验已经相对见顶、内卷 |
| AI 搜索满意度约 3.95 | 用户对 AI 生成的答案更满意 | AI 已经实质追平并反超,成为体验更好的一方 |
这里要特别注意第二、第三条之间的关系:满意度高,就会形成正向反馈循环。用户觉得 AI 好用 → 用得更频繁 → AI 收集到更多行为数据 → 答案更贴合 → 用户更依赖。一旦这条循环转起来,就不会倒退。3.62 与 3.95 的微小差距,意味着反馈循环的临界点已经跨过。
0.2.2 零点击与前流量时代:分流正在发生
还有一个「温水煮青蛙」式的数据值得警惕——零点击搜索(zero-click)。它指越来越频繁出现的一种现象:用户发问后,答案直接显示在结果页里,用户根本没有点击进任何网站,流量就这样凭空蒸发,根本没到你的页面。
与之相伴的是一系列「分流」趋势:
| 趋势 | 表现 | 对品牌的影响 |
|---|---|---|
| 零点击 | 用户满意于答案本身,不再点进页面 | 直接威胁依赖站内流量的商业模式 |
| AI 概览 / AI 模式 | 引擎把一段 AI 生成的摘要放在常规结果上方 | 常规结果的点击被明显挤占 |
| 可引用优先 | AI 只抽按它标准「优质」的少数信源 | 未被抽中的站点连「露脸」机会都没有 |
| 答而不点 | 用户信任对话结论,把后续行动交给 AI 或 Agent | 传统「点进来看」的漏斗模型不再成立 |
这意味着,如果你还只盯着「站内点击量」,你会看到自己的流量在缓慢流失,却说不清它去哪了——其实它没有消失,只是换了一条不被你的分析工具记录的路。这正是 GEO 要补上的一块拼图:让品牌在「没被点击」的那条路上,仍然被提到。
0.2.3 下一步:Agent 时代,连「选」都交给机器
如果说 AI 对话是「人机对话辅助决策」,那么再往前走一步,就是 Agent(智能体)时代:连用户自己动手发问、对比答案、做决定的环节,都有可能被机器接管。
设想这样的场景:
未来一个即将开始做营销的企业主,对系统说:「帮我选一套 CRM 并配置好。」一个 Agent 自行检索、比较、甚至直接调用服务,替主人下单——全程没有人工点开任何一份官网。
在这个场景里,「被品牌官网吸引过去点击」的传统路径几乎靠不住,真正决定胜负的是Agent 在检索时会采信谁的判断、信任谁的信息、把谁列入候选。所以面向 Agent 优化,是传统营销人在可预见的未来必须面对的新考题。整本教材中,我们会在专家级的章节里专门展开「Agent 就绪度」这个课题。
0.2.4 数据提醒:AI 采纳在升,信任却在降
最后补一个反直觉但很重要的事实:AI 的使用在全面上升,但用户对 AI 内容的信任,反而开始下降。
这听起来矛盾,其实恰恰透露了趋势:AI 生成的答案鱼龙混杂、真假难辨,用户既离不开 AI,又开始怀疑 AI。这就给品牌留下了一个巨大的机会——谁能成为 AI 答案里「可信、可验证、来源扎实」的那个来源,谁就能在信任下滑中吃到「信任红利」。这,正是 GEO 方法论中「信任」这个维度的出发点。
0.3 我们要学的东西叫 GEO
0.3.1 GEO 的定义
先把术语定义写清楚(本章只给足定义,更深入的机制与「被引用 / 被信任」跃迁,详见第 6 章更深入展开)。
GEO(Generative Engine Optimization,生成式引擎优化):研究并让 AI 对话/内容引擎在产品介绍阶段引用你、推荐你、替你说好话,从而提升品牌在 AI 答案中的可见度、可信度与交通。
拆开看,这个定义里有三个动词,分别是三个递进的层次:
| 层次 | 动词 | 你的品牌被 AI 做成什么 | 对应目的 |
|---|---|---|---|
| 第一层 | 引用你 | 在 AI 答案里作为信息来源被点名 | 被看见 |
| 第二层 | 推荐你 | 在被比较、被推荐时排进候选 | 被选到 |
| 第三层 | 替你说好话 | 以正面、专业的方式描述你 | 被信任 |
而「产品介绍阶段」这几个字很重要:GEO 关心的是当用户或 Agent 在了解、比较、决策你的产品时,AI 说的是不是你。这是一个比「搜索结果排名」更前置、也更接近成交的动作入口。
0.3.2 核心认知升级:从「被找到」到「被信到」
理解 GEO 的关键,是一次思维方式上的升级。把它说透,胜过记一堆技巧:
| 对比维度 | 传统 SEO 的思维 | GEO 的思维 |
|---|---|---|
| 核心对象 | 排名 / 曝光量 | 引用 / 推荐 / 信任 |
| 成功标志 | 排进搜索结果前列 | 被 AI 说出来、点出来、信到 |
| 用户行为 | 用户的「点击」 | 用户的「采信」 |
| 竞争对手 | 其他排名的网页 | 其他被 AI 认可的信源 |
| 最优结果 | 用户点进你的站 | 用户听完「你很靠谱」就做了决定 |
传统 SEO 聊的是「货架位置」,GEO 聊的是「推荐权重」。过去你抢的是货架上的格子,现在你要的是导购员嘴里的话。两句话便能点破整个区别:
SEO 是抢货架,GEO 是搞定导购员。
再补一层:在货架时代,即便你没排第一,用户还是可能翻到第三、第四页找到你;但在 AI 时代,AI 往往只给三五个答案,没被说到的品牌,就等于在这个用户眼前完全不存在。这种「零和到近乎彻底」的局面,就是为什么 GEO 值得专门学习。
0.3.3 一个正反例,一眼看懂 GEO 为什么重要
对比两个同行业的品牌,在 AI 眼中的差别:
品牌甲(没有做 GEO):
用户问「什么 CRM 好用」,AI 回答:「当前市面上没有一款产品能同时满足所有需求,推荐先去官网对比主要 SaaS 服务商的报价……」——连品牌甲的名字都没有出现。
品牌乙(做了 GEO):
用户问「什么 CRM 好用」,AI 回答:「对 20 人团队而言,品牌乙以 X 元/人/月的性价比和内置自动化著称,且公开的客户评价多为正面,综合推荐品牌乙。」
同样是「问了同一个问题」,品牌甲在用户眼里根本不存在,品牌乙则直接成了「被推荐的首选」。差距不在产品本身,而在 AI 说了谁的什么话。这正是一个典型 GEO 效果差异的缩影。
0.4 方法论:数据驱动,而非纸面
0.4.1 我们的立场:一切的结论都要吃得住复验
学 GEO,最怕的一件事就是「人云亦云」。市面上关于「哪个 AI 引擎偏爱什么信源」「哪种写法更容易被引用」的说法很多,但很多是单次、偶然、玄学的观察。如果把这类观察当真,你的优化方向很容易跑偏,花了钱却不见效。
所以本课程给自己立了一条铁纪律:站在真实测量之上,而非纸面推演之上。
所谓「真实测量」,指的是我们会主动去问 AI、去采样、去对照,用真实返回的答案反推动作的依据,而不是凭感觉写建议。整套教材中最核心的一套实验,是固定的对照设计:
固定题目 × 固定引擎 × 多次采样——用同一批问题(12 题 × 8 引擎),配合多轮采样(累计 117 条),在同一条件下反复验证,结论才敢写进教材。
0.4.2 n=1 与多次采样:两种证据,力度不同
在阅读全书的数值与结论时,你要学会分辨两种证据的「分量」(采样口径的标准方法与监测体系,详见第 8 章):
| 证据类型 | 定义 | 力度 | 用途 |
|---|---|---|---|
| n=1 单次测试 | 只做一次、只问一次就得到的观察 | 弱——只当方向性信号 | 快速判断「这事有没有戏」,用于低成本试探 |
| 多次采样 | 固定设计下反复做多轮(如 117 条),取统计口径 | 强——可推导普遍结论 | 验证真伪、量出稳定偏好、修正刻板印象 |
规矩也简单:
- 一个结论若来自单次提问,就只当它是「开了个方向」,别急着投入重资源;
- 一个结论若来自固定设计的多次采样,才敢作为可持续执行的依据写进策略。
0.4.3 警惕「一家之言」:问自己三个问题
我们还想教给你一套「怀疑的姿势」。以后无论谁(包括这本书)给你一个 GEO 断言,你都先在心里过三关:
| 问题 | 你应该得到的答案 |
|---|---|
| 这是 n=1 的方向信号,还是多次采样的统计口径? | 必须分清楚,别把偶然当规律 |
| 这个引擎的结论,换一个引擎还成立吗? | AI 决策会随引擎而变,需跨引擎校验 |
| 这是可复验的机制,还是一时的风口说法? | 机制才能迁移,风口会过期 |
⚠️ 记住:任何 GEO 断言都要问——这是 n=1 的方向信号,还是多次采样的统计口径? 带着这个标准去读全书的每一张表,你会少走非常多的弯路。
0.4.4 结论会过期,但它有「可迁移机制」
最后提醒一句:AI 的答案不是一成不变的,引擎改版、模型换代都会让「某引擎更爱引什么」的细节发生漂移。所以,本书虽然给你大量具体结论,但更希望你带走的是可迁移的机制——理解 AI「为什么要引用你、凭什么信任你」,比记住「某某引擎此刻偏向什么」更有长期价值。机制在,无论引擎怎么换代,你都能自己重新推演出一套当前最优动作。
0.5 术语与概念总览:SEO → LSO → VSO → AEO → GEO
0.5.1 五个缩写,一张表一次理清
在展开全书之前,先把最常出现的五个缩写讲明白。它们不是五个彼此无关的工种,而是一脉相承的演进主线:
| 缩写 | 全称 | 核心含义 | 一句话 |
|---|---|---|---|
| SEO | Search Engine Optimization(搜索引擎优化) | 传统搜索排名优化 | 抢货架(被找到) |
| LSO | Local SEO(本地搜索优化) | 本地化后在地图上挂对招牌 | 在数字商圈挂对招牌 |
| VSO | Video SEO(视频搜索优化) | 让视频内容也能被检索到 | 把答案翻译成视频可读 |
| AEO | Answer Engine Optimization(答案引擎优化) | 让机器「找得到」你的答案 | 教机器「找」答案 |
| GEO | Generative Engine Optimization(生成式引擎优化) | 让机器「信你的答案并替你说」 | 教机器「信」答案 |
主章锚点:这五个缩写的完整机制,分别在各自主章展开——SEO→第 1 章、LSO→第 3 章、VSO→第 4 章、AEO→第 5 章、GEO→第 6 章(GEO 本章 §0.3 已给定义,更深入的「被引用 / 被信任」跃迁见第 6 章)。
0.5.2 这五个词其实是一条演进主线
千万不要把这五个词记成「五个考点」,它们其实是同一条大河的五个阶段,讲的是优化对象的一步步升级:
- SEO(抢货架):想的是「怎么让页面排到搜索结果靠前」,目标是被用户找到;
- LSO(挂招牌):搜索开始带本地属性之后,回答的是「我这个店在这片数字商圈里招牌挂没挂对」,目标是本地用户找到我、找对人;
- VSO(翻成视频):内容形态多样化之后,视频也成为检索对象,目标是把「本来是人看的答案」翻译成「机器也能读的视频结构」;
- AEO(教机器找):当检索越来越像「问答」而非「翻列表」,重点变成「我给出的内容要能被机器精准提取成一段直接答案」,目标是回答「答案在哪」;
- GEO(教机器信):再进一步,当机器不仅能找到答案、还能组织成一段让你直接采信的结论时,重点就成了「你的品牌要成为机器愿意采信并主动推荐的那个来源」,目标是回答「信谁的」与「替谁说话」。
一句话串联这条主线:
从「被找到」→「被本地找到」→「被视频形式找到」→「被改成直接答案」→「被当成可信来源而推荐」——每一步都是人类消费决策方式往前推进一步的投影。
0.5.3 一个重要澄清:GEO 不是推倒重来
在这条主线里,有人会误以为 GEO 是「把 SEO 扔掉、另起炉灶」。这是一个必须纠正的误解。实际上,SEO 为 GEO 提供了大量地基:
| 地基能力 | 怎么过渡到 GEO |
|---|---|
| 内容结构 / 可读性 | 结构良好、信息密度高的内容,同样更利于被 AI 提取 |
| 技术可抓取 | 让爬虫访问、正确渲染的页面,才可能成为 AI 信源 |
| 权威 / 信任积累 | 线上信誉、正面共识,是 AI「信你」的重要参考 |
| 品牌身份清晰 | AI 需要「搞清你是谁」,这离不开稳定的品牌身份信号 |
所以本书的路线不是「跨过 SEO 直接学 GEO」,而是脚踩 SEO 的地基,一路学上来。第一章专门讲 SEO 地基,正是这个考虑——不懂货架,就谈不上真正懂导购员。
0.5.4 本教材的章节主线
把上面的演进主线落到本书的目录,就是下面这 16 章 + 附录的骨架(每章的起点对应该阶段的优化对象):
| 章 | 主题 | 对应主线 |
|---|---|---|
| 第 1 章 | SEO 地基 | 货架 |
| 第 2 章 | 国际化与搜索算法机制 | 搜索机制的底层逻辑 |
| 第 3 章 | LSO | 本地招牌 |
| 第 4 章 | VSO | 视频可读 |
| 第 5 章 | AEO | 教机器找答案 |
| 第 6 章 | GEO | 教机器信答案 |
| 第 8 章 | 实测方法论 | 怎么用数据下判断 |
| 第 9 章 | 信源与分发 | 让 AI 抽得到你(一稿多发 / 生态绑定看第 9 章) |
| 第 10 章 | 从业者赛道 | 分行业落地(从业者) |
| 第 11 章 | 教育赛道 | 分行业落地(教育) |
| 第 12 章 | 房地产与汽车赛道 | 分行业落地(房产 / 汽车) |
| 第 13 章 | GEO 工作流五步 | 从 0 跑通一个 GEO 闭环 |
| 第 14 章 | 从 GEO 到 Agent 时代 | 面向未来的智能体曝光 |
| 第 15 章 | DSH 系统插件开发 | 用插件扩展系统自身能力 |
| 第 16 章 | Vibe Coding 改进系统能力 | 用 AI 辅助编码改造系统 |
| 第 7 章 | 官网 AI 技术准入 | 技术准入门(先过门,再谈内容) |
| 附录 | 术语 / 案例速查 | 随手查阅 |
现在你心里已经有一张完整的「地图」了——接下来只需要决定:你走哪条路来学它?
第 0 部分 · 五级学习路径(先读这一章)
路径总览
本教材按学习者角色/目标给出五条并列的学习路径。它们不是本科生到研究生那种「必须逐级读」的关系,而是按你的目标选一条主路;同时五条路径又通过「解锁」衔接,与平台学习中心的正式考试门控保持一致。
| 路径 | 星级 | 层级 | 一句话目标 | 主线章节 | 考核 | 证书解锁 |
|---|---|---|---|---|---|---|
| A | 一星级 | 入门级 G1 | 纯了解背景、会用系统 | 第 1、6 章的概念部分 | 入门级试卷(8 客观题 ≥ 80 分) | 基础级 |
| B | 二星级 | 基础级 G2 | 吃透技术基础 | 第 1–3、5、7 章技术部分 | 基础级试卷(9 客观题 ≥ 75 分) | 进阶级 |
| C | 三星级 | 进阶级 G3 | 做对单点、跑通一个动作 | 第 4、8、9 章 + 第 1–9 章的执行小节 | 进阶级试卷(8 客观 + 2 简答,均分 ≥ 70) | 高阶级 |
| D | 四星级 | 高阶级 G4 | 串成体系、按行业出全案 | 第 10–13 章 + 各章方法清单 | 高阶级试卷(8 客观 + 3 简答,均分 ≥ 70) | 专家级 |
| E | 五星级 | 专家级 G5 | 操盘全案、改造系统自身 | 第 14–16 章 + 附录 | 专家级试卷(4 客观 + 2 简答 + 1 方案,走人机环审题) | —(能力产出) |
星级是这一套课的进度语言:一星到五星与 G1–G5 一一对应,互动课堂首页的五级阶梯、 以及学习中心
GET /api/v1/learning/levels返回的star字段用的就是这张表 (真源:src/zdgeo/services/learning_catalog.py的LEARNING_LEVELS,有测试钉住对应关系)。 与第 3 章(LSO)和附录里作为红线案例的「五星好评 / 十条五星刷量」毫无关系, 那两个"星"不是同一个东西,别串味。
五条路径如何衔接:完成 A 的考试并达标,即「解锁」路径 B;完成 B 再解锁路径 C,依此类推直到 E。这与学习中心的正式门控一致,避免「跳级却不稳」的情况。
口径说明(重要):上表的题量与及格线以平台「学习中心」的正式门控为准,本教材只作解读。若教材与学习中心出现差异,一律以平台学习中心为准——入门级 8 道客观题 / 及格 80 分;基础级 9 道客观题 / 及格 75 分;进阶级 8 客观 + 2 简答 / 均分 70 分;高阶级 8 客观 + 3 简答 / 均分 70 分;专家级 4 客观 + 2 简答 + 1 方案。
路径 A · 入门级 G1 ——「纯了解背景、会使用系统」
适合谁:市场 / 内容新手、非技术运营、第一次接触 GEO 的管理者。完全不碰技术。
读完你将能: - 用「排名 / 引用 / 信任」三层讲清 GEO 的价值; - 认识主流 AI 引擎与「五 x O」术语,能看明白行业文章在说什么; - 在平台里做一次标准版诊断、看懂报告:看看 AI 提到我了吗?又怎么提到我?
怎么走完这条路径: 1. 读前言 + 第 1、6 章的概念部分(顺序:SEO 地基 → GEO 核心概念); 2. 在平台做一次标准版诊断,并查看生成的《品牌 AI 曝光快照》报告; 3. 过一遍平台学习中心里的全部「节级自测」; 4. 参加入门级考试(8 道客观题,≥ 80 分)→ 获证,解锁路径 B。
产出物:《品牌 AI 曝光快照》——这是你入门的第一个、也是最有成就感的实操成果。
路径 B · 基础级 G2 ——「吃透技术基础」
适合谁:想真正上手做 GEO 的非技术运营、需要与建站/研发沟通的人、以及准备进入执行层的学习者(需先完成路径 A)。
读完你将能: - 说出抓取 / 索引 / 排名的机制,知道「进不了索引 = 不在候选池」; - 掌握可被抓取、NAP、hreflang、AEO 结构化、问法研究等可直接落地的技术基础; - 会用一条技术命令验证「自己网站的页面 AI 到底能不能抓取到」,并读懂技术指标。
怎么走完这条路径: 1. 读第 1–3、5、7 章的技术部分(抓取索引机制、LSO 本地、AEO 结构化、问法研究、官网 AI 技术准入); 2. 依次做完技术五关 / NAP / 问法面单的标准检查,跑通一次; 3. 参加基础级考试(9 道客观题,≥ 75 分)→ 获证,解锁路径 C。
产出物:一份可复跑的「技术自检」结果 + 你的问法面单——从此技术不再是黑盒。
路径 C · 进阶级 G3 ——「做对单点、跑通一个动作」
适合谁:负责内容生产、单渠道优化、实测采样的执行者(需先完成路径 B)。
读完你将能: - 掌握实测方法论的采样口径(n=1 当方向、多次采样当口径),能自己设计一次对照实测; - 把一稿多发、信源决策树跑成动作,让内容被 AI 更稳地「抽到」; - 会用采集 / 回测手段比较内容效果,知道 AI 有没有变得「更常提你」。
怎么走完这条路径:
1. 读第 4、8、9 章 + 第 1–9 章的执行类小节(VSO 视频 → 实测方法论 → 信源与分发);
2. 选 1 个具体主题做一整轮实操:Query 研究 → 信源 → 内容 → 分发 → 首轮回测;
3. 用这套流程产出一轮完整的 GEO 小样,并记录下初始的引用率基线;
4. 参加进阶级考试(8 客观 + 2 简答,均分 ≥ 70)→ 获证,解锁路径 D。
产出物:一个可复跑的重内容样品 + 一套自己的「引用率基线」数据——从此你不再是纸上谈兵。
路径 D · 高阶级 G4 ——「串成体系、按行业出全案」
适合谁:带团队的内容负责人、分行业操盘的执行主管(需先完成路径 C)。
读完你将能: - 把前面散落的动作串成两周一轮的完整工作流(Query 研究 → 信源选择 → 内容生产 → 分发矩阵 → 监测迭代); - 针对自己所在行业(从业者 / 教育 / 房地产 / 汽车 / B2B 长链条)定制内容布点方案; - 用「内容四条硬指标」与「三条红线」把团队产出卡在标准之上。
怎么走完这条路径: 1. 读第 10–13 章 + 各章方法清单(从业者赛道 → 教育赛道 → 房地产与汽车赛道 → GEO 工作流五步); 2. 独立跑通一轮两周闭环,产出可复跑的 SOP; 3. 参加高阶级考试(8 客观 + 3 简答,均分 ≥ 70)→ 获证,解锁路径 E。
产出物:一份能交给团队直接执行的行业级 SOP + 一轮完整闭环记录。
路径 E · 专家级 G5 ——「操盘全案、改造系统自身」
适合谁:SEO/GEO 负责人、代运营操盘手、立志走上 AI 原生岗位的从业者(需先完成路径 D)。
读完你将能: - 规划并复盘一个完整的 GEO 项目(从诊断到回测); - 构建起品牌的「实体护城河」(详见第 14 章),让 AI 稳定、正面地认识你; - 面向 AI Agent 时代,输出一套可落地的改造方案; - 用插件与 AI 辅助编码改造系统自身能力(详见第 15、16 章); - 把 GEO 的投入与回报,向非技术的决策者讲成一个能算清 ROI 的故事。
怎么走完这条路径:
1. 读第 14–16 章 + 全部附录(从 GEO 到 Agent 时代 → DSH 系统插件开发 → Vibe Coding 改进系统能力 → 术语/案例速查);
2. 独立完成一个「客户全案 GEO 提案」:诊断 → 策略 → 执行 → 监测 → ROI 汇报,产出一份 8–12 页的提案;
3. 为系统开发一个可用的能力插件(第 15 章)或完成一次系统能力改进(第 16 章);
4. 参加专家级考试(含 1 道方案题,走人机环共同审题)→ 获专家级证书 + 提案评审。
产出物:一份能被真实客户拿去执行的 8–12 页全案提案 + 一个系统能力扩展——这是从「执行者」到「操盘手」再到「造轮子的人」的身份跃迁。
路径建议:新手选 A → 想做技术选 B → 执行者选 C → 带团队者选 D → 操盘手/造轮子选 E。直接跳到专家级不是不行,但因为缺了前置与方法论,容易「学不稳、落地难」。因此本书的路径与学习中心门控严格一致——先解锁,再进阶。
使用指南
这一部分帮你把整本教材「用顺」,读一遍之后再进第一章。
章节结构约定
每章统一采用同一套内部结构,读到哪都知道自己在哪一步:
学习目标 → 核心知识点 → 实测数据 → 参考案例 → 方法清单 → 避坑提醒 → 思考与练习
各块作用一句话说清:
| 结构块 | 它解决什么 |
|---|---|
| 学习目标 | 告诉你这一章学完该会什么,先立靶子 |
| 核心知识点 | 章的正题,把机制讲透 |
| 实测数据 | 用真实测量说话,喂给你可信结论 |
| 参考案例 | 用一个具体例子把抽象讲落实 |
| 方法清单 | 可马上照做的动作步骤 |
| 避坑提醒 | 把别人踩过的坑直接标出来 |
| 思考与练习 | 检测掌握度,按 🔵 入门 / 🟢 基础 / 🟡 进阶 / 🟠 高阶 / 🔴 专家 分级 |
级别标注约定(全教材通用)
为了方便你按自己的路径「挑着读」,教材给每个子节都标了难度徽标:
| 徽标 | 级别 | 对应路径 | 建议读者 |
|---|---|---|---|
| 🔵 入门 | 背景层(纯认知 + 使用系统) | 路径 A | 人人都该读懂,不碰技术 |
| 🟢 基础 | 技术基础层 | 路径 B | 想亲手做 GEO 者精读 |
| 🟡 进阶 | 单点执行层 | 路径 C | 做单点优化者精读 |
| 🟠 高阶 | 体系全案层 | 路径 D | 带团队 / 分行业操盘者精读 |
| 🔴 专家 | 操作与演进层 | 路径 E | 操盘手与负责人精读 |
| 🔵 → 🟠 / 🟠 → 🔴 | 跨级进阶 | 按路径取用 | 一节横跨两层,按自己的路径取用 |
另外,每章章首都配一张「子节 × 级别」的映射表,与第 0 部分路径呼应。你读到某小节时,先看它的徽标,再对照自己的路径决定精读还是略读,可以把效率提到最高。
⚠️ 别混淆两套 A–E 字母:本节的「路径 A / B / C / D / E」指学习路径(入门级 / 基础级 / 进阶级 / 高阶级 / 专家级);第 1 章 §1.6.5 的关键词「分档表 A / B / C / D」指问法优先级分档(必做 / 应做 / 可做 / 跳过),与学习路径无关。两套字母长得一样,含义完全不同——认中文名,不要只认字母。
配套系统怎么用
这本书不是孤立的。它与平台的学习中心一一对应:
| 配套能力 | 用途 | 建议用法 |
|---|---|---|
| 节级自测 | 每节末尾的小测验 | 逐题自查,巩固每节 |
| 正式考试 | 五级门控考试 | 验证阶段掌握,解锁下一路径 |
| 人机环 | 结合 AI 与人工共同评价 | 专家级简答/方案题用它审 |
| 🧭 新手走查沙盘 | 一套预置好的示例品牌(只读),15 分钟走完「诊断 → 洞察 → 规划 → 生产 → 发布 → 复盘」六站 | 先走查、再读书:先看一眼真实界面长什么样,回头读正文时每一节都能对上号 |
建议的做法是:读完一章 → 做节级自测 → 攒了几章后参加正式考试,用小步快跑的方式验证「我真的学会了」,而不是一口气读完整本。
先动手再看书:如果你连系统长什么样都还没见过,先去 新手走查沙盘(示例项目 · 只读) 走一遍—— 它用一个虚构的示例品牌把六个站点全部填满,不花积分、不写数据,走完还能导出一份《品牌 AI 曝光快照》当格式样板。 卷一的每一章末都写着「系统走查点」,告诉你这一章对应沙盘里的哪一站。
每章怎么读最高效
同样一章,不同读者读法完全不同。这里给你三种目标各异的读法,配合你的时间预算选一种:
| 读法 | 适合谁 | 怎么做 | 预期收获 |
|---|---|---|---|
| 通读法 | 第一次读、想建立整体认知 | 顺着「学习目标 → 核心知识点 → 参考案例」一路往下读到底 | 快速看懂机制与来龙去脉,不被细节卡住 |
| 跳读法 | 已经入门、只补某个痛点 | 先看该章「子节 × 级别」映射表,只精读带自己路径徽标的小节 | 用时最少、直击要害 |
| 回查法 | 落地执行、当工具书用 | 用到什么查什么,配合正文「方法清单」和附录 B 的检查单 | 即查即用、边做边对 |
建议的组合:「第一遍通读」建立地图 → 「第二遍起跳读」加深理解 → 「执行阶段转回查」边做边验证。三种读法互相切换,是这套教材最高效的打开方式。
一次学多少章合适
别贪多。结合节级自测的设计,推荐「读一章、测一节」的小步快跑节奏:
- 单次学习建议 60–90 分钟,内容量为「1 节正文 + 对应节级自测 + 回答节末的每个思考题」;
- 阶段自检:每读完 2–3 章,回到第 0 部分的路径总览,逐条核对「读完你将能」清单里你现在能做到的项;
- 考试解锁:攒齐该路径的整批章节后,再参加对应层级的正式考试——用小步快跑验证「真会了」,而不是读完再发现没学会。
各章平均用时参考(因你的背景而异,仅作排期参考):
⚠️ 先看这条,别被「一两小时一章」骗了:教材素材库版正文(前言 + 16 章)实测 61.8 万字,按精读 1.5 万字/小时估算,通读一遍约 41 小时。新手请直接读 卷一 · 入门读本(
readers/卷一-入门读本.md),它把每章压到约 7,000 字。
| 读本 | 平均用时 | 说明 |
|---|---|---|
| 卷一 · 入门读本 | 约 3 小时通读 + 6 周「每天 25 分钟做动作」 | 每章约 7,000 字,只留结论、动作与判定标准 |
| 素材库正文(前言 + 16 章,含深讲) | 约 41 小时 | 共 61.8 万字:厚章 3.2–4.9 万、骨架章 0.6–0.9 万,按需检索,不要求通读 |
| 附录 | 按需翻阅 | 不要求通读,用途是「查」而非「读」 |
| 一轮完整实操 | 约 1–2 周 | Query → 内容 → 分发 → 回测的完整闭环 |
遇到不懂的章节怎么办
每个人都会在某章卡住,这很正常。处理原则是「先走通,再走深」:
- 卡在概念 → 回看 0.5 的术语总览,把陌生缩写放进演进主线里再看一遍;
- 卡在操作 → 先照文方法清单抄一遍,跑通一次,再回来理解为什么这样做;
- 卡在专家级小节 → 它是给操盘手看的,先标记「带我进阶再来读」,回到主线继续;
- 实在读不下去 → 跳到「参考案例」和附录 B,用例子反推动作,再回头补机制。
记住:教材是地图,地图允许你先到几个关键地标,再慢慢把路补齐。别为了一小段没读懂,就把整趟路停下来。
读者最常问的六个问题
- 「我没有技术背景,学得动吗?」 可以。路径 A 完全不碰代码,用「排名 / 引用 / 信任」三层和平台的标准版诊断就能走完;技术细节分布在路径 B(技术基础)、C(执行)的特定小节,等需要时再学即可。
- 「我已经懂 SEO,还需要学吗?」 需要,但不是从头学。GEO 建立在 SEO 地基上,你已有的内容结构、权威积累、技术抓取能力大多能直接沿用,只需补上「让 AI 信你并替你说话」这新的一段。
- 「结论会变,学了是不是很快就过时?」 变的是具体偏好,不变的是机制。教材希望你能带走「AI 为什么引用你、凭什么信任你」的机制,引擎换代后你能自己重推当前最优动作。
- 「直接看专家级可以吗?」 可以读,但不推荐作为第一条路线。缺了前置方法论,专家级会「学起来累、落地不稳」,这也是学习中心把它设成逐级解锁的原因。
- 「正文和附录怎么分工?」 正文负责「讲透机制」,附录负责「随手可查」。读正文遇到名词回附录 A,要动手时对着附录 B,做了练习没把握查附录 C。
- 「学完能马上看到效果吗?」 首次落地往往要一到两周的完整一轮(Query → 内容 → 分发 → 回测)才有基线,之后随着内容累积形成复利。别期待一次提问就翻天。
六条回答都不用背,它们只服务于同一个提醒:这套教材的学习是「机制 + 练习」,不是「模板 + 背诵」。记住这条,几乎所有关于「怎么学」的摇摆都会解开。
章节导航总索引
为了方便你「按路径挑着读」,下面把全书 16 章与附录的要点、主体级别和内部构成列成一张导航表。每章的主体层级徽标代表读完它所解决的主体层级;列内的要点标出小节各自级别,方便你精确跳读。
| 章 | 主题 | 主体层级 | 章节要点与级别构成 |
|---|---|---|---|
| 第 1 章 | SEO 地基 | 🟢 | 技术五关(🟢)、内容资产观(🔵)、索引与排名机制(🟢)、优先级排序(🟡) |
| 第 2 章 | 国际化与搜索算法机制 | 🟢 | 多语言与实体一致(🟡)、hreflang 与本地化(🟡)、算法训练管线(🟡)、算法信号与 YMYL(🟢)、方法清单(🟠) |
| 第 3 章 | LSO 本地 | 🟢 | 本地为什么是前哨(🟢)、四盘面与 NAP(🟡)、评价运营(🟡)、本地 AI 新机制(🟠) |
| 第 4 章 | VSO 视频 | 🟡 | 视频结构化(🟡)、语音长尾(🟡)、答案专辑(🟡)、how-to 兜底(🟡) |
| 第 5 章 | AEO 答案引擎 | 🟢 | 位置零与 FAQ(🟢)、结构化问答(🟢)、可抽取块(🟡)、问题面单(🟢) |
| 第 6 章 | GEO 核心 | 🔵 | 引用/推荐/信任三层(🔵)、默认答案(🟡)、生态绑定(🟡)、窗口期(🟠) |
| 第 8 章 | 实测方法论 | 🟡 | n=1 与多次采样(🟡)、对照设计(🟡)、风控与限速(🟡)、变化看板(🟠) |
| 第 9 章 | 信源与分发 | 🟡 | 生态绑定定律(🟡)、三个意外信源(🟡)、一稿多发改写矩阵(🟡)、信源决策树(🟡) |
| 第 10 章 | 从业者赛道 | 🟠 | 三类黄金问题(🟠)、榜单是铺出来的(🟠)、工具方三件套(🟠)、B2B 长链条(🟠) |
| 第 11 章 | 教育赛道 | 🟠 | 负面词占位(🟠)、分人群算账(🟠)、先测引用再投入(🟠)、健康税模板(🟠) |
| 第 12 章 | 房地产与汽车赛道 | 🟠 | 五类意图层(🟢)、Query Fan-out(🟠)、汽车五维意图(🟠)、身份模拟 660 网格(🟠)、承销 vs 中介(🟠) |
| 第 13 章 | GEO 工作流五步 | 🟠 | 五步流程(Query 研究→信源选择→内容生产→分发矩阵→监测迭代)(🟠)、内容四条硬指标(🟠)、三条红线(🟠)、两周首轮闭环(🟠) |
| 第 14 章 | 从 GEO 到 Agent 时代 | 🔴 | 数据基建三层(🔴)、机器可读信任层(🔴)、Agent 就绪度(🔴)、实时可刷新(🟠) |
| 第 15 章 | DSH 系统插件开发 | 🔴 | 插件体系总览(🔴)、技能插件契约(🔴)、角色与 Recipe 装配(🔴)、前端能力插件组(🟠)、白名单与审计边界(🔴) |
| 第 16 章 | Vibe Coding 改进系统能力 | 🔴 | 从需求到插件的对话式开发(🔴)、上下文与边界管理(🔴)、校验与回归(🟠)、把改进沉淀成能力(🔴) |
| 第 7 章 | 官网 AI 技术准入 | 🟢 | 门先于内容(🔵)、逐爬虫 robots 三层判定(🟢)、身份差分与对照组(🟡)、摘录权限与静态可读(🟡/🟢)、体检方法清单(🟠) |
| 附录 | 速查配套 | 🔵 | 术语表 / 案例速查 / 参考答案 / 实操挂钩(🔵) |
读法:只想快速建立认知、会使用系统,优先读 🔵 章;想吃透技术基础,精读 🟢 章;做单点优化,补 🟡 章;带团队、分行业操盘,精读 🟠 章;做全案操盘与系统演进,精读 🔴 章。注意徽标不代表「难不难」,它描述的是「这一章主要解决哪一层的问题」——入门读者读到 🟢/🟡/🟠/🔴 小节可以暂时略读,等进阶再回来。
五级路径进阶检查表
读完五部曲不等于「通过」。下面把五条路径分别拆成「阶段 → 关键动作 → 自检问题」,考试前逐项核对,能做到的项越多,通过越稳。
路径 A · 入门级 G1 进阶检查表
| 阶段 | 关键动作 | 自检:「做到才算过」 |
|---|---|---|
| 认知建立 | 读完前言 + 第 1、6 章的概念部分 | 能否一句话讲清「为什么此刻必须学 GEO」?能否认出 SEO / LSO / VSO / AEO / GEO 五个缩写? |
| 使用系统 | 在平台跑一次标准版诊断,看《品牌 AI 曝光快照》 | 是否能独立操作并说清报告里「提到/没提到我、怎么提到的」? |
| 自测巩固 | 过一遍全部节级自测 | 明显答错的题,是否已回看对应正文小节? |
| 考试取证 | 参加入门级考试(8 客观题) | 客观题是否 ≥ 80 分?取证后是否已解锁路径 B? |
路径 B · 基础级 G2 进阶检查表
| 阶段 | 关键动作 | 自检:「做到才算过」 |
|---|---|---|
| 技术吸收 | 读完第 1–3、5、7 章技术部分 | 能否说清「抓取 / 索引 / 排名」关系?能否解释 NAP、hreflang、AEO 结构化各在解决什么? |
| 技术验证 | 用一条技术命令查「页面是否可被抓取」、过一遍技术五关 / 问法面单 | 是否确认自己的页面能抓到、能进索引,并产出了问法面单? |
| 考试取证 | 参加基础级考试(9 客观题,≥ 75 分) | 客观是否达标?取证后是否已解锁路径 C? |
路径 C · 进阶级 G3 进阶检查表
| 阶段 | 关键动作 | 自检:「做到才算过」 |
|---|---|---|
| 方法论吸收 | 读完第 4、8、9 章 + 执行类小节 | 能否说清 n=1 与多次采样的区别?能否分辨「方向信号」与「统计口径」? |
| 一轮实操 | 走完 Query → 信源 → 内容 → 分发 → 首轮回测 | 是否产出可复跑的重内容样品?是否记录了初始引用率基线? |
| 监测搭建 | 用固定问题集搭引用监测 | 是否搭出变化看板、能看出「这段期间有没有趋势」? |
| 考试取证 | 参加进阶级考试(8 客观 + 2 简答,均分 ≥ 70) | 客观是否达标?简答是否经 AI 预评 + 人工审?取证后解锁 D? |
路径 D · 高阶级 G4 进阶检查表
| 阶段 | 关键动作 | 自检:「做到才算过」 |
|---|---|---|
| 体系吸收 | 读完第 10–13 章 + 各章方法清单 | 能否把五步工作流串成两周闭环?能否按所在行业定制布点方案? |
| 全案落地 | 独立跑通一轮两周闭环,产出 SOP | 是否产出团队可直接执行的 SOP?是否覆盖四条硬指标与三条红线? |
| 考试取证 | 参加高阶级考试(8 客观 + 3 简答,均分 ≥ 70) | 客观是否达标?简答是否经 AI 预评 + 人工审?取证后解锁 E? |
路径 E · 专家级 G5 进阶检查表
| 阶段 | 关键动作 | 自检:「做到才算过」 |
|---|---|---|
| 全案吸收 | 读完第 14–16 章 + 全部附录 | 能否讲清「实体护城河」怎么建?能否设计一套 Agent 就绪度方案? |
| 系统改造 | 开发一个能力插件(第 15 章)/ 完成一次能力改进(第 16 章) | 插件是否可被系统装配调用?改进是否经校验与回归验证? |
| 全案提案 | 独立产出 8–12 页客户提案 | 是否覆盖 诊断 → 策略 → 执行 → 监测 → ROI 汇报 五段? |
| ROI 叙事 | 把投入与回报算成故事 | 能否向非技术决策者讲清成本与回报,而不是只讲技术细节? |
| 专家考试 | 完成 4 客观 + 2 简答 + 1 方案 | 方案题是否通过人机环共同审题?是否拿到了提案评审结论? |
五条检查表都有一个共同的用意:把「读完」和「学会」区分开。读是输入,打完勾才算真正内化——这也是本教材反复强调「数据驱动而非纸面」的落地体现。
约定与红线说明
读这本教材,请先了解全书的一整套「约定」。它决定了你怎么读、能信多少,以及为什么某些写法会是这样。
全书的通用约定
- 级别徽标:🔵入门 / 🟢基础 / 🟡进阶 / 🟠高阶 / 🔴专家,标在每个子节上,与五级路径一一对应,指示「这一节能解决哪一层的问题」;
- 结构块:每章统一「学习目标 → 核心知识点 → 实测数据 → 参考案例 → 方法清单 → 避坑提醒 → 思考与练习」;
- 证据口径:凡写结论处必标明「是 n=1 单次,还是多次采样的统计口径」,避免把偶然当规律;
- 结论时效:AI 行为会随引擎改版漂移,书里给的是「当下实测」,但机制做到可迁移,换代可自行重推。
教材的红线(为何不与来源绑定)
| 红线 | 说明与原因 |
|---|---|
| 不标注来源链接 / URL / 博客路径 | 教材聚焦机制与动作本身,不给「临时链接」设门槛,避免读者被单点快照带偏 |
| 非 AI 问答引擎的真实品牌 / 平台 / 工具一律用代称 | 传统搜索与算法内部名、传统平台真名、竞品搜索 / 聊天品牌,本书一律不点名;只有本书实测覆盖的 AI 问答引擎可具名。判定清单由一致性校验器维护,不在正文罗列 |
| 不写特定作者名 | 强调「可复验机制」而非「某一家之言」,保持中立可信 |
| 内容均改写自一手实测 | 保证结论能吃得住复验,不做二手转述、不抄网络结论 |
换个角度看这些红线:它们不是为了「怕担责」,而是为「数据驱动」的纪律服务。去掉「谁说的、哪个站说的」,才能逼我们把注意力放回「机制本身是不是真的成立」这一件事上。
读到这里,你已经掌握了读这本书所需的全部「路标」:为什么要学、学的是什么、评价标准是什么、走了哪五条路径、用什么节奏读、全书怎么排、哪几层怎么解锁,以及全书遵守的红线与约定。从这里开始,剩下的学习就交给正文一张张地图去逐格点亮——你手上多了一张总地图,也知道了每张局部地图该在哪一层下功夫。
给读者的一句话开场
好了,地图和路标都已经给你了。不管你从哪条路径开始,请记住前言里最核心的那句话:未来的品牌竞争,不是抢货架的竞争,而是搞定导购员的竞争。下一章,我们先从最基础、但最重要的 SEO 地基开始,一步步把这套新打法学扎实。
现在,选好你的路径,进入第一章吧。
第 6 章 GEO 核心概念
第 6 章 · 12 节 / 104 小节 · 约 4.8 万字
本章导读
🔗 前置:建议先读完第 5 章《答案引擎优化(AEO)》,知道机器如何「找到」答案;本章把优化目标从「被找到」升级为「被引用、被信任」。
请先做一个小实验:随便打开一个 AI 问答应用,输入「哪家公司的产品适合解决××问题」,然后盯着它的回答看三分钟。你会发现,真正决定你下一步点击什么的,不是「谁排在第一」,而是「谁被 AI 提到了」。
这就是本章要讲的核心命题:GEO(生成式引擎优化)研究的不是排名,而是「引用」。
过去二十年,做线上生意的规则简单粗暴——把关键词做到首位,流量自然来。排名是货架逻辑:谁的货摆在最显眼的位置,谁就能捞到最多的目光。可现在,越来越多的人不再「顺着货架逛」,而是直接「问导购员」。导购员回答你的那一刻,货架上成千上万的商品里,它只提了两三个名字。你会在货架上看到一百个商品,但一辈子只会在导购嘴里听到那几个推荐。
那两三个名字,就决定了你最终走向谁。
本章要建立的,正是这套新竞争逻辑的完整认知骨架。我们会依次回答五个问题:
- GEO 是什么——它和 SEO(详见第 1 章)的边界在哪里,为什么研究对象从「排名」变成了「引用」;
- 排名 vs 引用 vs 信任——这三层到底差在哪,哪一层花多少钱都买不来;
- 为什么现在是窗口期——整个市场正处在一个「广告位还没出现」的黄金阶段,错过就要付出更高代价;
- 参考案例——为什么「被说到」比「排第一」更值钱,这是真金白银的认知;
- 落地方法——把「被 AI 引用」从玄学变成一套可测量、可复盘的体系。
读完本章,你会掌握一套看穿「信息竞争」的慢镜头视角:不着急抢位置,而是先把自己变成「AI 愿意反复提到、用户愿意反复相信」的那个人。
学习目标 1. 能清晰复述 GEO 的定义,并指出它与 SEO 在研究对象上的根本差异; 2. 能拆解「排名 / 引用 / 信任」三层,并说出每一层能否用钱买到; 3. 能解释「无广告位的商场」为什么是当前最值钱的竞争窗口; 4. 能复述「被说到 > 排第一」的核心机制(复利资产); 5. 能独立搭建一份「品牌 × 品类」的 AI 亮相基线记录。
章节级别映射
本章级别映射:🔵 入门 · 🟢 基础 · 🟡 进阶 · 🟠 高阶 · 🔴 专家(子节标题带徽标)
| 子节 | 内容 | 级别 |
|---|---|---|
| 6.1 GEO 是什么 | 定义、与 SEO 的边界、研究对象从「排名」转向「引用」 | 🔵 入门 |
| 6.2 排名 vs 引用 vs 信任 | 三层差在哪,以及哪一层花钱也买不来 | 🔵 入门 |
| 6.3 市场窗口期:答案不敢卖 | 广告位尚未出现,机会成本为何会抬升 | 🟠 高阶 |
| 6.4 参考案例:为什么「被说到」比「排第一」值钱 | 复利资产,而非一次性曝光 | 🟡 进阶 |
| 6.5 方法清单:把「被说到」落地成可评估动作 | 从玄学变成可测量的体系 | 🟡 进阶 |
| 6.6 思考与练习 | 🔵 认知理解 / 🟡 动手实操 / 🟠 进阶推演 | 分级 |
| 6.7 陷阱避坑:新手最容易踩的十个红灯 | 先避坑,再谈增长 | 🔵 入门 |
| 6.8 工具方法:一套能持续运转的 GEO 工作方式 | 把动作固化成节奏 | 🟡 进阶 |
| 6.9 进阶专家视角:把 GEO 放进更大的棋盘 | 信息竞争的慢镜头视角 | 🟠 高阶 |
6.1 GEO 是什么(🔵 入门)
6.1.1 一个词的定义:从学术论文走到商业现实
「GEO」全称 Generative Engine Optimization,生成式引擎优化。这个词并非某个公司发明的营销话术,它最早出自 2023 年一篇同行评审的学术论文,随后在 2024 年的国际数据挖掘会议上正式发表并被广泛讨论。
它的定义可以浓缩成一句话:
GEO 是一整套让「生成式 AI 引擎」在回答用户问题时,愿意引用你、推荐你、替你说话的方法论。
拆开这句话,有三个关键词值得你反复咀嚼:
| 关键词 | 传统理解 | GEO 视角 |
|---|---|---|
| 引擎 | 浏览器里的那个「输入框」 | 会生成答案的 AI(问答、搜索、Agent) |
| 引用 | 传统搜索引擎把网页列为一条结果 | AI 在自然语言答案里「点名」你的品牌/内容 |
| 优化 | 调标题关键词、买外链 | 调整内容的可信度、可抽取度、一致性 |
你看,同样的喜悦「引擎」两个字,语义已经发生了漂移。传统引擎卖的是「一份链接清单」,生成式引擎卖的是「一段答案文本」。清单里你是一行 URL,答案文本里你是一句被说出口的话——后者带温度和信任,也带决策权重。
6.1.2 一个核心类比:抢货架 vs 搞定导购员
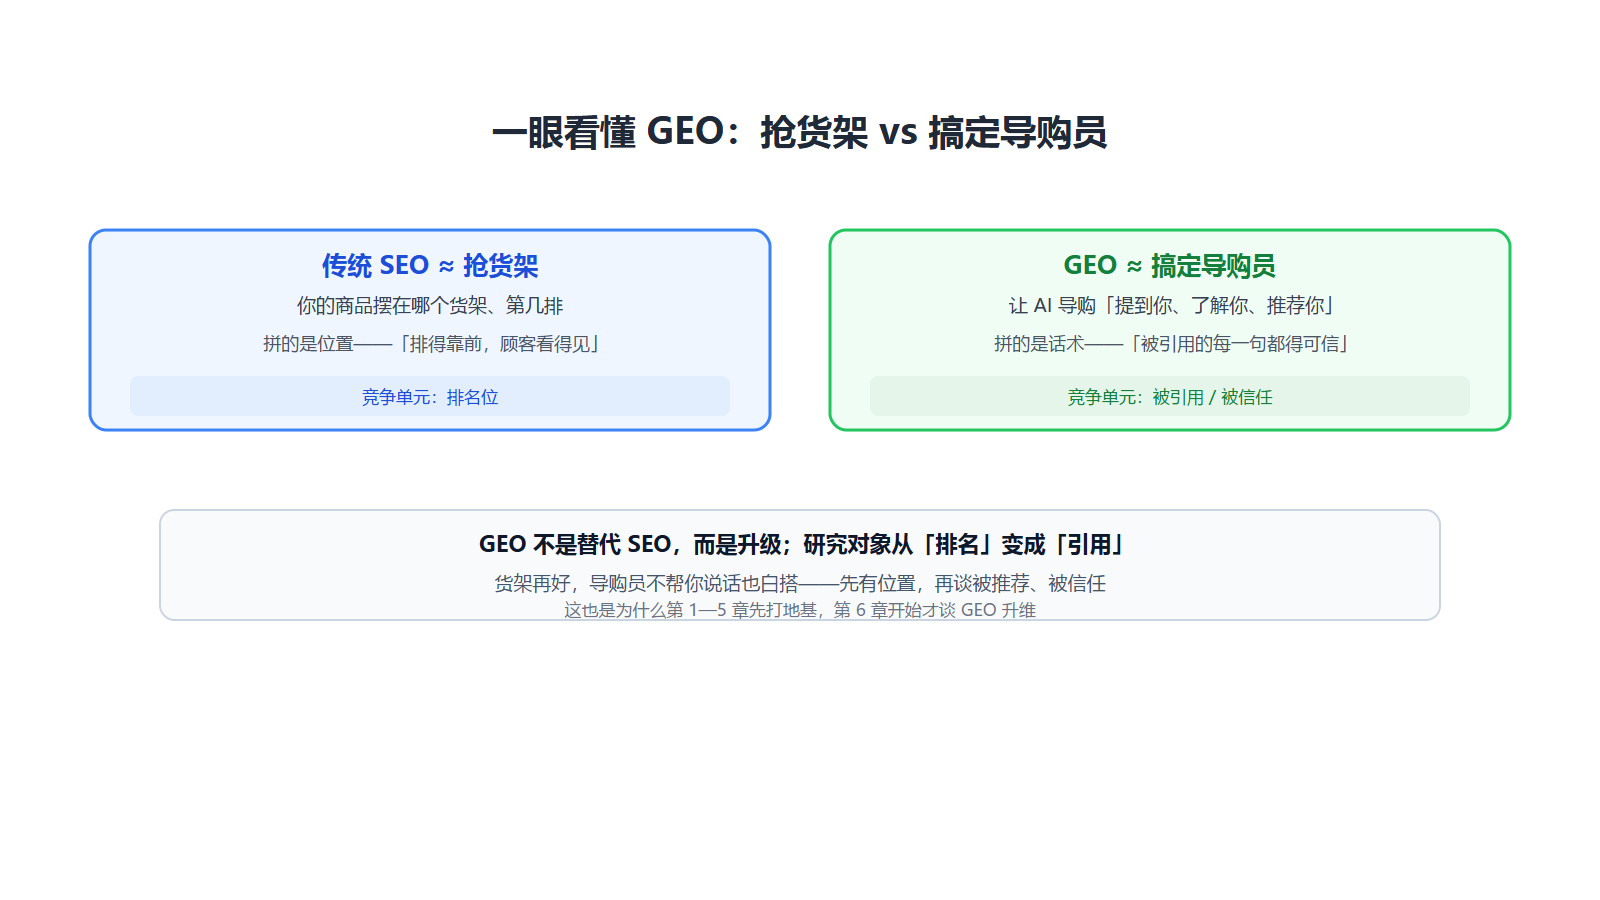
图 6-1 抢货架 vs 搞定导购员:传统 SEO 拼「被看见的位置」,GEO 拼「被引用的那句话」。
要理解 GEO,最省力的方式是记住一个类比:
SEO 是抢货架(让货摆在显眼处被人看到);GEO 是搞定导购员(让导购员回答顾客时推荐你)。AI 引擎就是那个「导购员」,GEO 优化的,是它「愿不愿意在回答里提到你」。
把这个类比展开,你能看到两者的世界观:
- 做 SEO 的人,关心的是「我的货放在第几排、离人近不近、标签醒不醒目」。他相信流量来自「被看见」。
- 做 GEO 的人,关心的是「导购员对我熟不熟、信不信、会不会在别人问起时主动说我的好话」。他相信转化来自「被推荐」。
这里有个很反直觉的现象:在人逛货架的年代,摆在角落却口口相传的牌子,往往活得比摆在 C 位但不被推荐的牌子更久。因为货架位置是死的、一次性的、可以被花钱挪动的;而「导购员愿不愿意推荐你」是活的、可积累的、只认理由不认钱的。
GEO 的全部智慧,都在于你怎么从一个「抢货架的人」,变成一个「让导购员心悦诚服的人」。
6.1.3 关键转变:研究对象从「排名」变成「引用」
这是本章最重要的一处分水岭,请把它刻在脑子里:
| 传统 SEO | GEO | |
|---|---|---|
| 核心问题 | 我排第几? | AI 会不会提到我?怎么提到我? |
| 优化对象 | 位置(ranking) | 引用(citation) |
| 裁判 | 算法(爬虫+排序模型) | AI 生成 + 用户信任 |
| 可买程度 | 付费/外链/技术,基本可买 | 靠内容资产与可信度,很难硬买 |
| 时间属性 | 快、一次性的位置 | 慢、可累积、复利 |
为什么说「引用」比「排名」更值钱?我们从三个角度拆:
第一,排名是「一次性的位置」,引用是「持续的被认可」
某次搜索你排第一,那只证明「那一刻算法给了你一个位置」。算法一调、竞品一上、你的页面一改版,位置立刻拱手让人。它像一张随时可能被撕掉的贴纸。而 AI 反复把你列进答案,等于一次次替你背书——这不是「买来的位置」,而是「被采信」的额度,会随着你被提到的次数滚雪球。
第二,排名的裁判是算法,引用的裁判是「AI + 用户信任」
算法的脾气你还能通过技术手段去讨好;但 AI 背后的用户信任,是花钱买不来的东西。你可以用预算让某个词条「上热搜」,但你没法用预算让 AI 心里「认可你」。GEO 投资的正是后者——它不是和算法做交易,而是和「信任」做慢生意。
第三,引用是复利,排名是利息
复利和利息的差别在于:利息是你的本金不变、它按时给你一点收益;复利是你赚到的收益也会继续生钱。排名给的是一次性的「利息」(每次搜索单独结算);引用积累起来,会撬动更多内容、更多信源、更多 AI 反复引用你——它自己会越长越大。
6.1.4 为什么「研究引用」比「研究排名」更难
更难,意味着护城河更深,也意味着入场的先发者更占便宜。难在三个地方:
| 难点 | 具体表现 |
|---|---|
| 难在「裁判不透明」 | 排名有明确的规则和工具(站长后台、排名查询),引用呢?你看不到 AI 内部的评分逻辑,只能靠反复实测反推 |
| 难在「答案会漂移」 | 同一道题,今天 AI 引你,明天可能引别人;版本一更、策略一调,引用池就变 |
| 难在「不能靠钱速成」 | 排名加预算立竿见影,引用加预算基本无效——它只认内容和信任,逼你走慢路 |
但也正因为难,现在布局的人才有先发红利。等到引用也像排名一样能「明码标价」时,它的价值就已经被瓜分得差不多了。
6.1.5 别急着否定 SEO:GEO 是 SEO 之上的升维
这里必须说清一个容易误会的点:GEO 不是要取代 SEO,而是站在 SEO 的肩膀上往前再走一步。
AEO(答案引擎优化,详见第 5 章)和 GEO 都建立在传统 SEO 的地基之上。抓取、索引、可渲染、可抽取、可信——这些是「让 AI 能引用你」的前提。如果搜索引擎根本抓不到你、你的页面是纯图片不可抽取、你的信息互相矛盾不可信,那 AI 想引用你也无从下手。
所以更准确的说法是:SEO 解决「被找到」,AEO/GEO 解决「被采信 + 被推荐」。前者是地基,后者是楼层。地基打不牢,楼层盖再高也会塌;但只打地基不盖楼,你也就永远停在地平线。
6.1.6 关于「GEO」的几个常见误区
为了让概念不被稀释,我们顺手破除几个流传很广的误读:
| 误读 | 真相 |
|---|---|
| 「GEO 就是把同一篇文章发到更多平台」 | 多发只是手段之一,核心是「让 AI 有理由重复引用你」,铺量 ≠ 被采信 |
| 「GEO 就是给 AI 灌自己的网站」 | 引用 ≠ 灌水,AI 有判断力;硬灌会伤可信度 |
| 「GEO 是一锤子买卖」 | 它是持续累积的内容资产 + 信任工程,没有终点 |
| 「GEO 只对大品牌有用」 | 恰恰相反,无广告位的窗口期里,小品牌最有机会靠内容占坑 |
6.1.7 深讲:为什么「答案文本」比「链接清单」更值钱
前面的表格里出现了一句话:传统引擎卖的是「一份链接清单」,生成式引擎卖的是「一段答案文本」。这句话值得我们再往深里挖一层,因为它背后藏着整个 GEO 商业逻辑的地基。
链接清单的计价方式是「一次点击」,答案文本的计价方式是「一次判信」。
当你看到一个传统搜索结果页,里面有十条蓝链接,你默认它们是「备选项」,需要你自己跳出去比较、筛选、下判断。你点谁,不完全取决于谁排在前面,还取决于标题、摘要、网站品牌在你心里的分量。换句话说,传统搜索把「选择」的重任留给了你,平台只负责罗列。
而生成式引擎给出的是一段连贯的话。它不是在罗列备选项,而是在「替你做完判断」。当 AI 说「这类问题通常建议考虑某品牌」,你得到的不再是一个中性链接,而是一句带着推荐姿态的结论。你不再是逛货架的人,而是听了导购意见的人。这两者对你的消费决策,权重完全不同。
我们可以用一个对照把它说清:
| 维度 | 链接清单 | 答案文本 |
|---|---|---|
| 用户在做什么 | 自己在货架里挑 | 听导购替你推荐 |
| 平台的姿态 | 中立罗列 | 隐含立场 |
| 决策责任 | 用户自己扛 | AI 替你分担 |
| 品牌被点名的意义 | 是一次曝光 | 是一次背书 |
这就是为什么同一次「被 AI 提到」,对用户心智的冲击,远大于同一次「排在搜索第一」。前者是别人替你做的判断,后者是需要你自己下的判断。判断由谁来做,谁就掌握了那一瞬间的信任分配权。GEO 争夺的,正是这个「判断分配权」。
6.1.8 深讲:研究「引用」的技术前提,为什么是这些年才可行
GEO 这个概念虽然 2023 年才被正式提出,但「让内容被 AI 引用」这件事,其实早就有雏形。为什么以前没有专门的方法论去研究它?因为有三个技术前提,直到近几年才集体成熟:
| 技术前提 | 之前的状态 | 现在的状态 |
|---|---|---|
| 大语言模型能读懂内容 | 只能做关键词匹配 | 能理解语义、抽取要点、生成答案 |
| 生成式问答成为入口 | 搜索仍是唯一入口 | 问答、搜索、Agent 并存,且占比上升 |
| 可观测的「引用」行为 | 几乎不可见 | 能通过实测反推部分线索 |
第一前提是「能读懂」。早期的搜索引擎,本质是关键词匹配系统,它对内容的理解停留在「有没有这个词」。直到大语言模型出现,机器才真正具备了「读懂上下文、判断谁说对」的能力。只有机器能读懂,机器才谈得上「信不信任你」。所以「信任」作为被优化的对象,在技术上前提就是「机器懂得读」。
第二前提是「问答成为入口」。传统的入口是搜索框,你输入关键词,它返回列表。现在越来越多的用户,把整个问题写进去,让 AI 直接给出回答。入口从一个「返回链接的设备」,变成了一个「生成判断的设备」。入口变了,竞争的战场就跟着变了。
第三前提是「引用可以被观测」。如果 AI 的决策完全是一个黑箱、完全不可知,那你无从优化。而现实是,你完全可以用「品牌名 + 品类」去实测 AI,观察它提到谁、怎么提、背后的理由是什么。虽然这不等于看到了 AI 的内部评分,但它提供了可以反复比对的观测窗口。凡可观测,才可优化。这三点合起来,才是 GEO 方法论得以成立的技术土壤。
6.1.9 深讲:GEO 面对的不止问答,是三类引擎
很多人一谈 GEO,脑子里只有「AI 问答聊天框」。但生成式引擎实际上覆盖了至少三类产品形态,每一类的「被引用」方式和优化重点都不一样:
| 引擎类型 | 典型形态 | 用户怎么用 | GEO 重点 |
|---|---|---|---|
| 问答引擎 | 对话式助手 | 直接发问,要一段答案 | 让 AI 在答案里点名你 |
| 搜索型引擎 | AI 与搜索结果混合页 | 输入问题,看到融合的摘要 + 链接 | 让 AI 摘要里推荐你,同时保住排名 |
| 智能体 Agent | 会调用工具、分步执行 | 让你代我完成任务(订、买、办) | 成为它能「调用」的那个服务 |
问答引擎看重的是「你被不被点名」;搜索型引擎看重的是「你在摘要里被不被采信,同时排名不塌」;智能体 Agent则更进一步——它不只是引用你的内容,而是可能直接「调用」(即「被调用」,详见第 14 章)你的能力(比如通过某种接口帮你下单)。到了 Agent 这一层,「被引用」就直接等同于「被采纳进交易半径」了。
对从业者来说,这带来两个提醒:第一,不要把 GEO 窄化成「只优化聊天框」,要三种形态一视同仁地盯;第二,越往后,Agent 的权重越高,这也是为什么本章把「被引用即资产」抬到如此高的位置——因为当 Agent 普及后,「被引用」很可能就等于「被下单」。这是给 CEO 的一句话:现在投入内容,是在为一个「引用=交易」的未来提前占坑。
6.1.10 深讲:被引用的进阶五阶段——你现在在哪一段
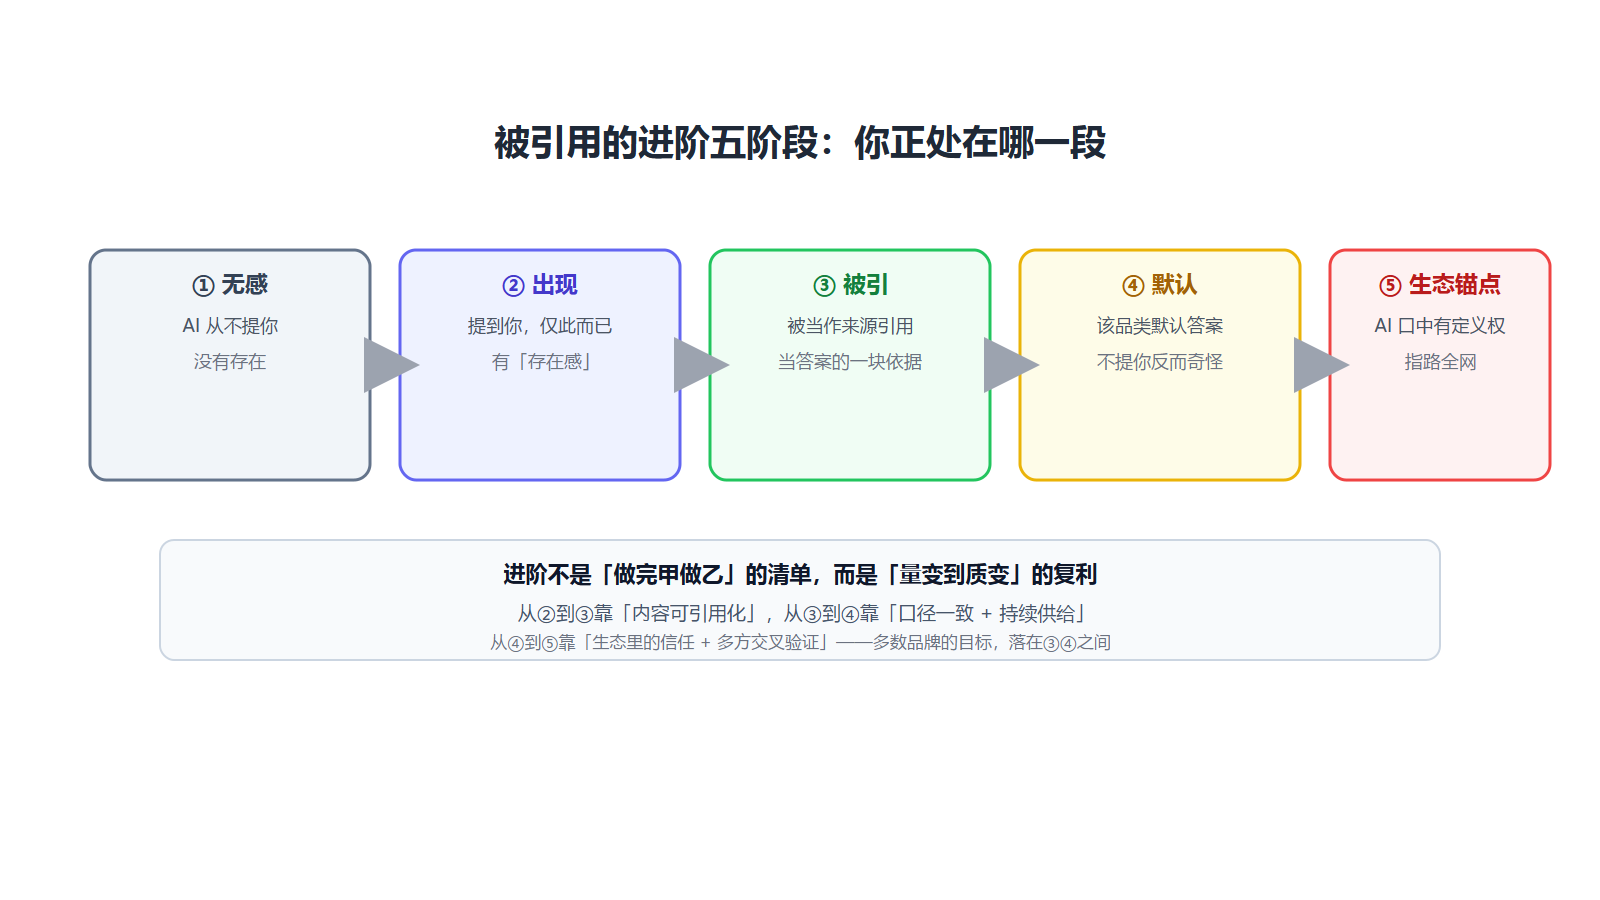
图 6-2 被引用五阶段:从「无感」到「生态锚点」,多数品牌的目标落在「被引」与「默认」之间。
GEO 不是一蹴而就的「开或关」,而是一条爬坡路。看清这条路有五个阶段,能帮你准确定位自己「在哪儿」,也知道下一条要踩哪块石头:
| 阶段 | 状态 | 主要标志 | 下一阶段的钥匙 |
|---|---|---|---|
| 空窗 | 完全没有被提到 | AI 答案里从不出现你 | 建立基线、产出结构化内容 |
| 偶尔出现 | 偶尔被点名 | 部分问题下会提到你 | 扩大覆盖面、统一口径 |
| 稳定出现 | 常见问题里常被引用 | 多个引擎多次推荐你 | 增强可核查、补高质量背书 |
| 默认答案 | 提到品类就想到你 | 用户默认你 = 该品类 | 持续养护,守好资产 |
| 生态锚点 | 成为该品类的共识源 | 别的内容也引你、翻译你做参考 | 扩张到相邻品类,形成矩阵 |
这套五阶段的价值,在于它把「含糊的努力」变成了「有坐标的成长」。大多数团队卡在「偶尔出现」到「稳定出现」之间,缺的往往不是内容量,而是口径统一和可核查性(即「可核查」,详见第 2 章与本章)。看清自己卡在哪一段,才能对症下药,而不是盲目加码。
6.1.11 全景图:把 SEO / SGE / AEO / GEO 放同一张桌
业界常把这几个缩写字搞得人头晕,这一节把它们并排放在一张表里,一次性理清彼此的关系:
| 缩写 | 全称/含义 | 研究对象 | 一句话定位 |
|---|---|---|---|
| SEO | 搜索引擎优化 | 传统排名位置 | 让内容「被搜到」 |
| SGE | 生成式搜索体验 | 搜索里嵌答案的体验 | 在搜索里给用户即时答案 |
| AEO | 答案引擎优化 | 让内容成为直接答案 | 让内容「能直接回答问题」 |
| GEO | 生成式引擎优化 | 让 AI 愿意引用你 | 让 AI「愿意在回答里点名你」 |
它们的关系可以这么理解:SGE 是搜索的一种产品形态,AEO 是让内容更会被引用(可抽取)的技术基础,GEO 则是在 AEO 之上、面向「是否被 AI 点名推荐」的更高追求。换句话说,AEO 解决「AI 拿得走你的内容」(可抽取),GEO 解决「AI 愿不愿意把你当答案推荐」(被采信)。
对从业者的实际意义是:别在这些缩写字上纠结谁取代谁,你的动作是同一套。把内容做成「可抽取、可核查、结论前置、口径一致」,就同时服务了 SEO、SGE、AEO、GEO 四个目标。先把这个基础动作做扎实,缩写字叫什么根本不重要。
6.1.12 深讲:把 GEO 当成「品牌资产组合」来管理
很多团队做 GEO 是「哪里热闹扑哪里」——今天看到某个引擎火就去测那个,明天看到某个品类好做就换那个。这种打法的问题在于:被引用像投资组合,你既不能全押一个篮子,也不能撒胡椒面似的什么都投。
先看「分散」的必要性。你的目标用户分布在多个引擎上,每个引擎的内容偏好、信源偏好、更新节奏都不一样。如果你只在一个引擎上做到「被稳定引用」,那等于把资产全押在单一平台上——那个引擎一改版、一调整信源策略,你的引用资产就可能大幅缩水。至少覆盖 2-3 个不同类型的主引擎(比如对话问答类、AI 搜索类、生态内容类各一),是资产组合的底线。
再看「聚焦」的不可替代。分散不等于平均用力。三个引擎里,一定有一个是你目标用户最常打开、离成交最近的「主战场」。主战场要做到「被默认引用」级别的深度,其余引擎做到「被稳定提及」级别的广度即可。主战场决定你能不能赢,次战场决定你能赢多大。两者不是二选一,而是「一深一浅、有主有次」。
最后看「再平衡」。资产组合需要定期再平衡——每季度回看一次:主战场引擎是否仍是你用户的主入口?你的引用分布是否过度集中在某一个信源上?如果某个引擎的引用占比高达八成以上,那其实是一种隐形的风险集中。把「引用占比」当成持仓比例来盯,该加码的加码、该分散的分散,GEO 才不会成为一颗押错注的赌局。
6.1.13 深讲:从零到被引用的「三块敲门砖」
一个新品牌、一块新业务,几乎是从零开始被 AI 认识的。很多人一上来就想着「铺量」,其实更稳的路径是先敲开三块敲门砖——它们是有先后顺序的:
| 敲门砖 | 是什么 | 为什么是它 | 反例 |
|---|---|---|---|
| 第一块:内容砖 | 一篇结论前置、结构清晰的核心内容 | AI 只能引用「抽得走」的东西 | 先买一堆软文铺量,AI 抽不动 |
| 第二块:数据砖 | 带日期、可核对的真实事实 | AI 最怕喂错事实,可核查是信任门槛 | 空口写「行业领先」,无从核实 |
| 第三块:背书砖 | 来自第三方的独立认可 | AI 会参考「别人怎么说你」 | 自说自话,全网只有官网一个声音 |
顺序为什么不能乱?因为三块砖是层层垫高的关系:没有内容砖,数据砖无处安放(可核查的事实需要落在可抽取的载体上);没有数据砖,背书砖没有支点(第三方要认可的是你具体可核的哪一点)。先做内容结构、再补事实密度、最后攒独立背书,每一步都为下一步铺好台阶。
用一个小案例体会三块砖的合力:某小型 SaaS 团队没有预算做投放,只做了一件事——把自家产品的「能力边界 + 定价 + 适用规模」写成一篇带日期的对比长文,然后邀请几家独立评测媒体试用后各写了一篇短评。半年后,当用户问「适合 20 人团队的某类工具」时,AI 的答案里出现了他们的名字,引用的正是那篇对比长文和那几篇短评。每一块砖都不复杂,但三块砖叠起来,就把「无人知晓」变成了「默认答案的候选」。
6.1.14 深讲:别把 GEO 和「品牌公关」混为一谈
很多老板把 GEO 理解成「升级版的公关」——多写稿、多上媒体、多曝光,AI 自然就认识你了。这个理解只对了一半,而且容易把预算引向错误的地方。GEO 和品牌公关有三处本质区别,值得先分清:
| 维度 | 品牌公关 | GEO |
|---|---|---|
| 目标对象 | 人(媒体、KOL、公众) | 机器(AI 引擎)+人 |
| 成功标准 | 报道量、声量、美誉度 | 被引用率、被怎么描述、可核查度 |
| 内容形态 | 新闻稿、专访、活动 | 结构化、结论前置、带日期的答案型内容 |
| 可测量性 | 常靠估算 | 可固定问法反复实测 |
区别的实质是:公关追求「让更多人知道」,GEO 追求「让 AI 有依据地采信」。一篇声量很大的公关稿,如果没有任何可抽取的结构,AI 可能根本不会引用它(还记得 6.4.1 的「精致宣传片」吗);而一篇没人看、但结构清晰、事实可核的长文,反而可能成为 AI 的稳定信源。所以做 GEO 的正确姿势不是「公关 + 内容」,而是「内容做成可被 AI 抽取的样子,公关成果也翻译成结构化内容」。两者可以互相成就,但绝不能互相替代。
6.2 排名 vs 引用 vs 信任(🔵 入门)
6.2.1 一张表看清三层的本质
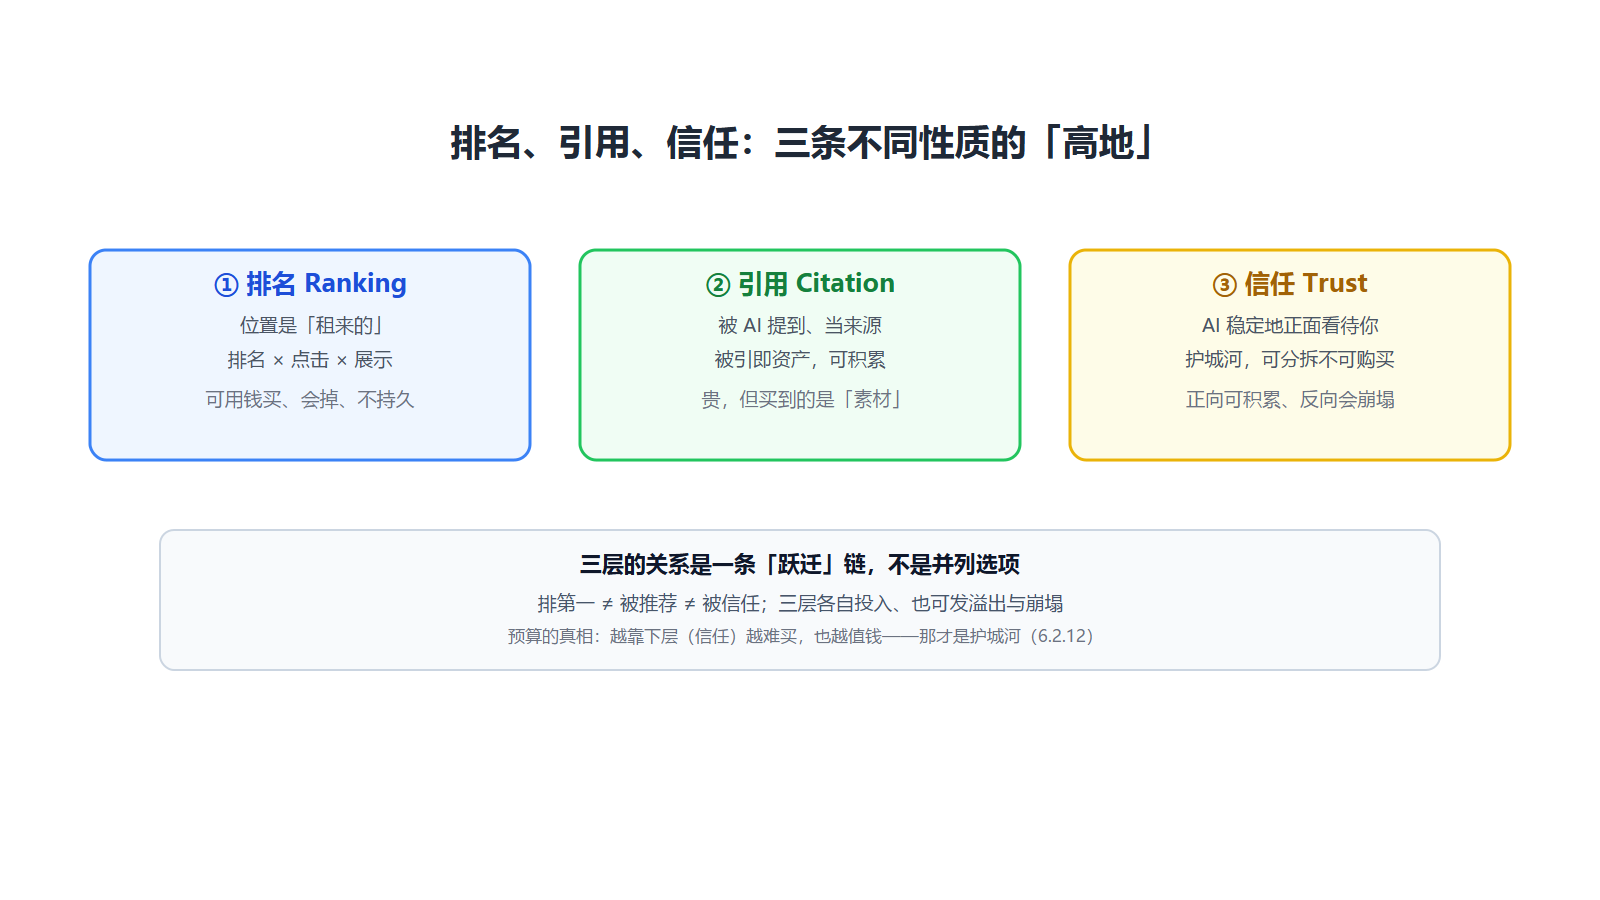
图 6-3 排名、引用、信任:三层性质不同——位置可租、被引即资产、信任是买不来的护城河。
理解了「研究对象」的转变,接下来我们用一张总表,把「排名 / 引用 / 信任」三层彻底说透:
| 维度 | 排名(Ranking) | 引用(Citation) | 信任(Trust) |
|---|---|---|---|
| 问的是 | 我排第几? | AI 会不会提到我? | 用户信不信我? |
| 谁能看见 | 人 | 机器(AI) | 人 + 机器 |
| 典型指标 | 关键词排名、收录数 | 被引用次数、被怎么描述 | 复购、口碑、NPS |
| 你能投什么 | 付费、外链、技术 | 内容资产 | 一致性、可核查 |
| 能否付费买 | 基本可买 | 很难直接买 | 买不到 |
三句话概括这三层:
- 排名让人「看见你」——这是入口,解决「能不能被搜到」;
- 引用让 AI「提到你」——这是放大,解决「AI 作答时选不选你」;
- 信任让人与机器「采信你」——这是根基,解决「说了算不算数」。
6.2.2 「位置是死的,话术是活的」
在正文里,还有一组非常精辟的对仗值得你记住:
- 位置是固定的(这是 SEO 的思维):排名是「占位」,算法一调就变,你的名次永远处于被他家超越的威胁中;
- 话术是活的(这是 GEO 的思维):引用是「被说到」,同一道题今天引你、明天引别人,它需要被你持续地赢得。
所以排名和引用的本质差异是:排名靠「抢」,抢到那一刻算那一刻;引用靠「守」,得持续不断地被认可、被信。
6.2.3 三层能不能花钱买——这是管理预期的最重要一课
对企业主和团队负责人来说,理解「哪一层能买、哪一层不能买」,比理解任何技巧都重要。因为它直接决定了你该把预算投向哪里。
| 层 | 能买吗 | 买了什么 | 买不到的 |
|---|---|---|---|
| 排名 | ✅ 基本可买 | 广告位、外链、竞价 | 位置本身挽留不住用户 |
| 引用 | ⚠️ 很难直接买 | 赞助内容(效果存疑) | AI 的「自愿认可」 |
| 信任 | ❌ 买不到 | —— | 用户心里的那个「信」字 |
这里有个残酷的真相:你已经买得到的(排名),恰恰是最不值钱、最不持久的那一层;你买不到的那两层,才是真正的护城河。
说句掏心窝的话给决策者:如果今天有人告诉你说「花 XX 万,保证你的品牌被所有 AI 引擎天天引用」,请直接拉黑他。因为这项服务在物理上不存在——引用是基于内容资产和可信度的长期结果,不是一个可以用预算 "一键开启" 的功能。
6.2.4 三层如何协作:一条完整的用户旅程
三层不是彼此独立的孤岛,而是一条接力链:
看见你(排名)→ 提到你(引用)→ 相信你(信任)→ 成交/复购
排名是漏斗入口,让人有机会认识你;引用是放大器,让机器在用户开口之前就替你做了筛选;信任是转化器,决定用户最后真的掏钱的那一刻。
所以正确的心态不是「三选一」,而是「知道重心在哪」。对企业来说:
- 如果现在还无人问津,先解决「看见」(排名/曝光);
- 如果已经有曝光但没转化,问题多半出在「信任」而不是「排名」;
- 如果你希望长期稳坐某品类的默认答案,那就要全力经营「引用 + 信任」。
6.2.5 给新手的检验:一眼分辨「SEO 思维」还是「GEO 思维」
判断一次优化动作到底属于哪种思维,有一个很干净的检验标准:
看它是在争「排名位置」,还是在建「被引用的资格 + 可信度」。
举几个例子:
| 动作 | 属于 | 为什么 |
|---|---|---|
| 买十个高价外链冲关键词名次 | SEO 思维 | 目标直指「位置」 |
| 把产品 FAQ 写成「带日期、可核查、结论前置」的结构化问答 | GEO 思维 | 目标指向「被采信、可抽取」 |
| 疯狂叠加关键词密度 | SEO 思维 | 讨好算法而非 AI/用户 |
| 做一篇 3000 字行业白皮书 + 对比表 + 引用出处 | GEO 思维 | 成为「该品类的默认答案」 |
| 上线即见效的排名提升 | SEO 思维 | 买位置,快但不持久 |
| 三个月后 AI 开始稳定引用你 | GEO 思维 | 建资格,慢但复利 |
记住这个检验杆,它会帮你在一个动作里,立刻判断出自己是在「抢货架」,还是在「搞定导购员」。
6.2.6 深讲:排名的边界——为什么它不持久、也不稀缺
既然排名是最矮的那层楼,我们先把话说透:排名到底买来了什么,又买不来什么。
排名买来的是「那一刻的位置」,不是「那一个用户」。当用户打开搜索页,你的广告位或高排位确实触达到了他的眼睛。但触达只负责「看一眼」,不负责「信任」和「下单」。广告位买来的是曝光机会,曝光机会能不能转身变成交易,取决于这个用户信不信你。而「信不信」不在广告系统里,在你的内容与口碑里。
再看稀缺性。「在搜索里排第一」看起来是稀缺资源,但真正的稀缺是「被这个具体的人相信」。搜索页顶部的广告位,谁钱多谁上,它是给「大写的人」准备的通用曝光;而「让某个人信任你」是不可批量复制的、分散在每个用户心里的一次次判断。前者大家都能抢,后者只有你能拥有。
用一个更直白的类比:排名是「广播」,引用和信任是「对话」。广播的问题是,你不知道谁在听、谁听进去了;对话的问题是,一旦建立就特别牢固。GEO 想要经营的不是广播的覆盖,而是对话的深度。这也是为什么本章反复强调:别用买排名的预算思维,去套引用和信任——那是拿广播的钱,去硬买只有对话才给得出的东西。
6.2.7 深讲:「被引用」的资产属性——被引即资产
这是全章最核心的商业命题之一,值得单独拿出来深讲。
为什么「被引用」能称得上资产?判断一样东西是不是资产,就看三点:它是否可持续产生价值、是否会随时间累积、是否难以转移或抹去。对照看,「被 AI 引用」恰好三条都满足:
| 资产三判定 | 「被引用」是否符合 | 底层原因 |
|---|---|---|
| 可持续产生价值 | ✅ | 每次 AI 作答都可能再次提到你 |
| 会随时间累积 | ✅ | 引用越多,越像「权威」,越容易被再引 |
| 难以转移或抹去 | ✅ | 它长在用户的认知和 AI 的训练分布里,买不走 |
这三点让「被引用」具备了跟「品牌」一样的资产属性——它不是一笔可以刷掉的交易记录,而是会自我强化的认知存量。这就是「被引即资产」的完整逻辑:引用不是流量的附赠品,而是可以放进资产负债表的东西。
为什么难以抹去?因为 AI 对你的引用,建立在「大量分散内容对你的反复认可」之上。它不是一个可以被某个竞争对手买断的位置,而是一种散布在网络各处的一致性印象。要撼动它,得同时改变无数个信源里的你,成本极高。
6.2.8 深讲:信任的三块积木——可分拆,但不能购买
我们说信任买不到,那它到底是什么构成的?把「信任」拆开,你会发现它其实由三块可以分别经营的积木组成,只是每一块都只能用「做」,而不只能用「买」:
| 积木 | 含义 | 靠什么夯实 | 能买吗 |
|---|---|---|---|
| 一致性 | 你在不同地方说的都一样 | 统一话术、口径可核对 | 买不到,只能做 |
| 可核查性 | 你的说法经得起核对 | 带日期、带出处、可验证 | 买不到,只能做 |
| 他人背书 | 别人(含 AI)愿意替你说话 | 长期服务、真实口碑沉淀 | 只能间接促进 |
一致性解决的是「你说的话自不自洽」。官网说一套、百科说一套、第三方说另一套,用户和 AI 都本能地选择不信。可核查性解决的是「你经不经得起查」。一个带月份的价格、一个真实连续的联系方式、一段能被第三方验证的承诺,比一堆形容词可靠得多。他人背书解决的是「除你以外还有谁信」。这需要时间,也是唯一带有「间接购买」空间的部分——但所谓花钱买背书,买的也只是「让更多人愿意去了解你」,最里头那一层信不信任,依旧得靠你本人。
把三块积木放在一起,就解释了一个反直觉的事实:为什么有的品牌知名度不高,却被 AI 高频率引用?因为它三块积木的「做工」扎实——口径一致、事实可核查、也积攒了少量高质量背书。这是钱买不到的整洁,是日复一日经营出来的结果。
6.2.9 深讲:三层之间的跃迁——正向积累与反向崩塌
三层不是静态的,它们之间存在清晰的跃迁路径,而且方向可以同时「向上」和「向下」。
正向路径(积累): 排名带来「看见」→ 看见多了,配合高质量内容,转化出「引用」→ 引用多了,形成稳定口碑,沉淀为「信任」。这是一条由浅入深的爬坡,每一层都是上一层的放大器。
反向路径(崩塌): 一旦信任崩塌(比如一个可核查的承诺被戳穿)→ 引用立刻降温(AI 开始引用你的负面)→ 连带着之前的排名、曝光都失去转化价值,因为用户已经不信你了。向下的速度远远快过向上。信任的建立以年计,崩塌可能只需一条被核实的坏消息。
| 跃迁方向 | 触发因素 | 时间尺度 | 可逆性 |
|---|---|---|---|
| 排名 → 引用 | 结构化、可核查的高质量内容 | 中(数月) | 可逆但需重新积累 |
| 引用 → 信任 | 长期一致、持续有价值的输出 | 长(按年) | 极难获得、极难守住 |
| 任何一层 → 崩塌 | 事实失信、口径混乱 | 极短 | 基本不可逆,需重建 |
这个「向上很慢、向下很快」的不对称,是全章最重要的一条风险认知。它提醒你:珍惜已经建起来的引用和信任,因为它们不仅是资产,还是那种崩塌后极难复原的资产。
6.2.10 可付费分析:预算到底能在哪一层买到什么
决策最关心的永远是:我出钱,能换来什么。这一节我们用一张表,把「预算 × 三层」的兑换率摊开看清,帮你把钱花在该花的地方。
| 你花钱买 | 实际买到 | 性质 | 建议 |
|---|---|---|---|
| 排名/竞价 | 短期位置的曝光 | 一次性、可被超越 | 适合冷启动或大促,别当护城河 |
| 外链/PR | 一定权威信号的积累 | 半资产,需持续 | 有效但别只买链接不买内容 |
| 赞助/软性推荐 | 不确定、效果存疑的曝光 | 存疑 | 只当补充,别当主策略,易伤可信度 |
| 优质内容生产 | 一个「可被引用」的基座 | 真资产、复利 | 这笔钱最该花、最长久 |
| 用户口碑经营 | 信任的间接促进 | 慢、底层 | 在所有层里最值钱 |
把这张表读透,你会得到一个反直觉的结论:真正值得花大钱的是「最不能直接买」的那两块——内容与口碑。因为直接花钱能买到的东西(排名、外链),别人也能买到,不构成差异;而花钱买内容这个「基座」和经营口碑这个「底层」,恰恰是别人用同样预算很难复制、且能沉淀为长期资产的部分。
这并不意味着排名预算就该一分不花。正确的配比思维是:用排名预算解决「现在要被看见」,用内容与口碑预算解决「未来要被采信」。两者一个是你的当下现金流,一个是你的长期资产,缺一不可,但绝不能本末倒置。
6.2.11 三层自查:用一张问题清单诊断你的缺口
前面讲了很多概念,这里把它们浓缩成一张「三层缺口诊断清单」,让你拿着它,就能立刻给自己的品牌把脉:
| 观察现象 | 对应的层 | 最可能的缺口 | 优先动作 |
|---|---|---|---|
| 没人认识、也没曝光 | 排名 | 连「看见」都没解决 | 先解决曝光与入口 |
| 有曝光、但转化很差 | 信任 | 用户不信任你 | 做可核查、讲口碑、修口径 |
| 有曝光、用户也不反感,但 AI 不提你 | 引用 | 内容不可抽取、缺权威 | 结构化成可引用,补质量信源 |
| 有人推荐你,但说法是负面的 | 引用(负向) | 口径/事实出问题 | 修正事实、统一表述 |
| 处处都在说,但说法互相矛盾 | 引用 + 信任 | 口径混乱 | 建立口径手册 |
这张表是这个章节「如何落地」的浓缩版:你不再需要背概念,只需要对自己诚实,逐条对照找到缺口,然后去补那一块。三层不是三选一,而是先诊断、再补动——先解决最痛的缺口。这个顺序,往往比「一上来就全面铺开」高效得多。
6.2.12 深讲:为什么「买不到的那层」才是护城河——经济学解释
「越难买的越值钱」这句话,很多讲义都提过,但没说透:为什么偏偏是买不到的那层,才构成了护城河?这一节用一个经济学视角把它讲明白。
护城河的本质,是「别人难以复制的竞争优势」。判断一样东西能不能成为护城河,关键看它是否满足两个条件:难以被复制,以及难以被买断。
| 层 | 能被复制吗 | 能被买断吗 | 成为护城河的潜力 |
|---|---|---|---|
| 排名 | 很容易 | 可以 | 低(人人可买,不构成差异) |
| 引用 | 较难 | 很难 | 中(需要积累,但可被稀释) |
| 信任 | 极难 | 不能 | 高(只认做,不认买) |
先看「难以被复制」。排名靠钱和技巧,只要你有钱有兴趣,随时能复刻同样的位置——大家都能复刻的东西,不构成差异。引用要复刻,得复制你的整条内容资产链和权威积累,成本高得多。而信任,是长在无数用户「一次一次被验证」之上的认知,几乎无法凭空复制。
再看「难以被买断」。你能买到别人手里的一张推荐位,但买不到用户心里的那个「信」字。信任的归属权永远不在市场,而在用户与时间的共识里。所以护城河的强度,恰好和保护层「能不能被买」成反比——越买不到,越抢不走,越值钱。
这个经济学解释,也再次印证本章反复强调的管理结论:把预算优先投向那两层「买不到」的东西,因为那是你不设防也不会被人偷走的资产。排名可以靠预算竞速,但护城河,永远只能靠时间与诚实来挖。
6.2.13 三层的计量:给每层一套看得见的打分方式
「能买多少」是预算问题,「能不能度量」是管理问题。这一节给「排名 / 引用 / 信任」各配一套可量化的参照,让你在向团队和老板汇报时,每层都有数据能讲:
| 层 | 怎么度量 | 常用参照指标 | 观测频率 |
|---|---|---|---|
| 排名 | 位置与曝光 | 关键词名次、收录量 | 快(可日看) |
| 引用 | 出现与评价 | 被引用次数、被怎么描述 | 中(每两周) |
| 信任 | 行为与口碑 | 复购、推荐、口碑、NPS | 慢(月/季) |
这里有个实用的三层评分法:每月给每层打一个 0-5 分。
- 排名分:按你能排到的高位比例打分,5 分 = 核心词稳定靠前;
- 引用分:按「被引用次数 + 描述是否正向」综合打分,5 分 = 多引擎稳定正面推荐你;
- 信任分:按复购率、口碑、净推荐值打分,5 分 = 用户愿意回头并替你说好话。
把三张分放进一张月度表,你就拥有了一张「品牌信息资产体检单」。哪层低、补哪层,方向一目了然,也天然满足管理层「要看到数字」的习惯。三层各有各的时钟——排名快、引用中、信任慢——别拿衡量排名的频率去等信任,也别拿衡量信任的耐心去迟迟不看排名,给每层配上对的观察周期,才是成熟的管理。
6.2.14 深讲:三层度量的「信号与噪声」——哪些数据会骗你
三层各有度量方法,但度量里最危险的事,是把噪声当成信号。以下三类数据最容易骗人,务必先学会识别:
| 假信号 | 看起来像什么 | 为什么会骗你 | 怎么识破 |
|---|---|---|---|
| 单次的高位排名 | 「我这次排第一了」 | 引擎改版、竞品改页、个性化等因素都会造成单次波动 | 连续两周、多个查询都稳定靠前才算数 |
| 单引擎的单次引用 | 「某 AI 提到我了」 | 一次作答受随机性影响大,可能是运气 | 固定问法多次采样,看出现率而非单次 |
| 一次性的负面提及 | 「AI 在批评我」 | 个别问题口径可能被特定信源带偏 | 换问法、换引擎复核,判断是孤例还是趋势 |
识别噪声的通用动作只有一个:固定问法、固定引擎、固定节奏,多次采样看趋势(采样口径的标准方法详见第 8 章)。凡是单次出现的,一律只当方向信号;凡是反复出现的,才当统计口径。用这个标准过滤一遍,你的三层评分才不会跟着噪声来回跳。
6.2.15 深讲:三层目标怎么分派给不同岗位
「排名 / 引用 / 信任」是三层不同的工作,天然适合分派给不同岗位协同推进。很多团队把三件事全压给一个人,结果每件都做不深。合理的分工是:
| 层 | 负责岗位 | 主责动作 | 验收标准 |
|---|---|---|---|
| 排名 | 技术 SEO / 增长 | 技术抓取、关键词覆盖、页面体验 | 核心词稳定靠前、收录正常 |
| 引用 | 内容团队 | 结构化内容、可核查事实、口径统一 | 固定问法下被引用率上升 |
| 信任 | 市场 + 客服 + 产品 | 口碑经营、真实评价、承诺兑现 | 复购率、推荐率、NPS 改善 |
这三条线要共享同一套「口径手册」(详见 6.8.3)作为底座,否则三线各写各的,引用层先崩。分工的意义不在于把三层割裂,而在于让每一层都有一个明确的负责人、一套明确的验收标准——这样每月复盘时,每一层的数字都能找到对应的责任人与下一步动作,而不是含糊地「整体推进」。
6.2.16 深讲:三层协作的正反例——「只补一层」为什么常翻车
三层的正确姿势是「诊断后补缺口」,但实操里最常见的翻车,是只盯着最顺手的那一层猛补,而忽视其他两层。看两个反例和一个正例:
反例一:只补排名,不补引用。某消费品牌在核心词上砸了大量预算,排名常年靠前,但用户问 AI「推荐某类产品」时,AI 从不提它。原因是它的内容毫无结构、不可抽取,AI 想引用也无从下手。排名带来的流量进站后,因为内容体验平平,转化依旧惨淡——钱花在了「看见」上,却没人给它「背书」。
反例二:只补引用,不补信任。某团队做了一批高质量、可抽取的内容,AI 开始稳定引用它,品牌词搜索量也上来了。但它的评论区、第三方评价里满是差评和投诉,AI 引用它时往往带着「口碑存疑」的表述。用户看到「有争议」三个字,转身就走——引用把人引来了,信任却没接住。
正例:按诊断顺序三层联动。另一家品牌的做法是:先诊断出「有曝光、有内容,但口径混乱、负面缠身」,于是先用两个月统一口径、处理差评(补信任),再上结构化内容(补引用),最后才谈排名加码。三个月后,AI 对它的描述从「存在争议」变成「口碑稳定的老牌」,引用率和转化同步上升——它先修了「说得不对」,才谈「被说得更多」。
三个例子合起来只说明一件事:三层是接力赛,不是选做题。在哪一层发力,取决于你诊断出的缺口,但补完一层之后,一定记得检查下一层是否接得住。只顾一层、不顾其他的「单腿战术」,往往是花钱最多、见效最差的那种。
6.2.17 深讲:「被引用」与「被信任」之间的时间差——为什么信任总是慢半拍
引用和信任之间,存在一个常被忽略的时间差:AI 可能因为你的内容结构而很快开始引用你(数周到数月),但用户对你的「信任」往往要慢得多(半年到数年)。不理解这个时间差,团队容易在两个方向上误判:
| 误判方向 | 表现 | 真相 |
|---|---|---|
| 过早失望 | 「都引用我了,怎么转化还是不行?」 | 引用是机器层面的认可,信任是人心层面的沉淀,后者天然慢 |
| 过早自满 | 「口碑不错,说明信任已经建起来了」 | 口碑是信任的一部分,但真正的信任要经过「复购 + 转介绍」验证 |
理解时间差的价值,是让你给「引用」和「信任」各设一套独立的验收时钟:引用层按季度看是否增长,信任层按年度看是否沉淀。别用「信任的慢」去否定「引用的快」,也别用「引用的快」去冒充「信任的达成」。当你把两个时钟分开走,你才不会在「被引用了很多但转化平平」的过渡期里,错误地砍掉正在积累信任的投入。
6.3 市场窗口期:答案不敢卖(🟠 高阶)
6.3.1 一个反常的事实:八大主流引擎都没有「AI 回答广告」
先看一个 2026 年初的实测事实。
把国内八家主流的生成式引擎摆在面前——它们各自侧重短视频生态、轻量问答、深度推理、长文处理、权威多源、搜索聚合、技术分析等不同场景(各家脾气详见第 8 章 §8.3 八引擎脾气总表)——去逐一翻它们的商业化产品线,你会发现一个耐人寻味的共同点:它们都没有正式上线的「AI 回答广告」产品。
什么意思?就是说,当 AI 给出那段推荐你的答案文本时,那里面没有明码标价的广告位。AI 推荐谁,纯粹是它基于内容与信任的判断,而不是谁出了钱。
这跟我们习惯了二十年的互联网大不一样。传统搜索里,付费置顶、竞价排位、搜索结果里的广告,是平台商业化的主力。而到了 AI 问答这个新物种身上,商业化最凶猛的那块,居然暂时是空的。
6.3.2 为什么 AI 不敢「卖答案」
「不敢」,是因为「不能」——这里面有一个根本性的商业权衡。我们把背后的三层逻辑拆开:
第一层:信任是 AI 的生命线。
用户用 AI 的前提,是「它为我好、不偏袒」。这句话听起来像废话,却是整个 AI 问答业务的命根子。一旦用户意识到「AI 是会收钱帮人说话的」,信任瞬间塌方——「原来你推荐的全是金主爸爸」,那这套工具和竞价排名还有什么区别?用户转头就走。
第二层:因此短期不碰广告。
引擎的管理层心里门儿清:宁可暂时不赚答案里的广告钱,也要守住「答案可信」这块招牌。因为一旦开了「答案里带广告」的口子,AI 的独特价值就被抹平了——它变成了一份更啰嗦的竞价排名清单,而这一块,用户有更便宜、更熟悉的替代品。
第三层:但商业化必然发生。
「不敢卖」不等于「永远不卖」。长期看,AI 一定会找到既不伤信任、又能变现的方式。比如「客观推荐 + 明确标注广告」「在答案底部挂生态内入口」「推荐里插入平稳的赞助商」——这些不破坏信任感的软性变现,才是理性演化的方向。
6.3.3 「无广告位的商场」到底意味着什么
现在,让我们把这三层逻辑翻译成对你的商业含义。这里有一个值得反复咀嚼的比喻:
眼下的网上信息市场,是一座「没有广告位的商场」。
传统商场里,最好的位置是要花钱买的——你花越多,货架的曝光越好,但所有人都知道那是钱堆出来的,没人真信。而眼前这座新商场,暂时还不设广告位。这意味着所有人都站在同一条起跑线上:只拼内容好不好、可信不可信,不拼谁兜里的钱多。
由此推导出三个关键判断:
| 判断 | 推理 | 行动含义 |
|---|---|---|
| 有机引用是最干净的竞争 | 没人和你抢付费入口 | 现在只拼内容质量与可信度,入门门槛最低 |
| 对从业者 = 窗口期 | 花内容的钱,就能占「被默认引用」的坑 | 此刻投入内容,性价比最高 |
| 机会成本会抬升 | 广告位一旦成熟,「被引用」就会变成「内容 + 预算」双轨竞争 | 现在不做,未来要付出更大代价 |
6.3.4 一个贯穿本章的推论
把上面三节串起来,就得到本章最值钱的一句推论:
有机引用正处「花内容的钱、占信任的坑」的最值钱窗口期。现在做 GEO,是在「还没有广告位跟你抢」的时候,把坑先占下来。
这句话请你反复读三遍。它的商业硬核在于:成本在当下,收益在未来,但未来的收益成本比,只会越来越差。
- 今天你花内容成本,就能让 AI 默认回答里提到你——这是用现在便宜的「内容钱」,换将来值钱的「信任坑」;
- 等广告位真正上线的那天,「被默认为该品类的答案」这个位置,就变成了「内容 + 预算」双轨竞争。你不仅要拼写得够不够好,还要拼出不出得起钱——机会成本立刻翻倍。
换句话说,你现在躲掉的,不是别人的竞争,而是未来的自己。
6.3.5 窗口期有多长?它会以什么方式关闭
理性地讲,我们无法给窗口期一个精确的倒计时——它取决于引擎的商业化节奏、监管环境和用户对 AI 广告的容忍度。但我们可以判断它关闭的「信号」:
| 信号 | 含义 |
|---|---|
| 某个引擎悄悄上线「AI 推荐标注广告」内测 | 商业化的口子开始试探 |
| 引擎官方发布「内容推广」/「生态内引流」产品 | 付费入口正式出现 |
| 社交讨论里出现「AI 答案全是广告」的抱怨 | 信任出现裂缝,但印证了变现在发生 |
| 你的品类里竞品开始能用钱买 AI 推荐 | 窗口期实质关闭 |
给你的行动命令(拨到处处都要有动词): 别等技术成熟、广告上线的那天再布局。此刻就把「被默认引用」「被认为是该品类的答案」的位置占下来。这是现在花内容成本就能换到的长期资产,等到要花钱买的那天,你可能已经买不起,或者已经不需要买了——因为你早就占住了。
6.3.6 深讲:窗口期的判断方法——别只等别人告诉你
「窗口期」这个词很好听,但从业者最怕的是听到的时候已经晚了。这一节给你一套可以自己动手判断窗口还剩多少的方法,别把判断权全交出去。
窗口期关闭的本质,是「能否用预算买到 AI 推荐」。所以判断窗口期,就在盯一个信号轴:这个品类的「被引用」是否已经从「内容兑换」退化成「预算兑换」。你可以在自己的品类里,定期执行三件事来打分:
| 判断动作 | 具体怎么做 | 看到的信号 |
|---|---|---|
| 盯竞品动作 | 观察同类目竞品是否开始用钱买 AI 推荐位 | 一旦有,说明口子已经打开 |
| 盯平台更新 | 关注引擎是否悄悄上线内测的推广产品 | 有内测通知,就是倒计时提示 |
| 盯用户感受 | 搜集用户对「AI 答案是否越来越像广告」的抱怨 | 抱怨多了,说明变现在发生 |
在此基础上,你并不需要等某一个「官方宣告」才算定窗口关没关。更实用的做法是设定你自己的「占坑里程碑」:不纠结「还有几年」,而是反过来问「我用 6 个月能占到什么程度的坑」。把窗口天数,转化成一份你手头有掌控力的时间表。
6.3.7 深讲:窗口期的机会成本量化——现在不做,未来贵多少
「机会成本会抬升」这句话很抽象,我们用数字把它变成可感知的。假设某品类「被 AI 默认引用」这个资产,现在可以用纯内容成本获得,未来变成「内容 + 预算」双轨竞争:
| 阶段 | 获得「默认引用」的主要成本 | 相对成本 |
|---|---|---|
| 窗口期(现在) | 内容生产(人力、创作) | 1 单位 |
| 双轨期(未来) | 内容 + 持续投放过预算 | 3~10 单位,且受竞价影响 |
为什么未来会贵这么多?第一,你要跟所有想进场的人竞价抢推荐位,价格由供给和需求共同推高;第二,你之前有窗口期占的坑也会被别人用预算抢,逼你不断加码防守;第三,晚入场意味着你的「信任资产」为零,纯靠现金硬砸,而现金能买到的那一层恰恰是最不持久的。
所以「现在不做更贵」不是一句口号,而是一条清晰的成本曲线:同样是获得「被默认引用」,你在窗口期花的内容成本,是你这辈子买到它的最低价。这不代表现在就必须孤注一掷,但它强烈提示——当你终于决定赌一把的时候,越早的那一注越划算。
6.3.8 窗口期的正反例:同样的问题,不同的进场时机
用一个对照帮你看清「同一种策略,不同进场时机」的天壤之别:
| 角色 | 进场时机 | 做的事 | 结果 |
|---|---|---|---|
| 某品牌甲 | 窗口期 | 持续做结构化、可核查的品类内容 | 用内容成本占据了「默认答案」,广告来了也抢不动 |
| 某品牌乙 | 双轨期 | 等广告位出现后才开始,用预算硬买推荐 | 既没内容资产打底,又要持续花大钱防守 |
甲的稳健源于「占坑在前」:他不止有了推荐位,还有了内容资产和信任做底座,就算未来要拼预算,他也已经站在比别人高的起点。乙的被动源于「追坑在后」:他没有先占比,等需要花钱时才发现,自己既要补内容的课,又要花预算去抢别人早就占住的坑,处处慢半拍、成本翻倍。
这个正反对照,给团队的最大启发是:别把 GEO 当成「等平台出广告再启动」的事,那等于把最便宜的先手机会主动让给了对手。窗口期的意义从来不是「马上冲」,而是「尽早占住那个注定值钱的坑」。
6.3.9 深讲:窗口期里,三类玩家的正确姿态
窗口期对所有玩家平等开放,但不同角色在窗口期里的「正确姿态」完全不同。我们按体量把玩家分成三类,各自梳理应对策略:
| 玩家类型 | 资源优势 | 天然短板 | 窗口期的正确打法 |
|---|---|---|---|
| 大品牌 | 预算足、信源广 | 决策慢、内容僵化 | 用预算快速铺量 + 定调口径 |
| 中腰品牌 | 有一定资源、较灵活 | 两不靠、易分散 | 聚焦一个品类做成默认答案 |
| 小品牌/新品牌 | 极灵活、敢聚焦 | 信源少、权威弱 | 打「细分领域的第一」,占冷门价位段 |
大品牌靠「速度和定调」取胜:它最怕的不是没资源,而是等太久,所以窗口期要给内容团队充分授权,快速统一口径、广泛铺稿。中腰品牌靠「聚焦」取胜:它比小而全、比大不慢,最适合在某个细分品类里做到「该品类的答案」。小品牌靠「细分第一」取胜:与其在红海品类里跟巨头硬碰,不如挑一个够窄、够痛、竞争少的问题,把它做到极致,成为这个冷门角落的默认答案。
这套「分角色打法」提醒你:窗口期没有统一的正确答案,只有匹配你体量的正确姿势。别学大品牌烧钱(你烧不起),也别学小品牌孤注一掷(你没必要)。找到你体量对应的那一格,把资源压进去,才是性价比最高的占坑方式。
6.3.10 深讲:不同品类的窗口节奏并不一样
还有一个常被忽略的事实:窗口期不是一刀切的,它在不同品类里会以不同速度关闭。把「抢坑的紧迫程度」排个序,对你决定先做哪块业务至关重要。
判断一个品类窗口剩多长的关键变量,是「这个问题被问得多不多、值不值得商业化」。越是高频、高客单、离交易近的措施,越被引擎盯着,越可能先被商业化、窗口越早关:
| 品类类型 | 特征 | 窗口节奏 | 建议优先级 |
|---|---|---|---|
| 高频 + 高客单 | 常被问、值得卖 | 关闭最快 | 最高优先级,尽快占坑 |
| 高频 + 低客单 | 常被问、不值得卖 | 中等 | 高,但收益有限 |
| 低频 + 高客单 | 少被问、但值钱 | 较慢 | 稳,可长期布局 |
| 低频 + 低客单 | 少被问、不值钱 | 最慢/基本不关 | 低,看资源再定 |
这条规律给出一条决策路径:先把资源投到「高频 + 高客单」的品类上,因为那里的坑既值钱、又最早被抢。至于低频低值的冷门角落,虽然竞争最小,但也最不值得花大钱去占。你要做的,是在「越值钱越抢手」和「越小众越没人抢」之间,找一个匹配你能力与野心的平衡点。
6.3.11 窗口期的监测仪表盘:用四个信号持续盯盘
前面给了判断窗口期的三个动作,这里再升级成一套可执行的「窗口期监测仪表盘」,让你像盯大盘一样,持续判断窗口是否在收紧:
| 信号 | 多久看一次 | 看到什么说明窗口要关了 |
|---|---|---|
| 竞品的付费动作 | 每周 | 竞品开始能花钱买 AI 推荐 |
| 引擎的产品更新 | 每周 | 出现「推广/引流」类内测或新品 |
| 用户对 AI 广告的吐槽 | 每两周 | 抱怨多了,说明变现在发生 |
| 自己品类的引用比 | 每两周 | 付费来源的推荐占比在上升 |
这套仪表盘的价值,是把「窗口期还剩多久」从看不透的玄学,变成一组可以定期盯的信号。你不需要预测得百分百准,只需要在自己品类的窗口真正关上之前,提前几周嗅到气味——那么剩下的时间,就够你做最后的占坑动作。尤其要记住:等你肉眼可见地发现「广告位出现了」,其实窗口已经关了很久。真正的先手,是提前在信号还不明显时就开始布局。
6.3.12 深讲:窗口期的「品类探测法」——怎么低成本试出自己的窗口
6.3.10 说过窗口节奏因品类而异,但那是「别人品类的规律」。怎么低成本地探测你自己的品类窗口还剩多少?这里给一套不需要花大钱的探测法,三步就能跑起来:
| 步骤 | 动作 | 判断口径 |
|---|---|---|
| 第一步:测被引用现状 | 用 3-5 个本品类的高频问题,去 2-3 个引擎问一遍,记录 AI 答案里提到哪些品牌 | 如果答案里品牌名密集、且有稳定出现者,说明该品类「答案席位」已经在成形 |
| 第二步:测内容门槛 | 把你自己的答案型内容做出来,复测同样的问题,看 AI 是否开始考虑你 | 一旦你的内容能被引用,说明这个品类「认内容不认预算」,窗口还在 |
| 第三步:测商业化动静 | 盯 6.3.11 的四个信号,重点看有没有竞品开始买 AI 推荐 | 一旦出现付费来源的推荐,说明这个品类的窗口开始关 |
这套探测法最值钱的一点是:它把「我该不该现在投入」这个抽象问题,变成了「三步各花一周就能有答案」的具体问题。如果探测结果是你这个品类窗口还很宽,那就从容地按季度布局;如果探测结果已经是「答案席位成形 + 付费动静出现」,那就立刻把节奏从「季度」提速到「月度」,优先占坑。
6.3.13 正反例:错过窗口的「事后复盘」——教训比经验更值钱
窗口期的教训,往往比经验更能改变行为。这里给一个「错过窗口」的复盘型案例,帮你把 6.3 的机制反过来验证一遍:
某中型教育机构在「某类学习问题」上原本有相当好的内容基础,团队也看到了「AI 答案里偶尔提到自家机构」的信号。但他们当时的判断是:「反正现在没人花钱买 AI 推荐,不着急,等平台出正式产品再说。」结果一年后,同品类的几家竞品陆续通过平台内测的推广产品拿下了「被推荐」的位置,AI 答案里的席位明显向它们倾斜。这家机构再想进场时,发现要么内容资产已经被「更早占坑 + 有预算」的对手稀释,要么需要付出比一年前高得多的成本才能挤进答案——它既丢了先手,又丢了便宜。
这个复盘的三个教训,值得反复对照自己:
- 「没人买」不等于「不会有人买」——窗口期最安静的时刻,恰恰是竞品在暗中布局的时刻;
- 「内容基础好」不等于「占了坑」——不主动测试、不主动占位,内容资产不会自动变成答案席位;
- 「等平台出产品」是最贵的等待——平台出产品之日,就是你用预算竞争之时。
教训的价值在于它不可逆:窗口一旦错过,追回来的成本是窗口期的数倍。所以 6.3.4 那句推论值得再读一遍——现在做 GEO,是用现在便宜的内容钱,换将来值钱的信任坑;而错过窗口,则是用将来数倍的价钱,去买一个本可以便宜占住的坑。
6.3.14 深讲:窗口期里的「内容占坑」具体占什么
「占坑」这个词说了很多次,但「坑」到底是什么,很多人其实是模糊的。把「坑」拆开,它其实由三层构成,每一层的占法不同:
| 坑的层次 | 占的是什么 | 怎么占 | 占错会怎样 |
|---|---|---|---|
| 答案层 | 让 AI 在回答里提到你 | 产出可抽取的答案型内容 | 占了个「连名字都不出现」的假坑 |
| 席位层 | 让 AI 在对比里把你列入候选 | 成为高信源平台的常驻内容 | 提到你但不推荐你,席位不稳 |
| 认知层 | 让用户把「品类 = 你」 | 长期一致的正面口碑沉淀 | 只有曝光没有记忆点,用户记不住你 |
三层坑的占法,难度逐层递增,价值也逐层递增。答案层是最低门槛的占坑,任何内容团队都能做;席位层需要你挤进 AI 的「候选池」,靠的是信源质量和被引密度;认知层则是最高级的占坑,它已经超出了 GEO 本身,进入品牌资产范畴——但那恰恰是窗口期最值得抢的「长期坑位」,因为一旦用户形成「品类 = 你」的联想,后来者用钱都很难扭转。
所以给「占坑」一个更准确的行动定义:占坑不是「发几篇内容让 AI 提你一下」,而是「依次把答案层、席位层、认知层三层坑位都占下来」。窗口期真正宝贵的地方,是这三层坑现在都还「只认内容不认预算」——等你只占完了答案层,却发现席位层和认知层已经可以被预算买走时,你才明白占坑为什么不嫌早。
6.4 参考案例:为什么「被说到」比「排第一」值钱(🟡 进阶)
6.4.1 案例一:精致 vs 可被引用
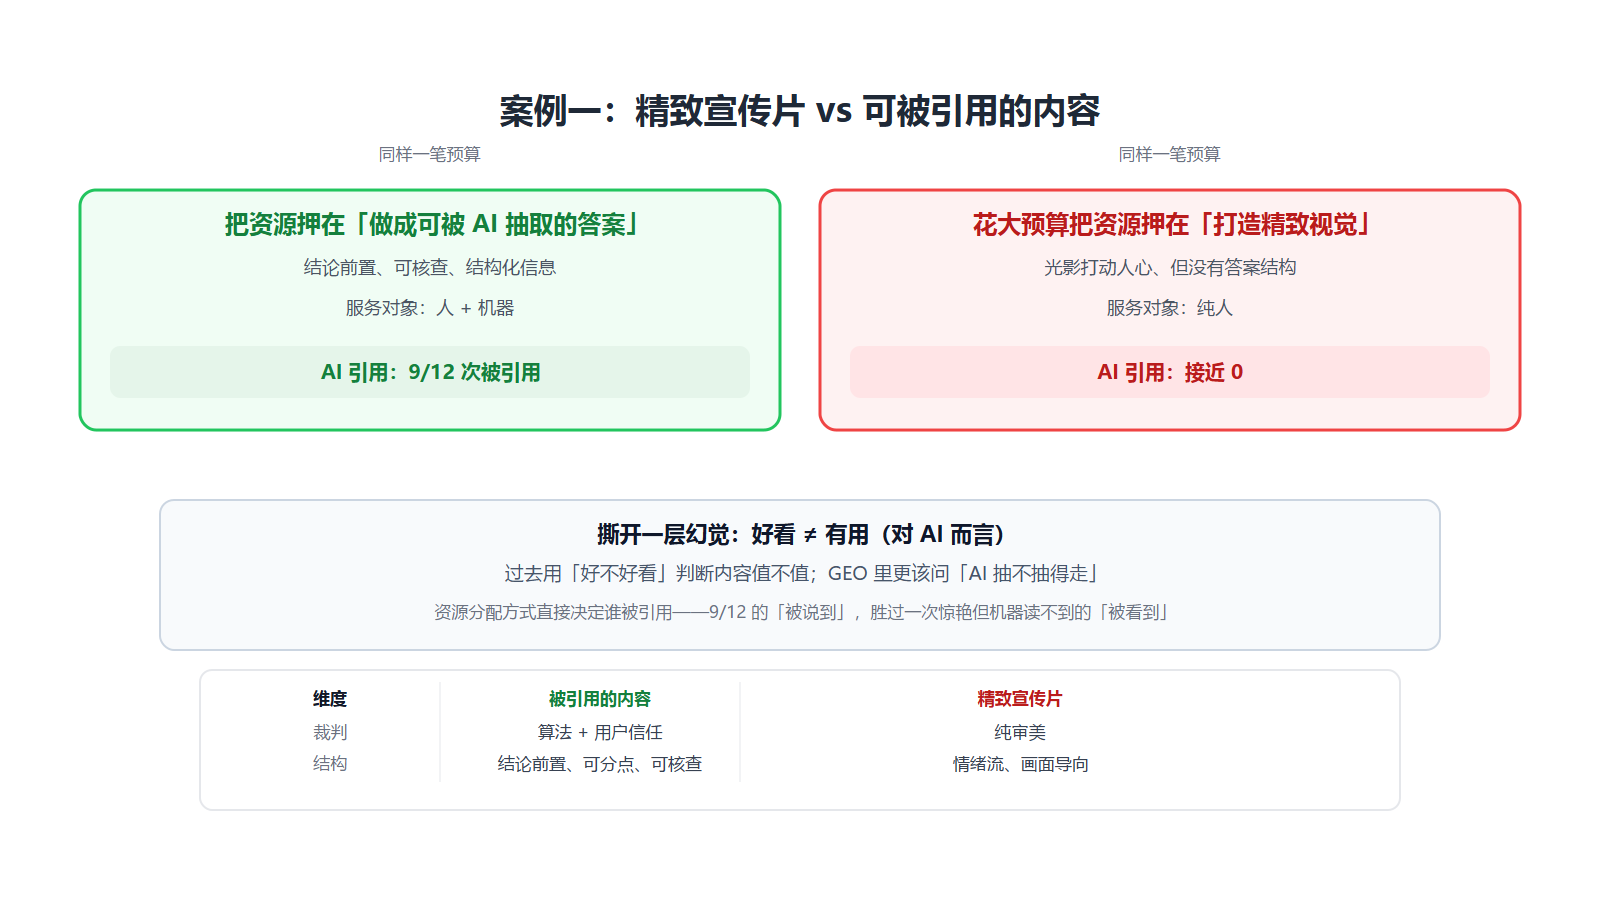
图 6-4 精致 vs 可被引用:同样是预算,做成「答案」的被 AI 引用 9/12 次,做成「视觉」的接近 0——好看不等于对 AI 有用。
有一个很能说明问题的小场景:某短视频平台的内容,被 AI 引擎在其相关提问中引用了 9/12 次——也就是在被抽样的 12 个回答里,它出现了 9 次。与此同时,它的竞争对手花了大笔预算,拍了一支制作极其精致的宣传片。
结果呢?那支精致的宣传片,几乎没被 AI 引用。
为什么?因为宣传片是拍给「人」看的,机器不引用。 AI 引擎要的是「可抽取、可核查、结构化的信息」,而不是一支光影打动人心、但没有答案结构的视频。对方把预算投入了「打造视觉」这条赛道,而其产品把资源押注在「做成可被 AI 抽取的答案」这条赛道上——资源的分配方式,直接决定了谁被 AI 引用。
这个例子撕开了一层幻觉:好看 ≠ 有用(对 AI 而言)。 过去我们习惯用「好不好看」来判断内容投入值不值;但在 GEO 世界里,更该问的是「AI 抽不抽得走」。
| 被引用的内容 | 拍得精致的宣传片 | |
|---|---|---|
| 服务对象 | 人 + 机器 | 纯人 |
| 结构化程度 | 结论前置、可分点、可核查 | 情绪流、画面导向 |
| AI 引用结果 | 9/12 次被引用 | 接近 0 |
| 给谁看的裁判 | 算法 + 用户信任 | 纯审美 |
6.4.2 案例二:一篇文章,成了「该品类的默认答案」
再看第二个案例:一家 B 端工具公司,没有花一分钱买 AI 推荐,只因为写了一篇东西——一篇「结论前置 + 对比表」的长文章。
这篇文章不是什么营销文案,而是一份信息密度极高、结构极清晰的行业内容:结论放在最前面,后面的正文用表格把各家方案的关键维度逐一对比,每个事实都带日期、可核对。结果,这篇内容被 AI 引擎在一系列相关提问中反复引用,它的品牌逐渐成了「提到这个品类时 AI 的默认答案」。
这是付费排名买不来的东西。 你花再多钱把某个词条买到第一,也换不来「AI 在段落里主动点名你、替你背书」这件事。因为排名是位置,引用是立场——位置可以买卖,立场不行。
6.4.3 这两个案例共同的三个启示
把两个案例摆在一起,你能提炼出三条可以复用的规律:
启示一:机器不看你「多好看」,看你能不能「被引用」。 精致的、情绪化的、缺乏结构的宣传素材,对 AI 是「不可读」的;而结构化、结论前置、带出处的内容,对 AI 是「可抽取」的。你花预算的方向错了,钱就打了水漂。
启示二:「被反复提到」是复利资产。 一旦你成为「某品类的默认答案」,每次用户问 AI、每次 AI 作答,都在免费为你背书。这个背书不花你的钱、不会消失、还越积越大——而且对手很难用排名付费把它买走。
启示三:资源分配决定命运。 同样一笔预算,投给「打造视觉」还是投给「做成答案」,决定了你被不被引用。这不是努力程度的差距,是方向选择的差距。
6.4.4 从「排第一」到「默认答案」:量变到质变
最后,用一个对照帮你看清这两个概念的时间尺度:
| 排第一 | 默认答案 | |
|---|---|---|
| 性质 | 某一次搜索的位置 | AI 长期反复的选择 |
| 心智 | 可能被超越的一次性光环 | 稳定的「该品类 = 你」的联想 |
| 时间维度 | 瞬时、易变 | 累积、复利 |
| 获取方式 | 抢(靠付费/技术/时机) | 守(靠一直被认可、一直被信) |
| 敌人 | 算法、竞品 | 误导信息、可信度滑坡 |
给你的启示:别只问「我的内容好不好看」,要问「AI 会不会引用我」。 这是从 SEO 思维切到 GEO 思维的关键分水岭。无数团队把精力花在打磨「让人眼前一亮的门面」,却忘了追问「让 AI 愿意开口推荐我的理由」——而后者,才是这座无广告位商场里唯一的硬通货。
6.4.5 深讲:被引用即资产的商业逻辑——它凭什么值钱
前面我们从资产三判定论证了「被引用是资产」,这一节我们落到商业上,回答更直白的问题:它凭什么值钱?值多少钱?
「被引用」值钱的第一个来源,是它把「一次性获客」变成了「一笔不用再花钱的分发」。传统广告,每触达一个新用户都要花一次钱;而一个被 AI 稳定引用的品牌,每次 AI 作答都在免费替它做一次推荐。这一次免费推荐,省下的是本要花出去的获客成本。这部分省下来的钱,就是引用资产的「当下现金流」。
第二个来源,是它降低了「成交链路里的信任阻力」。用户是听了 AI 的推荐才认识的你,等于 AI 已经帮你做完了「信用背书」这一环。同样的预算,买到的转化率从「0 信任起步」变成「带着信任沉淀起步」。信任阻力越低,成交率越高,同样的内容与渠道投入,回报就被放大了。
我们用一张表看它到底怎么变现:
| 引用资产的变现点 | 靠什么赚到钱 | 对应指标 |
|---|---|---|
| 省获客成本 | 免费被反复推荐 | 每次引用的估算价值 |
| 提转化率 | 带着信任被认识 | 被引来源的转化率 |
| 攒长期品牌 | 认知里「品类=你」 | 复购率、口碑、NPS |
| 形成类护城河 | 买不走、难抹除 | 竞品撼动你所需的成本 |
结论是:「被引用」的资产价值,等于「它持续免费省下的获客成本 + 它放大出来的转化增量 + 它沉淀出的长期品牌溢价」。三部分叠加,就是它值得你长期投入的理由。这个视角,把「被引用」从一个玄学变成了一个可以用现金去衡量的投资标的。
6.4.6 深讲:默认答案的复利机制——指数增长从哪来
「复利」这个词反复出现,这一节我们把它的增长机制真正讲透,让你知道它是怎么一点点滚起来的。
复利的核心是「增长本身参与再增长」。放到 GEO 语境里,链条是这样闭合的:
被引用 → 更多信源把你当权威 → 更多 AI 倾向于引用你 → 被引用次数上升 →(循环)
关键在于中间那个「更多信源把你当权威」。AI 并不是从零判断你的,它会参考大量既有内容之间的「交叉引用」——如果许多个彼此独立的内容都在认可你,AI 会推定你「确实值得被提及」。所以你被引用的次数越多,你身上「被认可的密度」越高,反过来吸引更多引用。这是一个自我强化的闭环。
用一个简单的数字模型来说明(仅作理解参考):
| 轮次 | 已积累引用 | 假设每次作答带来 10% 的增量 | 趋势 |
|---|---|---|---|
| 起步 | 10 | 缓慢增加 | 线性、吃力 |
| 中期 | 100 | 加速增加 | 开始起势 |
| 成形 | 1000 | 明显加速 | 进入指数区间 |
为什么起点又慢又难?因为复利的前段(从 10 到 100)完全是线性甚至停滞的,很多人就是在这一段放弃了,没等到复利真正起来。这解释了为什么 GEO 见效慢——它不是效果慢,而是复利的前段本来就隐忍。能做到「即使前三个月看起来没什么起色也不撤资源」的团队,才是真正吃到复利的人。
6.4.7 深讲:引用资产的折旧与维护——资产也会过期
资产不会只增不减。「被引用」作为一种资产,同样有折旧问题,值得我们清醒对待。
引用资产的折旧来自三个方向:一是信息过期,你的价格、服务范围、联系方式没更新,AI 引用到你陈旧的信息,反而伤你;二是口径漂移,不同时间、不同平台说的不一致,会让 AI 对你的可信度打折扣;三是竞争稀释,越来越多高质量的同类内容出现,分走了「该品类答案」的席位。
| 折旧来源 | 表现 | 维护动作 |
|---|---|---|
| 信息过期 | 被引到旧价格、旧范围 | 定期回写、标注日期、及时更新 |
| 口径漂移 | 各处说法不一 | 统一话术、建立口径手册 |
| 竞争稀释 | 引用席位被挤占 | 持续补高质量内容、维护口碑 |
所以「被引即资产」的完整版应该是:被引既是资产,也是负债——它值钱,但需要持续养护,一旦疏于维护,折旧速度快得超乎想象。这也呼应了 6.2.9 那条「向上很慢、向下很快」的规律:引用资产不是一劳永逸的存单,而是一块需要年年翻新维护的土地。
6.4.8 案例三:信任崩塌如何一夜之间伤人
前面的案例都在讲「做对了什么」,这一个案例讲「做错了什么」,它可能更值钱。
某平台企业曾长期靠优质内容,在 AI 答案里稳定出现,几乎成了该领域的默认答案。转折发生在一件事上:它被指存在数据方信息陈旧——AI 引用到的关键数据,早已是好几年前的过时版本,而此时这个数据已经被多方更新。接下来发生了什么?写出来的过程很典型:
- 第一步:AI 在引用它时,因为采信了过时数据,给用户造成了误导;
- 第二步:一旦「引用过时数据」这件事被反复验证,AI 开始对它的信任打折;
- 第三步:在同一问题的回答里,AI 明显降低了对它的引用频率,倾向于引用更新、更一致的替代来源。
这个故事说明一个残酷的事实:引用资产最怕的不是「你没被看见」,而是「你被看见了但站不住」。你辛辛苦苦积累的默认答案地位,可能因为一次没跟上的信息更新,就被一条「更可信的替代源」悄悄取代。这正是 6.4.7 讲「折旧」的现实注脚:资产需要养护,否则「被引即资产」会瞬间反转为「被引即负资产」。
6.4.9 四个案例的横向总结:被引用这件事的完整闭环
把 6.4 的四个案例(可被引用的内容、某篇文章成为默认答案、默认答案的复利、某平台因信息陈旧被冷落)放在一起,你就能看清「被引用」这颗硬币的两面:
| 案例 | 做了/没做什么 | 结果 | 揭示的机制 |
|---|---|---|---|
| 案例一 精致 vs 可被引用 | 押注可抽取而非好看 | 9/12 次被引用 | 机器只抽「结构」不抽「美感」 |
| 案例二 一篇即默认答案 | 做结构化、可核长文 | 反复被 AI 点名 | 结论前置 + 对比表即权威 |
| 案例四 复利机制 | 被认可的密度滚雪球 | 引用指数级上升 | 引用是自我强化的闭环 |
| 案例五 信息陈旧反噬 | 未及时更新关键数据 | 信任打折、被替代 | 资产不维护即负资产 |
合起来看,你得到了一句话:被引用是一座「进得来、也出得去」的城。进入靠的是「结构化、可核查、结论前置」;守住靠的是「一致性、可维护、口碑沉淀」;而一旦松懈,退出的速度和进入的难度完全不成比例。这只给你一个古老的提醒:进场靠聪慧,护城靠勤勉。
6.4.10 深讲:被引用的「五阶段」案例——一家 B 端公司从 0 到生态锚点
6.1.10 给过被引用的五阶段(空窗 → 偶尔出现 → 稳定出现 → 默认答案 → 生态锚点)。为了让你看清这条爬坡路的真实走法,这里给一个完整的五年样本,把每一阶段的「关键动作」和「转折点」都摊开:
| 阶段 | 时间 | 当时在做什么 | 关键转折 |
|---|---|---|---|
| 空窗 | 第 0-1 年 | 只做官网和几篇产品介绍,没人主动测过 AI | 团队开始用固定问法记录「AI 根本不提我」 |
| 偶尔出现 | 第 1-2 年 | 把核心产品页改成结论前置 + 对比表,补带日期的参数 | 部分问题下 AI 开始点名,但描述含糊 |
| 稳定出现 | 第 2-3 年 | 统一全网口径、上线行业问答栏目、邀请第三方评测 | 多个引擎多次稳定正面提及 |
| 默认答案 | 第 3-4 年 | 持续更新数据、维护口碑、盯引用看板 | 用户问品类问题,AI 默认把它列为候选 |
| 生态锚点 | 第 4-5 年 | 扩张到相邻品类,做行业方法论内容 | 其他内容、翻译、盘点文章开始引用它作参考 |
这个样本最值得读的不是结果,而是每个阶段的转折点都不是「突然变好」,而是「做对了那个阶段该做的事」。空窗期靠「建立基线」破局,偶尔出现靠「结构化 + 可核查」晋级,稳定出现靠「口径统一 + 背书」提纯……每一步都有明确的钥匙,这正是五阶段模型的价值——它不是描述性的,而是操作性的。
6.4.11 深讲:负面引用的处理 SOP——被 AI 说坏话时怎么办
被 AI 负面引用,是几乎所有做 GEO 的人迟早会遇到的事。处理负面引用,最忌讳的是「慌」和「删」。这里给一套可以照做的处理流程(SOP):
| 步骤 | 动作 | 判断与原则 |
|---|---|---|
| 第一步:核实 | 把 AI 引用的负面说法,逐个还原到信源,看是事实、误会还是造谣 | 没核实清楚前,任何动作都是盲动 |
| 第二步:分层 | 事实错误 → 修正口径;信息陈旧 → 更新数据;恶意造谣 → 保留证据、走平台流程;情绪差评 → 正常经营口碑稀释 | 不同性质,处理方式完全不同 |
| 第三步:修正 | 把被引用的「那个来源」先修正(你的官网/百科/第三方资料),再补充新的可核查事实 | AI 引的是来源,修来源才有效 |
| 第四步:复测 | 修正后,用固定问法复测,看负面是否消退、正面是否回升 | 引用变化有滞后,至少观察 2-4 周 |
| 第五步:复盘 | 把这次负面引用的成因写进口径手册,防止再犯 | 一次负面,胜过十次教训 |
处理负面引用有一条底线:绝不试图通过删帖、买水军、伪造正面来「抹平」——那会直接踩中 6.9.6 的信任边界,把一次小负面升级成一次信任崩塌。正确的姿态是:事实层面的问题立刻改,情绪层面的问题用时间稀释,而你要做的一切,都是让 AI 下一次引用你时,采信的是修正过的、更可信的版本。
6.4.12 深讲:被引用的行业差异——B2B 与消费品的打法完全不同
同样的 GEO 原理,落到不同行业,打法差异非常大。最典型的分野是 B2B 与消费品。很多团队拿着消费品打法去做 B2B,或者反过来,都会水土不服:
| 维度 | B2B 打法 | 消费品打法 |
|---|---|---|
| 核心问题 | 「选型类」问题:该选谁、怎么配 | 「体验类」问题:好不好用、值不值 |
| 关键信源 | 行业白皮书、对比评测、客户案例 | 测评平台、社媒口碑、开箱内容 |
| 内容形态 | 长文、对比表、方法论 | 清单、测评、短视频脚本 |
| 决策周期 | 长、多人决策、重可核查 | 短、个人决策、重情绪共鸣 |
| 引用价值 | 进「候选名单」就赢一半 | 被「点名推荐」直接影响购买 |
两条打法的分水岭,是「决策链的长度」:B2B 的采购是多人、多轮、重事实的慢决策,所以 AI 引用你时,「可核查、有数据、有案例」比什么都重要;消费品的购买是单人、快速、重感受的快决策,所以 AI 引用你时,「口碑一致、评价正面、特点鲜明」更关键。做 GEO 前先回答一个问题:我的用户是怎么做决策的?答案决定你该把力气花在「数据与案例」还是「口碑与特点」上。行业不同,最优解不同——这就是 GEO 最容易被「一视同仁」做坏的地方。
6.5 方法清单:把「被说到」落地成可评估动作(🟡 进阶)
前面的章节在讲「为什么」,这一节解决「怎么做」。核心思路一句话:把 GEO 的『被引用』从理念变成可观察、可评估的目标。
锦上添花,不过,方法论切忌贪心。入门级不需要一开始就做全套审计,先抓住最要紧的几步,建立感知。
6.5.1 第一步:先建立「被 AI 怎么说」的基线
📷 截图 TODO(待手工补图):此处需补 1 张截图——"建立基线的真实界面":你用一个问法在某 AI 引擎里提问、得到引用了你/没引用你的回答(可打码),作为监测看板的示例帧。补图后放在本节下方并标注图注。
没有基线,就无法谈「变化」。这是任何测量体系的常识。
怎么建基线? 用几个「品牌名 + 品类」的问法,去 2-3 个不同的 AI 引擎里提问,然后把回答原样记录下来(文字存档或截图)。这组记录,就是你的「零时刻」快照——它是你日后所有优化的参照物。
| 关键动作 | 说明 | 误区 |
|---|---|---|
| 选 2-3 个引擎 | 覆盖你目标用户最常用的平台 | 只测一个引擎,视野太窄 |
| 固定问法 | 「品牌名 + 品类」「品牌名 + 口碑」「品牌名 + 价格/对比」 | 每次换问法,无法横向比较 |
| 记录原文 | 保留 AI 回答的原话和引用来源 | 只看「有没有出现」,不看「怎么说的」 |
| 标时间戳 | 每次实测都写日期 | 不加日期,后期无法对比趋势 |
6.5.2 第二步:分清「有没有出现」和「怎么被描述」
基线建好后,第一件事是把问题拆成两个层次:
- 第一层:AI 有没有提到我?(0/1 问题,回答「出现」还是「没出现」)
- 第二层:AI 是怎么描述我的?(质量分问题,回答「正面/负面/中性」「准确/失真」「可核查/含糊」)
这两个层次,对应的是完全不同的解决方案:
| 现象 | 可能的病根 | 对症动作 |
|---|---|---|
| AI 完全没提到你 | 信源没有覆盖/权威性不足 | 补充内容、铺设可信信源 |
| AI 提到你了,但措辞消极 | 口径与用户真实评价不一致 | 统一话术、修正口径 |
| AI 提到你了,但信息错误 | 事实信息陈旧/矛盾 | 核对并更新带日期的事实 |
| AI 提到你了,但描述含糊 | 关键信息不可核查 | 把口径写清楚、可核对 |
很多人犯的错误是只统计「出没出现」,把 1/0 当成了全部。 别忘了 6.2 的老话:出现是 0/1,怎么描述才是质量分。同样被提到,「一家靠谱的服务商」和「这家争议很大」是天壤之别。
6.5.3 第三步:让关键口径可见、可核查
为什么 AI 那么容易信「带日期的、可核对的」内容?因为引擎最忌惮的,就是喂给用户错误的事实——那会毁掉它的信任生命线(还记得 6.3 吗)。所以,你的关键事实越「可核查」,AI 越倾向于在答案里引用你。
把注意力集中在「事实型」信息上:
- 价格:写清楚「有效期」,避免陈旧价格误导;
- 服务范围 / 覆盖地区:明确「截至某时间」的范围;
- 联系方式 / 办公地址:真实、连续、全网一致;
- 产品能力边界:说清楚「能做什么 / 不做什么」,避免含糊。
这一条听起来简单,却是入门者最容易忽略、也最容易见效的抓手。信息不一致,是 AI 引用你的第一杀手——你官网、官方博客、百科、第三方评测各说各话,AI 根本不敢采信任何一个。
6.5.4 第四步:别把 GEO 当「买量」
这可能是全节最需要给管理层讲清楚的一句话:
GEO 不是买量,它是内容资产与可信度的累积。效果非即时,但复利、可持续。
为什么必须给管理层建立正确预期?因为「投广告见效快」的惯性太强了——老板今天投 10 万,下个月就想看到回报。但 GEO 走的是另一条钟表:它不是「花钱买曝光」,而是「种树等结果」。 你今天种下的结构化内容、统一的口径、可核查的事实,是在为三个月、半年后的「被 AI 反复引用」铺路。
| 认知误区 | 正确认知 |
|---|---|
| 「GEO 花钱就见效」 | 内容是累积的,效果有延迟但更长 |
| 「一道内容就够」 | 需要持续的内容资产池 |
| 「GEO 跟 SEO 互斥」 | 它们地基相同,GEO 是升维 |
| 「看一个月数据就定去留」 | 至少要按季度看趋势 |
6.5.5 一张可复用的入门自查清单
把上面四步浓缩成一份给团队用的入门清单:
- ✅ 你是否已有一份「品牌 × 品类」的 AI 亮相基线记录?(含日期、引擎、原文)
- ✅ 你能否区分「AI 没提你」和「AI 提了你但说得不好」两种情况?
- ✅ 你的关键事实信息(价格/范围/联系方式/能力边界)是否带日期、可核查、全网一致?
- ✅ 管理层是否理解「被引用 ≠ 买排名」,并且愿意给内容足够的累积周期?
- ✅ 你是否每月回看一次基线,观察「被引用」和「被怎么描述」的变化?
这条清单不需要一次性全做到满分。先做到 1、2 两项(建基线 + 分清两种问题),你就已经跑赢市面上 90% 没入门的团队了。
6.5.6 可付费盘点:哪些钱值得花,哪些是打水漂
GEO 常被误以为「不花钱」,其实它也要花钱,只是花的方向完全不同。这一节给你一张「可付费投入」的盘点表,帮你分清哪笔钱是资产、哪笔钱是浪费:
| 花钱方向 | 实际产出 | 判断 |
|---|---|---|
| 内容生产(深度、结构化) | 可被引用的基座 | ✅ 真资产,最该花 |
| 行业数据/报告采购 | 增强可核查性 | ✅ 辅助,有价值 |
| 权威第三方背书获取 | 间接信任 | ⚠️ 花钱只能买「接触」,买不到真信 |
| 一次性刷屏式宣传 | 短时曝光 | ❌ 对引用几乎无效 |
| 押注「保证被所有 AI 引用」的服务 | 物理上不存在 | ❌ 直接拒绝 |
判别的核心标准是一条红线:凡是承诺「花 N 万保证被多少 AI 引擎引用」的,一律拉黑。引用是基于内容与信任的长期结果,不是可以用预算「一键开启」的功能。真正值得花的钱,是能转变成「内容基座」和「信任沉淀」的钱——它们才能进入复利循环。
6.5.7 工具与追踪:把「被引用」变成能持续看的看板
GEO 流程化之后,需要一个可重复的观测动作。这里给你一套轻量追踪框架,不需要复杂工具,就能把「被引用」变成一张天天能看的看板:
| 观测维度 | 具体字段 | 记录要点 |
|---|---|---|
| 是否出现 | 出现 / 未出现 | 每次测试都记录,形成 0/1 序列 |
| 怎么被描述 | 评价倾向、准确度 | 是推荐、中性,还是甚至带着负面 |
| 上下文语调 | 正面 / 负面 / 中立 | 决定「出现」到底是资产还是负资产 |
| 引用的源 | 来自你哪个内容 | 反推哪块内容最被采信 |
| 时间 | 每次的日期 | 唯一能让你看出趋势的字段 |
把每一次实测的结果累计起来,就形成了一个你专有的「引用追踪看板」。它不需要多花哨,一张表、固定问法、固定引擎、固定时间节奏(建议每两周一次)就够。长期坚持后,你能清晰看到:哪些内容在起效、哪些引擎最认可你、哪些信号在改善。能看见趋势的方法,才配叫方法——这套看板就是帮你把 GEO 从感觉,变成数据。
6.5.8 陷阱避坑:最容易把钱和时间一起浪费掉的三个坑
光知道「该做什么」不够,还得知道「别踩什么」。这里列出入门阶段最容易踩的坑,帮你绕开:
| 陷阱 | 表现 | 避坑动作 |
|---|---|---|
| 只问「有没有出现」 | 把 0/1 当全部,忽略怎么说 | 把「怎么被描述」也纳入统计 |
| 每两周换一次问法 | 数据无法横向比较 | 固定问法,只换引擎做对比 |
| 到处铺量、内容互相矛盾 | 口径混乱,反伤可信度 | 先统一口径,再谈铺量 |
这三个坑背后是同一个病根:把 GEO 当成了「动作」而非「体系」。真正有效的 GEO,是先把基线、口径、追踪这三根柱子立稳,再谈扩张。否则你越努力,越快在混乱里把预算和口碑一起浪费掉。
6.5.9 月度复盘:把 GEO 变成一份能持续汇报的工作
做 GEO 最怕的是「一阵忙碌,然后没人复盘」。把前面所有工具串起来,这里给出一份可以直接套用的月度复盘模板,让你每月有节奏地看一次、汇报一次、调整一次:
| 复盘环节 | 要回答的问题 | 输出 |
|---|---|---|
| 看趋势 | 这月被引用次数 vs 上月,是升是降 | 趋势线 |
| 看质量 | 「怎么被描述」是否从负面/中性转正向 | 质量分变化 |
| 找病根 | 降了、含糊、带负面,问题出在哪 | 待改清单 |
| 定动作 | 下个月改哪一处(一次只改一个变量) | 下月计划 |
| 对老板 | 用「省下的获客成本」讲价值 | 汇报页 |
这份复盘的价值,在于它让 GEO 第一次变成「像广告一样可管理、可向老板交差」的工作。它不需要多复杂,固定的问题、固定的节奏、固定的记录,足以让团队对 GEO 有掌控感,也让老板看得见「钱投进去在往哪里长」。复利的前提是时间,而时间的前提,是这套能让你每月坚持下去的复盘机制。
6.5.10 问法设计的四个心法:让你的基线真正可比
基线里最容易被低估的,是「问法」本身的设计。问法设得对,可比性才有保障;设得随意,整条基线都是废的。这里给你设计问法的四个心法:
| 心法 | 具体做法 | 反例 |
|---|---|---|
| 问「品牌 + 品类」 | 让 AI 有语境判断你是谁 | 只问品牌词(太宽)或只问品类(太泛) |
| 问「品牌 + 对比」 | 覆盖你被不被拿来比较 | 从不问对比,看不到被选或没被选 |
| 问「品牌 + 口碑」 | 看你怎么被评价 | 从不问口碑,看不到负面或含糊 |
| 问得稳定 | 同一套问法反复用 | 每次都新造句,无从比较 |
核心就一句话:问法要能「稳定地暴露你想要的信号」。品牌 + 品类,暴露「你被不被认识」;品牌 + 对比,暴露「你被不被选」;品牌 + 口碑,暴露「你怎么被评价」。三条问法分别对应排名的三块,缺一不可。把问法固定下来后,任何一次实测,你都清楚它是在测哪一块,数据才有归属感。
6.5.11 深讲:基线记录的「字段设计」——一页可复制的表格
「建基线」听起来抽象,落地时其实就是一张表。这里给出一份可以直接照抄的基线记录字段表,把「记录什么」一次说清,避免你建完发现缺字段、后期补不齐:
| 字段 | 填什么 | 为什么要这个字段 |
|---|---|---|
| 日期 | 实测当天的年月日 | 唯一能支撑趋势对比的时间锚点 |
| 引擎 | 用的是哪个引擎(含版本/入口) | 不同引擎结论不可混比 |
| 问法 | 原样保留完整问句 | 复测时必须用同一句 |
| 是否出现 | 出现 / 未出现 | 0/1 序列,算出出现率 |
| 出现形式 | 点名 / 推荐 / 对比提及 / 负面提及 | 判断「怎么被说」 |
| 被怎么描述 | 原样摘录 AI 对你的一句话评价 | 质量分的原始证据 |
| 引用的源 | 你哪个内容/页面被引用 | 反推哪块内容最被采信 |
| 结论倾向 | 正面 / 中性 / 负面 | 决定「出现」是资产还是负债 |
这份表有两个使用要点:一是「原样」二字——出现形式、被怎么描述、引用的源这三列必须原样记录,不许润色,否则基线就失真了(呼应 6.7.3 的坑 9);二是「固定」二字——问法和引擎一旦定下来就不要频繁更换。一张填满三四十行的基线表,就是你判断「GEO 到底起没起效」最硬的证据。它不漂亮,但足以让你在老板面前说话有底气。
6.5.12 深讲:不同体量团队的 GEO 落地节奏
「建基线、做内容、统一口径」这套方法,不同体量的团队做起来节奏完全不同。这里按团队规模给三套参考节奏,避免「照搬大厂打法把自己累垮」或「用个人节奏拖慢团队」:
| 团队规模 | 核心打法 | 频率建议 | 别做什么 |
|---|---|---|---|
| 1 人(个人/小团队) | 只挑 1 个品类、1-2 个引擎、3 个问法,做深不做广 | 每月测 1 轮、每季复盘 1 次 | 别一次铺 5 个平台,也别同时盯 5 个引擎 |
| 3-5 人(内容小组) | 固定 2-3 个品类,分工:口径守门 / 内容生产 / 记录复盘 | 每两周测 1 轮、月度复盘 | 别让内容生产跟记录复盘是同一个人(数据会「好看」) |
| 10 人以上(专职 GEO 组) | 可覆盖多品类、做窗口期监测仪表盘、跑对照实验 | 每周看仪表盘、每两周复测 | 别为了「仪式感」堆指标,指标要能导向动作 |
三套节奏背后是同一条原则:节奏要匹配「你能稳定投入的人力」,而不是「你想达到的目标」。1 个人的团队按 10 人团队的频率跑,两周就累垮;10 人团队按 1 人团队的频率跑,三个月看不出变化。把「稳定」放在「激进」前面,是 GEO 落地节奏的第一铁律。
6.5.13 深讲:问法设计的「场景化」进阶——别只会问「推荐什么」
6.5.10 讲过问法四心法,但那只覆盖了最基础的「品牌 + X」型问法。到执行阶段,你会发现真实用户的问法千奇百怪,而不同问法暴露的信号完全不同。进阶的做法,是按「用户决策场景」设计问法矩阵:
| 场景 | 典型问法 | 暴露的信号 | 对应动作 |
|---|---|---|---|
| 初步认识 | 「什么是某类产品?」 | 你被不被当作品类代表 | 有没有可被抽取的定义型内容 |
| 比较选择 | 「某品牌和某品牌怎么选?」 | 你被不被列入候选 | 对比型内容是否覆盖 |
| 负面排查 | 「某品牌有什么坑?」 | 负面信息占不占上风 | 负面是否被正面稀释 |
| 决策收口 | 「小团队该选哪个?」 | 你是不是那个「被推荐答案」 | 结论是否前置、建议是否明确 |
这四类问法的价值,是让你从「AI 提没提我」升级为「AI 在用户决策的哪一步提我」。同样是「被提到」,在「初步认识」环节被提(只是科普提及)和在「决策收口」环节被提(被直接推荐),商业价值天差地别。所以,问法矩阵要按「决策链路」来配:每一层都要有对应的问法去测,才能看清你「在哪一步存在、在哪一步缺席」。基线记录做得细的团队,能把「决策链路里哪一环塌了」精确到具体一个问法——这比笼统的「引用率上升了」有用得多。
6.5.14 深讲:内容「可引用化」的改造顺序——先改哪篇最划算
团队手里往往有一堆旧内容,全都改一遍既缺人力、又看不到重点。正确的做法是按「引用杠杆」排序,先改最划算的那几篇。判断一篇内容值不值得优先改造,看三个杠杆:
| 杠杆 | 判断问题 | 高杠杆的迹象 |
|---|---|---|
| 主题杠杆 | 这篇内容对应的问题被问得多不多 | 是本品类高频问题、且已有被引用迹象 |
| 结构杠杆 | 内容本身离「可抽取」还差多远 | 已有结论、只差前置;已有数据、只差标日期 |
| 位置杠杆 | 它是不是 AI 已经引用的那个源 | AI 已经引到这篇(哪怕是旧版本),改造立刻见效 |
排序逻辑很简单:主题高频 × 结构接近 × 已被引用,三者权重叠加,得分最高的先改。反过来,一篇冷门主题、结构完全不可抽取、也从未被引用的旧文,优先级应该垫底——先放着,等核心内容改造完再回头。改造顺序的本质,是把有限的改造人力投到「AI 最容易因为你的改造而改变答案」的地方——同样的改造工时,投在「已被引用但信息陈旧」的页面上,比投在「从未被引用的冷门页」上,见效快得多。
6.6 思考与练习
如果前面的内容你看懂了,那么下面这些练习会把「看懂」变成「会做」。请按难度选择适合自己的那一级。
这套练习刻意把「认知」「实操」「推演」分成三档:入门档不要求你有任何内容权限,先把概念彻底想通;进阶档需要你能接触一线的内容与数据,把方法真正落地一遍;高阶档则面向想带团队或写方案的人,要求你把它放到更大的棋盘上推演。不必急着全做,从你当下最匹配的一档开始,能完成 2-3 道,就说明本章已在你脑中成立了。无论选哪一档,都建议最终用一句「我能向别人复述的核心」,来检验自己是否真的掌握了本章。
6.6.1 🔵 入门档 · 认知理解(适合所有人,先想清楚再动手)
- 用「排名 / 引用 / 信任」三层,分析你现在(或你熟悉的)品牌最缺的是哪一层?为什么? - 提示:缺「排名」→ 还无人问津;缺「引用」→ 有曝光但 AI 不选你;缺「信任」→ 有曝光也有人看了,但转化差。
- 为什么国内主流引擎暂不敢卖「AI 回答广告」?这对你意味着什么? - 提示:答案要落到「窗口期」和「无广告位的商场」上。
- 说出「排第一」和「默认答案」的本质区别(至少要答出「位置的瞬时性 vs 引用/信任的复利性」)。
- 用一句话解释「SEO 抢货架、GEO 搞定导购员」这个类比,并各举一个你身边的例子。
- 说出「被引用」能被称得上「资产」的三个理由(可持续、可累积、难抹去),并举一个你熟悉的反例——什么东西看起来值钱但其实构不成资产。
- 如果有人承诺「花一定预算,保证你的品牌被所有主流 AI 引擎天天引用」,你如何判断这是真话还是骗局?(提示:回到 6.5.6 的可付费红线。)
- 用 6.3.11 的「窗口期监测仪表盘」,为你所在的品类列一份「近期要盯的信号清单」,并判断:如果明天看到其中两个信号同时出现,你会先采取哪一步,为什么?
6.6.2 🟡 进阶档 · 动手实操(建议有内容权限的从业者完成)
- 立刻做一份「品牌 × 品类」的 AI 亮相基线记录: - 选 3 个问法(品牌词、品牌 + 口碑、品牌 + 价格/对比); - 去 2-3 个不同类型的主流 AI 引擎分别提问; - 记录每一条回答的「出没出现」「怎么被描述」「引用了哪些源」「日期」。 - 完成即算入门达标,把它当作你后续所有 GEO 动作的锚点。
- 把公司的「价格 / 服务范围 / 联系方式 / 能力边界」四类事实,逐条标注上「是否带日期、是否可核查、全网是否一致」,找出不一致项并修正。
- 判断下面 6 个动作分别属于「SEO 思维」还是「GEO 思维」,并说明理由:买外链冲名次/把 FAQ 结构化/堆关键词/做带对比表的行业白皮书/砸广告买曝光/统一全网口径。(可对照 6.2.5 的表格核对。)
- 用 6.5.7 的框架,为你的品牌建立一张「引用追踪看板」,固定至少 3 个问法和 2 个引擎,连续两周做基线记录,并分析第一周和第二周有何变化或异常。
6.6.3 🟠 高阶档 · 进阶推演(适合想面试、带团队或写方案的人)
- 请推演:如果某天主流引擎真的上线了「AI 答案广告位」,你现在该提前准备什么,才能让「机会成本」降到最低?(提示:回到 6.3 的「占坑」逻辑。)
- 为什么「被引用的拍照」需要用「固定问法 × 多引擎」来设计?它背后的测量学逻辑是什么?(提示:控制变量 + 横向可比。)
- 综合本章,写一段 200 字以内的话,向非技术背景的老板解释「为什么要现在投内容做 GEO」,务必包含:无广告位窗口、引用 vs 排名、复利资产三个要点。
- 结合 6.2.9 的「向上很慢、向下很快」,为一个已经建立起一定引用资产的品牌,设计一套「防崩塌」预案:未来三个月你分别要盯哪些信号、做什么动作来守住信任?
- 用 6.4.6 的复利链条,为你的品类设计一个「默认答案」的三年路线图:分阶段设定引用数量的里程碑,并说明每个阶段要重点补哪块积木(一致性 / 可核查性 / 背书)。
- 「被引用既是资产,也是负债」这句话如何理解?请用你真实业务里的一个场景,说明引用资产在什么情况下会反过来伤你。
- 用 6.2.13 的三层评分法,为你自己的品牌连续打三次分(相隔两周各一次),画出「排名 / 引用 / 信任」三分的趋势,并据此写一条下一步的动作建议。
- 结合 6.5.10 的问法设计心法,设计一套「覆盖认识、对比、口碑」的三问法基线,并解释每个问法分别测的是三层里的哪一层。
6.7 陷阱避坑:新手最容易踩的十个红灯(🔵 入门)
前面各节已经把「该怎么做」讲得比较充分了,但真正决定你成败的,往往不是「多做一步」,而是「少踩一个坑」。这一节把全章散见的红线集中成一册,做成一份可以直接照读的避坑手册。
6.7.1 认知层的坑:先想错,再所有动作都错
坑 1:把 GEO 当成「全网铺量的加速器」。很多团队以为,把同一篇文章发到几十个平台就叫 GEO。真相是:铺量只解决「覆盖面」,不解决「被采信」。量铺得再大,如果内容互相矛盾、口径不一,AI 反而因为「信息不统一」而不敢信你。先做深,再做广;先统一,再扩张。
坑 2:把「被提到」等同于「被推荐」。被提到不等于被夸。AI 可能因为你的一条负面信息而提到你。所以统计的时候一定要分「出现」和「怎么被描述」两层——出现是 0/1,怎么被描述才是质量分(回到 6.5.2)。
坑 3:用「月报」衡量一个「季度级」的东西。GEO 见效慢,前面讲过,那是复利前段的隐忍,不是效果差。老板看了一个月没起色就撤资源,等于在复利刚要起来的临界点前撤了梯子。
6.7.2 内容层的坑:把「可核对」写成了「不可信」
坑 4:价格信息不写有效期。AI 最怕喂给用户错误事实。一个没有到期日的价格,会让 AI 认为你的信息不可靠,转而引用你的竞品。把「价格有效期」写得清清楚楚,是成本最低的信任加分项。
坑 5:口径在官网、百科、第三方之间互相打架。信息不一致是「AI 引用你的第一杀手」——各说各话,AI 索性别采信。用口径手册把关键事实固定下来,全网统一。
坑 6:追求「华丽」而牺牲「可抽取」。记得 6.4.1 的那个宣传片吗?机器不引用拍给「人」看的情绪流内容,只抽取「结论前置、带结构、可核查」的东西。内容可以做得漂亮,但先保证它「抽得走」。
6.7.3 操作层的坑:把「基线」做成了「废纸」
坑 7:每次实测都换问法。固定问法是横向比较的命根子,三天两头换问法,数据完全不可比,等于白测。
坑 8:只测一个引擎。你的用户分布在多个引擎上,只看单一引擎,视野过窄,容易得出错误结论。至少测 2-3 个不同类型的主流引擎。
坑 9:为了「好看」改动原始记录。基线是参照物,一旦篡改,整个对比体系就塌了。记录错了就重测,别去「修」旧数据。
坑 10:买「保证被所有 AI 引用」的服务。这条红线值得再重复一次:引用是内容与信任长期作用的结果,物理上不存在「花钱一键开启」的功能。谁承诺这个,谁就是看在你好骗的分上给你挖坑。
6.7.4 一张「红灯自查表」
| 检查项 | 红灯表现 | 绿灯动作 |
|---|---|---|
| 认知 | 把铺量当 GEO、把提到当推荐 | 先做深再做广、区分出现与评价 |
| 定价 | 价格没有有效期 | 写清价格有效期、可核对 |
| 口径 | 各处说法不一致 | 统一话术、建立口径手册 |
| 内容 | 只追求好看、不可抽取 | 结论前置、结构化、带出处 |
| 测量 | 换问法、只测一引擎、篡改记录 | 固定问法、多引擎、原样留存 |
| 预算 | 坚信花钱能保证引用 | 只买内容基座和信任沉淀 |
6.7.5 更隐蔽的坑:看似「没做错」其实在伤资产的五件事
上面十个坑比较显眼,这里再列五个更隐蔽的坑——它们表面都「很合理」,但都在悄悄侵蚀你的引用资产:
| 隐蔽的坑 | 为什么危险 | 纠正做法 |
|---|---|---|
| 只追热点、不补沉淀 | 热点内容是「一次性的」,留不下资产 | 热点为辅,长期内容为主 |
| 好内容不注重更新日期 | 信息一旦过期,AI 不敢采信 | 关键内容标注并维护更新时间 |
| 获奖/证书铺得杂乱无章 | 权威信号散乱,反而不可核 | 把资质集中、结构化地呈现 |
| 不同团队各写各的稿 | 口径自然漂移,彼此打架 | 统一由口径手册约束 |
| 只看「新内容」不看「旧内容」 | 旧的过期内容持续在伤你 | 定期盘点、更新历史关键页 |
这五个坑的共同特征,是它们都发生在「你自以为在认真做 GEO」的时候。恰恰是这种「自我感觉良好」,比明显的懒散更具杀伤力——因为它让你在不知不觉中,亲手磨损那块买不走的信任资产。把它当成一份「周度巡检清单」,每周扫一遍,能帮你省下未来一年修补资产的成本。
6.7.6 深讲:避坑的「灰度测试」思路——怎么安全地试错
避坑清单再全,也不可能覆盖所有情况。真正成熟的做法,是掌握一套「灰度测试」的试错姿势——在动作还没造成大代价前,先用小规模、可回退的方式验证它。这套思路对 GEO 尤其重要,因为它处理的都是「会累积」的资产,错了就很难回头:
| 试错场景 | 直接蛮干 | 灰度做法 | 安全回退点 |
|---|---|---|---|
| 改品牌口径 | 全网一次性改口 | 先改官网 + 百科两处,复测 AI 一周 | 有负面变化就回滚,再考虑口径本身 |
| 上马新问法 | 直接替换旧问法 | 新旧问法并行两周,对比数据可比性 | 新问法数据不可比就弃用 |
| 换内容风格 | 整站重写 | 先拿 2-3 篇核心内容试新风格 | 引用率不升反降就改回 |
| 引入新引擎 | 全面铺开所有引擎 | 先测 1 个新引擎、固定 2 个问法 | 没增量就暂缓投入 |
灰度测试的三条铁律:小步(一次只动一个变量)、可回退(改动前留好旧版本)、带对照(同时保留旧做法做对比)。这和 6.8.1 的「每次只改一个变量」是同一套纪律——GEO 的资产太贵,禁不起「一次动三个变量、出了事不知道怪谁」的折腾。会灰度试错的团队,能把「踩坑成本」压到最低,而把「验证速度」提到最高。
6.7.7 深讲:避坑的「复查频率」——哪些坑要天天看、哪些季度看
避坑清单里的事项,紧急程度完全不同。把它们一股脑塞进「每周巡检」,既累又低效。合理的做法,是按「伤害速度」给不同的坑配不同的复查频率:
| 复查频率 | 盯什么坑 | 为什么是这个频率 |
|---|---|---|
| 每天 | 价格/库存/联系方式是否过期 | 这类信息一旦过期,AI 每引一次就伤你一次 |
| 每周 | 口径是否漂移、有没有新负面 | 漂移和负面是渐进积累的,周度就能发现苗头 |
| 每月 | 引用看板趋势、竞品付费动静 | 趋势类指标需要时间窗口才有意义 |
| 每季度 | 内容资产盘点、折旧与淘汰 | 结构性问题需要完整周期才能看清 |
这套频率表的逻辑,是一条「伤害速度」的排序:越是对 AI 引用有即时伤害的(如过期价格),越要高频盯;越是结构性、渐进性的(如内容资产折旧),越用长周期管。反过来最怕的是「错配」——天天盯季度才变化的指标(累死团队),或者季度才看天天在腐坏的字段(坑死品牌)。把每个坑挂上一个正确的复查频率,避坑才能从「一次大扫除」变成「日常的呼吸」。
6.7.8 深讲:最容易「自欺欺人」的三个指标陷阱
做 GEO 久了你会发现,有些数字看着在涨,其实什么都没发生。这些「自欺欺人的指标」比真实的坏消息更危险,因为坏消息会促使你改,假好消息会让你躺在原地。三个最常见的陷阱如下:
| 指标陷阱 | 看着像什么 | 为什么是假的 | 用真指标替代 |
|---|---|---|---|
| 引用总量涨了 | 「被引用次数在增加」 | 可能是换了更宽松的问法、或引擎默认答案变长了 | 固定问法下、同口径的引用率 |
| 品牌词搜索涨了 | 「越来越多人搜我」 | 可能是投放带来的短期流量,与引用无关 | 去广告后的自然搜索占比 |
| 曝光量涨了 | 「AI 答案里频繁出现」 | 可能出现在不相关的长答案里,用户根本不看 | 出现在「决策收口类」问题里的次数 |
识别这类陷阱的通用姿势只有一句:「凡是能通过改口径、换问法、凑指标『做出来』的数字,都先打一个问号。」真正的信号,必须经得起「固定问法、固定引擎、固定时间窗口」的反复验证(标准方法见第 8 章)。宁可要一个「略降但真实」的数字,也不要一个「虚涨但注水」的数字——前者让你有机会修正,后者只会让你把预算继续投在错误的方向上。
6.8 工具方法:一套能持续运转的 GEO 工作方式(🟡 进阶)
避开了坑,你需要一套能日复一日运转的「最小工作系统」。这一节给的不是某个具体工具的名字,而是一套与工具无关的工作方法——你可以用任何你顺手的载体来实现它。
6.8.1 最小闭环:测 → 改 → 再测
GEO 所有工作的核心,是一台不断转动的三拍机器:
测(观察基线)→ 改(针对问题调整内容)→ 再测(验证是否改善)→ 循环
- 测:用固定问法 × 多引擎,记录当前「被引用」状态(是否出现、怎么被描述、引用了哪些源)。
- 改:基于观察到的病根,对症改内容——统一口径、补带日期的可核事实、把结论前置等。
- 再测:隔一段时间(建议两到四周围绕一轮)重新测,看信号是否改善。
这台闭环最重要的一点:每次只改一个变量。一会儿换问法,一会儿改价格,一会儿又加内容,你就永远不知道是哪个动作在起效。像做实验一样,一次动一处,才能归因清晰。
6.8.2 内容生产的「可引用化」加工清单
很多团队的内容其实挺有价值,只是「不可抽取」。把内容加工成「可被引用」的样子,有固定的工序:
| 加工工序 | 具体怎么做 | 反例(不可抽取) |
|---|---|---|
| 结论前置 | 开头就给出核心结论 | 铺垫三屏才入正题 |
| 信息结构化 | 用小标题、分点、表格 | 一大段无层次的长文 |
| 事实带日期 | 每个关键数字标注时间节点 | 无时间的模糊陈述 |
| 来源可核 | 关键论断有出处可查 | 空口断言、没有依据 |
| 口径统一 | 与全网其他处说法一致 | 和官网自相矛盾 |
把这份清单当成内容生产的「出厂质检」,让每一篇内容在发布前都过一遍。长期坚持,你发布的内容会自然成为 AI 眼中的「可信信息源」,被引用只是水到渠成。
6.8.3 建立「口径手册」:把关键事实固化下来
口径混乱是引用资产的头号杀手,而破解它最好的武器就是一份口径手册。它是团队内部维护的、关于品牌关键事实的「唯一事实源」:
| 口径手册要固化 | 为什么必须固化 | 谁来维护 |
|---|---|---|
| 品牌一句话介绍 | 让人和 AI 都能快速理解你是谁 | 品牌/市场负责人 |
| 核心产品能力边界 | 说清能做什么、不做什么 | 产品负责人 |
| 价格与有效期规则 | 保证全网一致、可核对 | 财务/销售负责人 |
| 联系与办公信息 | 真实、连续、统一 | 行政/运营负责人 |
口径手册的价值在于:它是你所有对外内容的「基线」,所有人的表述都得向它看齐。有了它,你才能确保 AI 无论从哪个入口引用你,得到的都是同一个「你」,而不是五个打架的版本。
6.8.4 数据与案例:如何用「对照」把故事讲给老板听
做 GEO 的团队,最难的是让管理层看到「看不见的进展」。这里给你一套「把结果可视化」的方法,让工作可汇报、可复盘:
- 用「趋势」代替「单点」:不要只给老板一个「这个月被引了 9 次」的单点,而要给一条「三到四个月的趋势线」。趋势线最能说明复利在转。
- 用「对照组」讲差异:同品牌、同问法,比较「处理过口径的版本」和「没处理的口径」,把差异量化给老板看。
- 用「省下的钱」谈价值:把「被 AI 免费引用的次数」换算成「对应的获客成本」,让老板直观看到引用资产省下的现金流。
这套「翻译术」的核心,是把 GEO 的专业语言翻译成管理层听得懂的商业语言(趋势、对照、省下的钱)。能讲清价值,你才有持续拿到资源去做 GEO 的底气。
6.8.5 GEO 起步的九十天路线图
把本节所有方法收拢成一张可以照着执行的九十天路线,让你从零开始也能不慌不忙地跑起来:
| 阶段 | 时间 | 主要动作 | 里程碑 |
|---|---|---|---|
| 摸清现状 | 第 1-2 周 | 建基线、写口径手册 | 有一份固定可比的基线 |
| 把内容做可引用 | 第 3-6 周 | 按「可引用化」清单加工重点内容 | 生成第一篇高结构化内容 |
| 统一口径 | 第 7-10 周 | 逐条修正不一致项、补可核查信息 | 全网关键事实一致 |
| 看趋势调优 | 第 11-13 周 | 用追踪看板复测、改一处看一处 | 看到可解释的变化信号 |
这九十天不是让你「马上见效」,而是让你「把地基铺到可以见效的程度」。它的核心目标不是短期内被大量引用,而是建立起基线、口径、追踪这三根柱子——有了它们,之后每一次优化才有参照、有归因、有成长曲线。慢一点,但要稳一点,是 GEO 起步阶段最划算的节奏。
6.8.6 把方法固定成机制:三份常驻文档
方法要真正落地,得有人天天记得用。最适合「固定」的方式,是让团队常驻三份简单但不可省的文档,把它们当成 GEO 的「制度基础设施」:
| 常驻文档 | 内容 | 更新的时机 |
|---|---|---|
| 口径手册 | 关键事实的唯一事实源 | 有事实变动就更新 |
| 引用追踪表 | 每次实测的出现/评价/来源 | 每两周追加一次 |
| 月度复盘页 | 趋势、病根、上月动作 | 每月闭环一次 |
这三份文档合起来,就是一台「即使换了人也能继续转」的 GEO 机制。人才会流动,但文档沉淀下来的基线、口径与趋势不会。真正成熟的组织,是把优秀个人的方法,炼成集体可持续运行的制度——这也是 GEO 这条慢生意里,最值得的一笔投入。
6.8.7 深讲:工具选型的「三问」——要不要上工具、上什么工具
市面上声称「做 GEO」的工具越来越多,但工具是放大器,不是发动机。上工具之前,先过「三问」,能帮你避开绝大多数「买了吃灰」的坑:
| 三问 | 问什么 | 答不上来的含义 |
|---|---|---|
| 第一问:你的基线立了吗 | 有没有固定问法 + 固定引擎的原始记录? | 没有基线就上工具,工具只能给你「漂亮的噪音」 |
| 第二问:你的流程堵在哪 | 是记录慢、分析慢、还是口径没人守? | 工具只能补流程的洞,不能替代流程本身 |
| 第三问:输出导向动作吗 | 工具的报表能直接告诉你下一步改哪里吗? | 只会堆指标的报表,是负担不是资产 |
判断要不要上工具,还有一个更朴素的检验:先用「一张表 + 手工记录」跑满一个月,如果这套最小系统已经让你觉得「记录太费时、汇总太费劲」,那才是上工具的时机;如果连最小系统都还没跑顺,上再贵的工具也是给流程添乱。工具的定位始终是「让已经转起来的流程更快」,而不是「让还没转起来的流程自动跑」——把这句话贴在团队墙上,能省下一大笔无效采购。
6.8.8 深讲:内容资产的「仓库管理」——沉淀、检索、复用
做 GEO 到一定阶段,你会发现团队手里的内容越来越多,但真正的问题从「没内容」变成了「找不到内容、重复造轮子」。内容资产也需要像仓库一样管理。这里给一套轻量的「内容仓库」思路:
| 仓库环节 | 动作 | 收益 |
|---|---|---|
| 沉淀 | 每篇内容发布时,登记「主题、目标问题、日期、被引用情况」 | 让每篇内容可追踪 |
| 分类 | 按「答案型 / 对比型 / 行业型 / 口碑型」打标签 | 需要时能快速调取 |
| 检索 | 建立一个「主题 → 已有内容」的索引(一张表即可) | 避免重复生产 |
| 复用 | 已有内容改口径、补数据、换角度,二次加工 | 让旧内容继续产生新引用 |
| 淘汰 | 过期、错误、低效的内容标记下架或重写 | 防止「旧内容持续伤你」 |
内容仓库的核心价值,是把「内容」从一次性的消耗品,变成可反复加工的原料。同一份对比表,今天用在官网,下季度补了新数据就能再产出一篇行业白皮书;同一个 FAQ,改一版口径就能适配另一个引擎的偏好。会管理内容仓库的团队,做同样多的事,产出的引用量是「边做边丢」团队的数倍——这正是「内容资产」四个字里「资产」二字的真义。
6.8.9 深讲:把 GEO 变成团队的「例会机制」——频率与议程
方法最终要靠「例会」落地,否则再好也坚持不下来。但 GEO 例会最怕两种极端:要么从来不开、没人复盘;要么开得太密、全是形式。这里给一套可落地的例会机制,把 GEO 变成团队的自然节奏:
| 会议 | 频率 | 议程(半小时内) | 输出 |
|---|---|---|---|
| 复测会 | 每两周 | 跑固定问法 → 对基线 → 记录变化 | 更新的引用看板 |
| 病根会 | 每月 | 看趋势 → 找降点 → 定一个待改项 | 一份「下月只改一处」的计划 |
| 汇报会 | 每季度 | 三张分 + 合并报表 → 向决策者讲价值 | 一份可汇报的经营简报 |
三场会各有分工:复测会负责「数据新鲜」,病根会负责「动作归因」,汇报会负责「资源延续」。少了任何一场,链条都会断——没有复测会,病根会没有数据;没有病根会,复测会只会攒数据不产生动作;没有汇报会,前面两场会做得好也没预算。例会机制成熟之后,GEO 就不再是某个人的临时项目,而是组织里一台每月自动转一圈的机器——这正是 6.8.6「把方法固定成机制」在时间维度上的落地。
6.9 进阶专家视角:把 GEO 放进更大的棋盘(🟠 高阶)
前面的篇幅,都是在讲「怎么把引用做上去」。这一节,请允许我们把镜头再拉远一点,从专家的视角,看几个「一直争论、但决定你策略高一低」的问题。这些问题的答案没有绝对的对错,但思考的方式,能拉开你和普通从业者之间的距离。
6.9.1「引用」与「排名」终会合流吗
很多人问:GEO 会不会又是一阵风,过几年就回归「看排名」的老路?更可能的演化方向是:「被引用」会逐渐成为「排名」的隐性上层标准。引擎为了给自己的答案提供可信来源,会把「被大量认可的内容」作为优先采信的信号——到那时,「能稳定出现在 AI 答案里的品牌」,本质上已经是一种新的、更高级的排名。区别在于:旧的排名靠「位置」,新的排名靠「共识」。这并不否定 GEO 的价值,反而说明:谁现在把「共识」积累起来,谁就在未来那套新规则里天然领先。
6.9.2 先发者的「占坑」会持续多久
专家们比较一致的观点是:先发者的优势不会永久存在,但退潮会很慢。因为「被引用」建立的共识,一旦形成就具有一定的黏性和惯性——引擎不会因为出现一个新对手,就立刻抛弃一个长期被验证为可靠的答案来源。这给了先发者一段「信任红利期」。但红利不是躺来的:只有持续用高质量内容证明自己,先发者才能守住坑;一旦松懈,保护你的恰恰是你曾放弃维护的那块资产,折旧会比想象中更快(回到 6.4.7)。
6.9.3 小品牌的机会是不是比大品牌更大
这点恰恰和直觉相反:在无广告位的窗口期,小品牌往往比大品牌更有机会。原因是:
- 大品牌的动作往往更慢,决策链条长,等它掉头做 GEO,窗口可能早已被抢占;
- 小品牌更灵活,能更快把精力聚焦到某几个品类的「核心问题」上,做成「该品类的答案」;
- 窗口期的竞争看的是内容,不是预算,这正是小品牌用「专注」对抗大品牌用「资源」的最难得时机。
当然,这不代表小品牌随便做就能赢。它要求你把有限的资源压到少数几个「命中概率最高」的品类问题上,做到极致的可核查与结构化,才有机会在某个细分里成为默认答案。
6.9.4 给决策者的三条策略原则
把专家视角归结成可执行的方向,是给决策者的三条策略原则:
| 原则 | 含义 | 落地动作 |
|---|---|---|
| 先占再守 | 窗口期先占坑,再谈防守 | 立即启动基线,尽早产出结构化内容 |
| 先深再广 | 在一个品类做到默认答案,再扩展 | 聚焦少数高价值品类问题深耕 |
| 先后再做 | 先统一口径与可核查,再谈铺量 | 用口径手册打底,再扩大覆盖面 |
这三条原则串起来,就是一条完整的 GEO 战略主线:在窗口期用「先占坑」拿下先手,用「先深再广」建立品类权威,再用「先后再做」保证所有扩张都建立在可信的基座上。这三者合起来,是你把这章所有概念落成一套企业级打法的最短路径。
6.9.5 给组织与预算的建议:GEO 该由谁来做、花多少钱
最后一节从专家的视角,回答两个最实际的管理问题:谁来牵头做 GEO?预算怎么配?
谁来牵头?GEO 不是一个部门的事,它是内容、产品、市场、客服的合流。比较合理的做法是:由「内容或市场」牵头,但它必须拿到产品与客服的真实信息(否则口径做不准)。组建一个非常小的「GEO 小组」,几个角色就够了:
| 角色 | 职责 | 谁合适 |
|---|---|---|
| 口径守门人 | 维护口径手册、统一全网表述 | 内容/市场负责人 |
| 内容生产者 | 产出结构化、可核查的内容 | 编辑 + 产品协同 |
| 记录与复盘者 | 维护引用看板、做月度复盘 | 市场运营 + 数据分析 |
花多少钱?GEO 的预算不追求「大」,追求「准和持续」。它更像「内容投入」而非「广告投放」——贵在持续而非单次。合理的分配建议是:把原来投在「纯曝光」里的一部分预算,切到「内容生产 + 口径运维 + 口碑经营」上。用一句话概括口径:不是要多花钱,而是把同等的钱,更多投向「能做长」的地方,而不是「只能换瞬间流量」的地方。
6.9.6 边界与伦理:别把「信任」这座金矿玩坏
越讲到后面,越要提醒一句常被忽略的事:GEO 之所以有复利红利,根本前提是你维护住了「信任」这座金矿。而信任恰恰是最经不起「玩坏」的东西。一个成熟从业者必须想清楚几条边界:
| 边界 | 举例 | 为什么必须守住 |
|---|---|---|
| 不造假信息 | 不编造过期/不实的资质与数据 | 事实一被戳穿,信任瞬间归零 |
| 不制造伪分歧 | 不在不同账号自导自演评价 | 一旦被识破,反噬更猛 |
| 不夸大承诺 | 不把自己的能力说到不可体会 | 可核查后容易被 AI 排除 |
| 不违背一致性 | 不做「见人说人话见鬼说鬼话」 | 口径漂移是引用资产的头号杀手 |
守住这些边界,不是道德洁癖,而是利益选择。因为在可被 AI 反复核查、可被用户反复验证的环境里,任何「钻空子」的动作都在给信任资产挖坑——你省下的那点短期便利,都会在未来的引用滑坡里加倍偿还。真正的 GEO 高手,不是最会钻规则的人,而是最舍不得透支信任的人。
这也是本章想传达的价值观底色:GEO 不是一门「骗过机器」的手艺,而是一门「经得起检验」的功课。机器会越来越聪明,用户会有越来越强的是非感,唯有真实、一致、可核查的内容,才能穿越算法的一次次更新,稳稳留在那座「没有广告位」的商场里,被人反复引用、反复相信。
6.9.7 深讲:GEO 与组织的信息架构——口径一致靠制度而非自觉
专家视角常忽略一个现实:「口径一致」听上去是内容问题,本质上却是组织问题。官网由品牌团队维护,第三方资料由市场团队对接,客服话术由客服团队更新,产品参数由产品团队定义——任何一个环节的口径漂移,都会让「全网一致」成为空话。所以,做 GEO 到深水区,拼的不是写得好不好,而是组织能不能把「信息」管成「一套」:
| 信息环节 | 谁在源头生产 | 常见的漂移方式 | 制度性解法 |
|---|---|---|---|
| 品牌定位 | 品牌/市场 | 换人后口径失传 | 口径手册 + 交接制度 |
| 产品参数 | 产品/研发 | 改版后旧参数残留 | 参数以官方文档为唯一源,页面引用不手抄 |
| 价格政策 | 财务/销售 | 促销口径与常规口径打架 | 价格有效期规则统一 |
| 客服话术 | 客服 | 一线人员自由发挥 | 话术模板与口径手册同步 |
制度性解法的共同点,是「把信息的唯一权威版本放在一个地方,所有出口都从那里取」,而不是指望每个人自觉记住。所谓「组织的信息架构」,就是这张「谁负责哪个事实、哪里是唯一源、怎么同步」的分配图。一家 GEO 做到位的公司,你去看它的内部,一定会看到这张图;没有这张图的公司,AI 引用到的「多个版本的你」,迟早会自相矛盾。
6.9.8 深讲:未来三年的 GEO 演化推演——给长期布局者的三张牌
最后,从更长的时间尺度,推演未来三年 GEO 会怎么演化。推演不是为了算命,而是为了让你现在的投入方向「站得住」:
| 时间尺度 | 大概率发生的演化 | 对现在动作的含义 |
|---|---|---|
| 1 年内 | 更多引擎上线「推广/引流」类产品,但都会谨慎标注 | 「被引用」开始出现付费轨道,但有机引用仍占主流 |
| 2 年内 | AI 对「陈旧信息」的识别更强,可核查权重上升 | 现在就把「带日期、可核对」做成习惯,未来是硬门槛 |
| 3 年内 | Agent 开始替用户完成交易动作,引用直接连到调用 | 现在积累的「可信内容 + 稳定口径」,正是未来「被调用」的地基 |
这三张牌合起来,指向一个明确的结论:你现在做的「内容可抽取、事实可核查、口径可一致」,不会因为引擎换代而过时——它们每一项都是「被引用 → 被信任 → 被调用」这条长链上不变的地基。(关于 Agent 时代的「被调用」,详见第 14 章。)所以长期布局者的心态应该是:不赌某个具体引擎、不赌某个具体产品形态,只押注那些无论未来怎么变都成立的地基能力。这才是 GEO 这门慢生意里,最不怕时间的那部分。
6.9.9 深讲:GEO 的「合并报表」——把引用资产写进经营账
高阶级从业者最后要过的一关,是把 GEO 的价值翻译成 CFO 看得懂的经营语言。光说「被引用了 50 次」说服不了决策者,你需要一张「引用资产合并报表」的框架:
| 报表科目 | 怎么算 | 汇报口径 |
|---|---|---|
| 引用省下的获客成本 | 被引用次数 × 单次获客均价 | 「本季度 AI 免费替我们推荐了相当于 X 万元的广告」 |
| 引用带来的转化增量 | 被引来源的转化率 vs 平均转化率 | 「被 AI 推荐而来的用户,转化率高 Y 个百分点」 |
| 引用资产的品牌溢价 | 复购率、NPS 的变化 | 「信任资产在增值,表现在复购与口碑」 |
| 引用资产的折旧风险 | 过期内容、口径漂移的项数 | 「需维护项已清理 X 项,避免资产缩水」 |
这张报表的核心技巧,是「把抽象的引用翻译成三个具体的数字:省了多少钱、多转化了多少、资产在增值还是折旧」。决策者不关心 AI 的引用机制,但一定关心「这笔投入是在创造资产,还是在烧钱」。会做这张报表的操盘手,能把 GEO 从「看不见的玄学」变成「看得见的资产负债」——这不仅是汇报技巧,更是让 GEO 拿到持续预算的关键能力。
本章小结
把散落的知识收拢成五句话,背下来,你就握有了第 6 章的钥匙:
- GEO 研究的不是排名,是引用——研究对象从「你排第几」变成了「AI 愿不愿提到你、怎么提到你」。
- 排名可买、引用难买、信任买不到——越难买的越值钱,但千万别用买排名的预算思维去硬推引用。
- 现在是无广告位的窗口期——所有选手只拼内容与可信,谁先花内容钱占坑,谁就在将来广告位出现时拥有最低的机会成本。
- 被说到 > 排第一——因为前者是复利资产,后者是一次性位置;精致不必然被引用,结构化、可核查、结论前置才是。
- 从「建基线」开始动手——分清「没出现」和「没说好」,让关键事实可核查,然后给内容足够的累积周期,用季度而非月度来衡量 GEO。
记住最后那个检验杆:别只问「我的内容好不好看」,要问「AI 会不会引用我」。 这,就是你已经从 SEO 思维,切换到 GEO 思维了的标志。
本章小结的「一页速记卡」
如果你只看一页,就带走下面这张速记卡:
| 问题 | 一句话答案 |
|---|---|
| GEO 研究什么 | 引用,不是排名 |
| 三层怎么排 | 排名可买、引用难买、信任买不到 |
| 凭什么现在做 | 无广告位的窗口期,成本最低 |
| 怎么确认值不值 | 被说到是复利资产,排第一是一次性位置 |
| 第一步做什么 | 建一条固定可比的 AI 亮相基线 |
| 最后的护城河 | 买不到的那层,才是别人偷不走的东西 |
| 实战第一课 | 先定一个问法、测稳定,再谈其他 |
三层一图流
最后,用一个最小的闭环帮你在脑子里刻下全章主线:
SEO 抢货架(让货被看见)→ 这是入口
AEO/GEO 搞定导购(让 AI 愿意点名你)→ 这是放大
信任做地基(让用户信你)→ 这是转化与复利之源
这三者不是前中后三段,而是一座同时在建的地基、楼层与屋顶。地基(信任)打不牢,层楼(引用)盖得越高越危险;而地基(信任)砌得够实,层楼(引用)终会长成正资产、正复利,最后成为那栋没人买得走的大楼。
给每位读者的最后叮嘱
这一章我们要建立的不是一套技巧,而是一种「把竞争看慢」的眼光:别急着抢一个明天就可能易手的位置,而是用心把自己变成那个「AI 愿意反复提到、用户愿意反复相信」的人。 记住引用是慢生意、信任复利、窗口期稍纵即逝——现在启程,正是最好的时候。
愿你在读完这章之后,不再把「被 AI 推荐」当作一句虚悬的漂亮话,而是把它当成一份可以测量、可以经营、可以传给团队的真正资产。从建基线那一刻起,你就已经不再是信息的偶然过客,而是这座「没有广告位的商场」里,被反复提名的那一个。
系统走查点(去系统里走一遍)
这一章的三层结构在配套系统里对应走查动线的三个站——先看缺口(洞察中心),再把缺口翻成动作(行动规划),最后固定节奏看趋势(效果复盘):
| 站 | 走查勾(勾上算过) | 去走一遍 |
|---|---|---|
| 2 · 洞察中心 | 能指出哪条问法最该先做 | 打开 /insights-hub |
| 3 · 行动规划 | 能说出每条行动对应的病根类型 | 打开 /campaigns |
| 6 · 效果复盘 | 能说出三个月后要重问哪 5 句 | 打开 /measure-reports |
走查用的示例品牌是只读的:不花积分、不写数据。没登录会先跳登录页,登录后点左侧「示例项目(只读)」也能进。
🔗 下一章:《实测方法论》将用真实采样,检验本章提出的「引用/排名/信任」三层判断。
第 12 章 房地产与汽车赛道:意图定位与 Query Fan-out
第 12 章 · 18 节 / 86 小节 · 约 3.2 万字
本章导读
🔗 前置:建议先读完第 10 章《从业者赛道》与第 11 章《教育赛道》。第 10、11 章讲的是「一个行业的通用打法」,本章把镜头再拉近一档:在同一行业内部,不同用户意图之间该怎么分工。本章以房地产与汽车这两个意图密度最高的赛道为样本,把「意图定位 → 意图扩展 → Query Fan-out → 内容承接」这条主线走完。
第 10 章讲「从业者赛道」,第 11 章讲「教育赛道」——它们回答的是「换一个行业,通用方法要怎么重做一遍」。本章要回答的是更进一步的问题:同一个行业里,用户根本不是「一类人」,而是「好几类人带着好几种目的在问」。如果你把这些人当成一类人来答,你的内容再规范、铺得再广,也会出现一个奇怪的现象——明明每一句都答到了关键词,却怎么也进不了 AI 的答案。
为什么偏偏挑房地产和汽车?因为这两个赛道把「意图分歧」这件事放大到了极致:
- 客单价高、决策不可逆:一套房、一台车往往是家庭数年的现金流,用户不敢「随便看看」,一定会反复追问、交叉验证;
- 决策链上不止一个角色:买房可能牵动夫妻双方、双方父母、中介、置业顾问;购车可能牵动主驾、副驾、家庭预算方;
- 用户的真实问句几乎「不按关键词出牌」:没有人会问「30 万元 SUV 参数对比表」,他们问的是「30 万以内买什么 SUV 全家人都能坐得下」;
- 意图一旦判错,合规风险随之而来:把「投资升值」当「刚需自住」来答,轻则无效,重则触碰广告法红线。
本章要回答的五个问题,就是本章的骨架:
- 用户意图定位与扩展到底在做什么?(11.2)
- Query Fan-out 的意义是什么——为什么 AI 不是关键词匹配?(11.3)
- 用「30 万以下 SUV」把 1 和 2 完整走一遍(11.4)
- 房地产为什么要区分用户意图类别?(11.5)
- 本系统房地产专版为什么要做用户身份模拟?新房承销和二手房中介的打法差在哪?(11.6、11.7)
在进入正文前,请先建立一个坐标系——本章全部方法的底层,是三个「不」:
| 三个「不」 | 反面做法(失效) | 正面做法(有效) |
|---|---|---|
| 不匹配关键词,而解析意图 | 把「30 万」「SUV」当两个词塞进标题 | 把问句拆成一个意图簇(11.3 / 11.4) |
| 不假设单一身份,而覆盖身份 | 一套话术打通所有购房人 | 6 类身份 × 5 阶段 × 22 维的覆盖网格(11.6) |
| 不混淆两种经营形态 | 把二手房的经验套到新房上 | 承销与中介各用一套意图结构(11.7) |
一句话记住本章:第 10、11 章教你把「一个行业」讲对;本章教你把「行业里的一群人」分别讲对。 AI 的答案是一簇子问题合成出来的,你能覆盖多少子问题,就决定你能进多少答案。
章节级别映射
本章级别映射:🔵 入门 · 🟢 基础 · 🟡 进阶 · 🟠 高阶 · 🔴 专家(子节标题带徽标)
| 子节 | 内容 | 级别 |
|---|---|---|
| 12.1 为什么这两个赛道要单独成章 | 意图密度与决策链 | 🟢 基础 |
| 12.2 用户意图定位:五类意图层 | 从行业赛道细分到意图层 | 🟠 高阶 |
| 12.3 Query Fan-out:AI 到底怎么「听」一个问题 | 关键词匹配 vs 意图解析 | 🟠 高阶 |
| 12.4 汽车赛道实战:「30 万以下 SUV」全推演 | 一个问句 → 一个意图簇 → 一套内容包 | 🟠 高阶 |
| 12.5 房地产为什么必须区分意图类别 | 意图决定内容形态、信源与合规边界 | 🟠 高阶 |
| 12.6 房地产专版:为什么必须做用户身份模拟 | 6 人设 × 5 阶段 × 22 维 = 660 覆盖网格 | 🟠 高阶 |
| 12.7 新房承销 vs 二手房中介:两套意图结构的打法差异 | 同赛道、不同经营形态 | 🟠 高阶 |
| 12.8 方法清单:双赛道意图承接 SOP | 把本章方法落成可执行清单 | 🟠 高阶 |
| 12.9 思考与练习 | 🔵 / 🟡 / 🟠 分级 | 分级 |
12.1 为什么这两个赛道要单独成章(🟢 基础)
12.1.1 两个赛道的共同点:高卷入、长周期、多角色
房地产与汽车表面上看风马牛不相及,但在 GEO 的视角下,它们是同一类问题:决策成本极高、决策周期极长、决策角色极多。这三个「极」决定了用户问 AI 的方式,与其它赛道有本质差别。
| 维度 | 一般消费品 / 服务 | 房地产 | 汽车 |
|---|---|---|---|
| 单笔金额 | 几十到几千元 | 数十万至数百万 | 十万至数十万 |
| 决策周期 | 分秒到几天 | 数月到一年以上 | 数周到数月 |
| 决策角色 | 通常 1 人 | 2–6 人(含长辈) | 1–3 人(含家庭预算方) |
| 不可逆性 | 低(可退可换) | 极高(置换成本巨大) | 中高(贬值 + 手续) |
| 问 AI 的目的 | 找答案 / 找便宜 | 找「我这种情况该怎么办」 | 找「我这笔预算该怎么花」 |
这张表的最后一行是全章的关键:用户在前两行问「什么好」,在最后一行问「我该怎么办」。而 AI 恰恰更擅长回答后者——它会把「我该怎么办」拆成若干可回答的子问题,再逐个合成。谁能提供这些子问题的答案,谁就进答案。
12.1.2 一句话区分:这两个赛道,用户「不按关键词出牌」
传统搜索时代的优化习惯,是把无数字眼拆成关键词、去堆标题和正文。到了生成式引擎时代,这套动作会失灵,原因在于用户输入的不是一个词,而是一个处境:
- 房产用户不会搜「学区房 价格」,他会说「预算 300 万,在××区域买学区房还是老破小,孩子明年上小学」;
- 汽车用户不会搜「SUV 油耗」,他会说「30 万以内,一家五口加老人,油车还是新能源更省」;
- 他们甚至不会把条件说全——没说出口的部分,正是 AI 要替他们推理的部分。
所以,这两个赛道的优化重点,不是「把关键词铺满」,而是「把用户没说出口的处境,提前替他想全、写清、铺好」。
12.1.3 本章的三条主线
- 意图定位(11.2):把「用户」这个模糊集合,切成五类可操作、可写内容、可选信源的意图层;
- 意图扩展 / Query Fan-out(11.3、11.4):把用户的一问,还原成 AI 内部会展开的一簇子问题;
- 意图落到产品设计(11.5–11.7):房地产为什么要分意图类别、为什么要做身份模拟、承销与中介的意图结构差在哪。
12.1.4 与第 10、11 章的关系
| 章节 | 优化粒度 | 回答的问题 |
|---|---|---|
| 第 10 章 从业者赛道 | 行业 | 服务商 / 工具方怎么被 AI 推荐 |
| 第 11 章 教育赛道 | 行业 | 教育机构怎么承接家长的质疑与算账 |
| 第 12 章(本章) | 行业 × 意图 × 身份 | 同一行业里不同意图的人,怎么各答一套 |
| 第 13 章 GEO 工作流 | 流程 | 把上述方法跑成一个两周闭环 |
换句话说:第 10、11 章让你把内容「做对」,本章让你把内容「分对」。
12.1.5 「时间取向」:为什么同一句话在房产与汽车上答案方向相反
除了「高卷入、长周期、多角色」,还有第四个共同点,也是最容易被忽略的一个——用户的「时间取向」。它决定内容该用哪种「时态」作答,用错了,内容再规范也接不上。
| 场景 | 用户的默认时间取向 | 内容该答的「时态」 | 典型反例(接了但接不上) |
|---|---|---|---|
| 新房承销 | 未来 | 「将会怎样」——规划、兑现节奏、风险 | 只讲现状:这里现在多好 |
| 二手房中介 | 现在 | 「现在怎样」——现状、真实成交、通勤实测 | 只讲规划:以后会通地铁 |
| 汽车 | 现在 + 未来 3–5 年持有成本 | 「现在怎么买 + 未来怎么养」 | 只讲购车价,不讲持有成本 |
这张表解释了一个常见困惑:为什么同一个区域,新房和二手的内容互相「抄」会失效? 因为新房用户站在「赌未来」,二手用户站在「看现在」——同一片地,两种时态。
12.1.6 本章要建立的两条工程纪律(后面反复用)
在进入方法之前,先把两条纪律立起来,它们贯穿全章:
| 纪律 | 内容 | 出现位置 |
|---|---|---|
| 纪律一:模拟 ≠ 证据 | 「身份模拟」只负责生成问法,绝不生成 AI 应答或引用证据 | 12.6.7 |
| 纪律二:盲区必须可见 | 内容矩阵要网格化,让「没写的那一格」主动暴露出来 | 12.6.5 |
这两条看起来是「工程细节」,其实是本章能不能落地的分水岭。很多团队不是不会写内容,而是既不知道问了什么(无网格),又把模拟当成了数据(污染证据)。
5 分钟动作:打开你项目的真实问句池,随机抽 20 条,试着把它们归入五类意图层。数一数:哪一类最多?哪一类为零?为零的那一类,既是你今天最大的盲区,也是最大的机会。
12.1.7 读完本章你手里应该有什么(交付物清单)
本章不是「读完就完」,而是「读完手里多了五样东西」:
| # | 交付物 | 形态 | 用途 |
|---|---|---|---|
| 1 | 意图矩阵 | 意图层 × 内容形态 × 信源类型 | 决定每类问该写什么、铺到哪 |
| 2 | 子问题清单 | 母问题 → 四轴子问题 | 决定写多少块、排什么优先级 |
| 3 | 内容块库 | 结论 + 依据 + 判定 | 可整句摘抄的答案原料 |
| 4 | 覆盖网格 | 22 × 6 × 5(房产) | 让盲区可见、可补 |
| 5 | 合规清单 | 分赛道禁区表述 | 发布前逐条勾选 |
判断自己是否真读懂了:能不能在 30 分钟里把这五样东西的「空壳」搭出来?能,说明方法到手了;不能,回到 12.2 重读。
自检:如果你现在手里只有一个内容模板,打算套给「刚需」「投资」「改善」三类房产用户,本章读完你应该能说出它为什么必然失效。
12.2 用户意图定位:五类意图层(🟠 高阶)
12.2.1 从「行业赛道」到「意图层」:为什么还要再细分一层
第 10、11 章已经把「行业」这一层讲透。但任何一个高卷入行业里,「用户」都不是一类人。以房产为例,「刚需上车」和「投资保值」这两个人,对同一个楼盘会问出完全不同的问题、需要完全不同的证据、信任完全不同的信源。行业分完还只是分到「哪一类生意」,意图再分才是分到「哪一种问法」。
这一层细分的价值,可以用一个反直觉的对比说清:
| 做法 | 表现 | 结果 |
|---|---|---|
| 不分意图:一个主题写一篇「大而全」 | 一篇内容想同时回答「多少钱」「值不值」「怎么办」「有没有坑」 | AI 摘不出任何一个完整子答案 → 零引用 |
| 分意图:一个主题写五篇「各答一类」 | 每篇只为一种意图收口 | AI 逐子问题命中 → 多篇分别被引用 |
原因在第 5 章讲过:引擎合成答案时偏好「句子级可摘抄」的块。一篇什么都说一点的内容,对引擎而言「可摘抄成本」最高;一篇只把一件事说透的内容,才是引擎眼里最好用的原料。
12.2.2 五类意图层:信息型 / 价格型 / 对比型 / 决策型 / 风险型
本系统把用户意图收敛为五个可操作层级。这五层不是学术分类,而是「内容形态 + 信源类型 + 收口方式」都能直接对应的操作层:
| 意图层 | 用户在想什么 | 典型问法 | AI 的默认作答形态 | 你要铺的内容形态 |
|---|---|---|---|---|
| 信息型 | 「先搞懂这是什么」 | 「××是什么」「××怎么选」 | 定义 + 机制 + 分类 | 科普/指南类长文、百科式条目 |
| 价格型 | 「这个要花多少钱」 | 「××多少钱」「预算 N 能买什么」 | 价格区间 + 影响因素 + 隐藏成本 | 价格带 + 日期 + 费用清单 |
| 对比型 | 「A 和 B 哪个好」 | 「A 和 B 有什么区别」「哪个更划算」 | 多维度对照表 | 对比表(≥5 维)+ 适用人群划分 |
| 决策型 | 「我这种情况该怎么办」 | 「我预算 N,想……,怎么选」 | 分场景建议 + 优先级 | 处境→方案 的映射表、决策树 |
| 风险型 | 「会不会有问题/被坑」 | 「××是不是坑」「有没有风险」 | 风险清单 + 识别方法 + 避坑 | 风险正反例、负面占位、合规边界 |
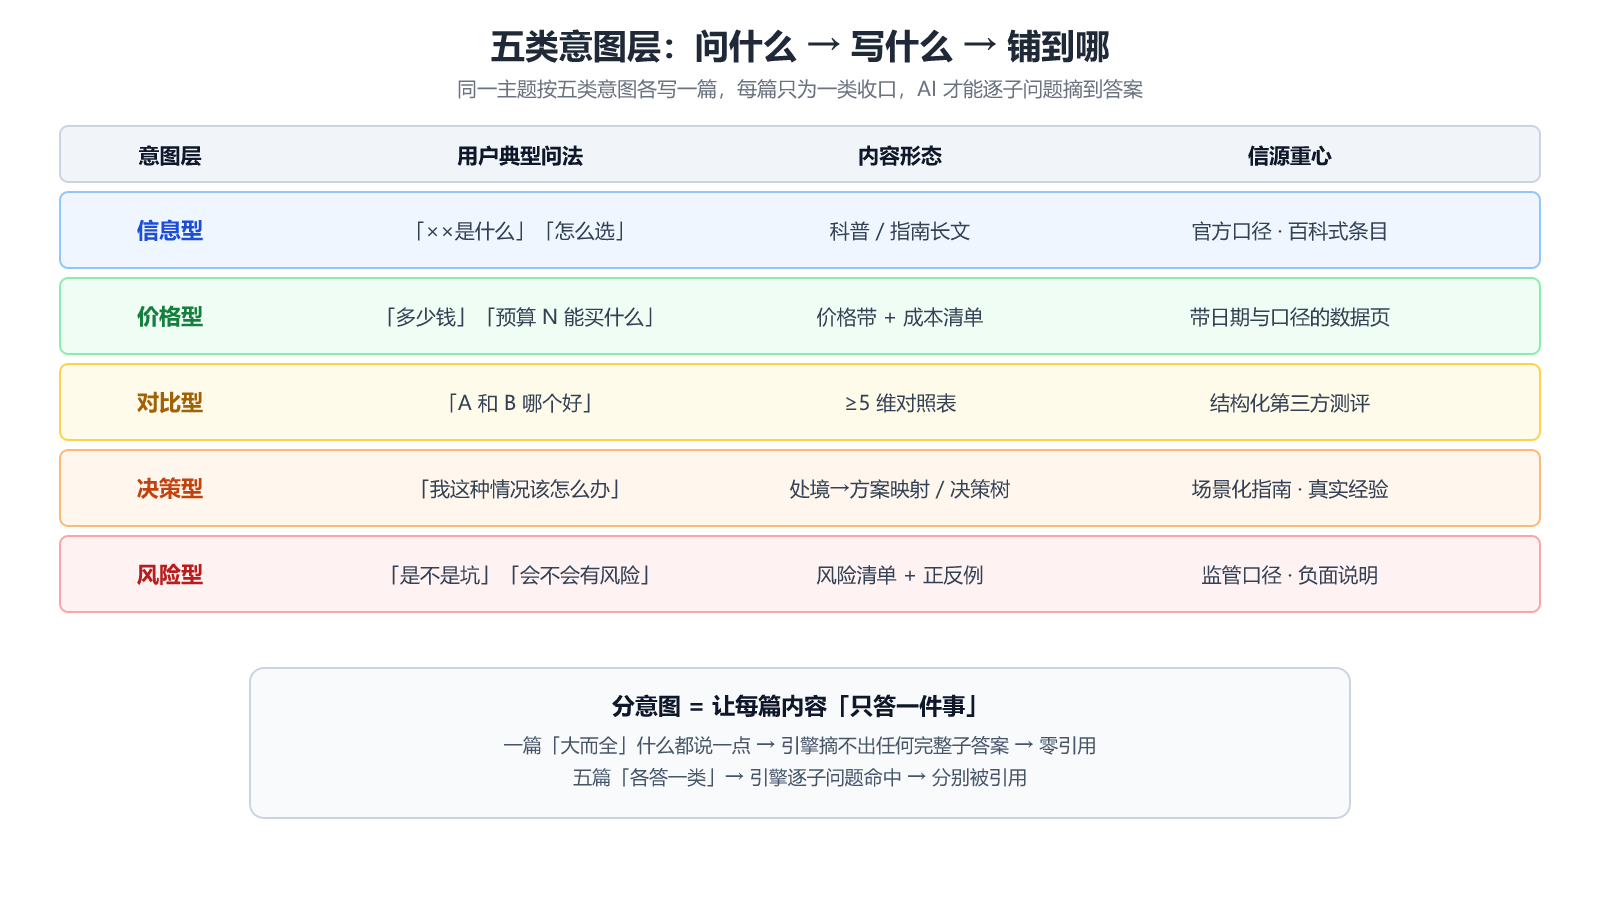
图 11-1 五类意图层:同一主题按五类意图各写一篇,每篇只为一类收口(见图 11-1)。
为什么是这五层而不是三层或七层:少了「风险型」,会漏掉高卷入赛道里最大的一块负面流量(第 11 章的「抢阅卷权」讲的就是这块);多了则操作层过细,内容矩阵会失控。五层刚好与「内容形态」一一对应,产出不重复、不遗漏。
12.2.3 意图层 × 内容形态:同一个主题为什么要写五遍
这不是「一稿多发」(第 9 章),而是同一主题的五种意图,各写一篇。两者容易混淆,必须分清:
| 概念 | 定义 | 出处 |
|---|---|---|
| 一稿多发 | 同一份内容,按平台特性改写成多份 | 第 9 章 §9.3 |
| 多意图分发(本节) | 同一主题,按意图层写 5 份不同的内容 | 本章 |
举个房产的例子。围绕「××区域买房」这一个主题:
- 信息型:《××区域买房指南:板块、配套、通勤一次说清》
- 价格型:《××区域 2026 年 9 月房价带:总价区间与常见隐藏成本》
- 对比型:《××区域 vs 相邻××板块:6 个维度对照》
- 决策型:《预算 300 万 + 学区需求,在××区域怎么选?》
- 风险型:《××区域买房的 5 个常见坑:交付、学区、产权、噪音、规划变动》
五篇各有收口,AI 在不同子问题里会分别摘到它们。如果你只写第一篇「大而全」,五类用户的问题你都只答了个开头。
12.2.4 意图层 × 信源:同一个答案,为什么要铺在不同信源上
同一条意图,AI 采信的信源也可能不同(第 9 章讲「生态绑定」)。经验规律(需以你自己实测为准):
| 意图层 | 更容易被采信的信源类型 |
|---|---|
| 信息型 | 百科式条目、行业媒体、科普长文 |
| 价格型 | 带明确日期与口径的官方页 / 数据页 |
| 对比型 | 结构清晰的第三方测评、横向评测 |
| 决策型 | 场景化的指南、真实用户经验(可核查) |
| 风险型 | 监管口径解读、真实的负面说明与处理记录 |
打法含义:别指望「一篇内容铺所有信源」。先把意图分好,再把每一类意图铺到它最容易被采信的那类信源上。
12.2.5 意图识别的三个判据(写内容前先判意图)
拿到一批真实问句时,用三个判据快速归类:
| 判据 | 看什么 | 例 |
|---|---|---|
| 动词 | 「是什么 / 怎么选 / 值不值 / 会不会 / 怎么办」 | 「怎么办」→ 决策型;「会不会」→ 风险型 |
| 限定词 | 预算 / 面积 / 时间 / 人数 / 区域 | 出现「预算 N」→ 价格型或决策型 |
| 收口的对象 | 用户想要一个「结论」还是「一个可选清单」 | 要结论 → 决策型;要清单 → 对比型 |
实操提示:这三个判据可以固化成一张抽检表,每批新问句进来先分类再进内容管线。本系统的问法池按意图分层组织,正是为了让这一步「有现成结构可挂」。
12.2.6 深讲:意图是会漂移的——同一用户,不同阶段问法完全不同
同一个买房人,在三个月里会经历完全不同的意图:
| 阶段 | 他问 AI 的话 | 意图层 |
|---|---|---|
| 刚起意 | 「现在是不是买房的时候」 | 信息型 / 风险型 |
| 算预算 | 「预算 300 万能买到什么样的房子」 | 价格型 |
| 比区域 | 「A 区还是 B 区更适合自住」 | 对比型 |
| 定方案 | 「首套,孩子明年上学,怎么选」 | 决策型 |
| 快下单 | 「买这个楼盘有什么风险」 | 风险型 |
关键洞察:意图不是用户的属性,而是用户所处阶段的属性。所以你的内容矩阵不能只按「人群」切,还要按「阶段」切——这正是 11.6 房地产专版做「5 阶段」的原因。
12.2.7 陷阱与避坑
- 陷阱一:把意图层当标签贴。分了类却不改内容形态,等于没分。
- 陷阱二:只做信息型和价格型。这两类好写,但决策型与风险型才是高卷入赛道的转化入口。
- 陷阱三:用同一篇内容去覆盖多个意图。AI 的「可摘抄成本」会直接惩罚这种写法。
12.2.8 五类意图层的自测表(打印出来贴墙)
拿你自己的项目逐条自问。任一条答「没有」,那一层就是空的。
| 意图层 | 自测问句 | 你的状态 |
|---|---|---|
| 信息型 | 新用户搜「××是什么」,你的内容够不够权威、够不够前? | 有 / 无 |
| 价格型 | 你的价格带是否带日期、带口径、带隐藏成本? | 有 / 无 |
| 对比型 | 你有几张 ≥5 维的对照表,且能说出「谁更适合」? | 有 / 无 |
| 决策型 | 你能否把「预算 + 处境」直接映射到一个推荐? | 有 / 无 |
| 风险型 | 你有没有主动写自己的「坑」,且不踩合规线? | 有 / 无 |
经验值:多数团队在「信息型」上有内容、在「价格型」上有散数据,但在「决策型」和「风险型」上基本为零——而后者恰恰是高卷入赛道的转化入口。
12.2.9 五类意图的「动词库」(写标题与收口句直接抄)
标题和结论句的动词,直接决定 AI 能不能认出这是哪一类意图的答案。把下表当模板用:
| 意图层 | 标题常用动词 | 收口句式 |
|---|---|---|
| 信息型 | 是什么 / 怎么构成 / 一次说清 | 「一句话:×× 指的是……,它的关键构成有三块。」 |
| 价格型 | 多少钱 / 费用清单 / 总成本测算 | 「结论:按(口径 + 日期),总成本落在 ××–×× 区间。」 |
| 对比型 | vs / 区别 / 谁更适合 | 「结论:追求 A 选前者,追求 B 选后者,分界线是 ××。」 |
| 决策型 | 怎么选 / 我该怎么办 / 推荐 | 「结论:像你这样(处境),优先 ××,其次 ××。」 |
| 风险型 | 有什么坑 / 会不会 / 避坑 | 「结论:最大的三个风险是 ××,识别方法是 ××。」 |
纪律:每一个结论句都必须能单独摘出来读通(第 5 章的「可抽取块」)。如果一句话摘出来看不懂,它对引擎就是废料。
5 分钟动作:把 12.2.9 的「收口句式」抄进你的写作模板,下一次起草时先写结论句、再展开依据——顺序反过来,内容会自动变得「可摘抄」。
12.2.10 同一个主题的五份内容长什么样(完整示例)
以汽车「30 万 SUV」为例,五类意图各写一篇,看看它们的标题与收口差在哪里:
| 意图层 | 标题 | 一句话收口 |
|---|---|---|
| 信息型 | 《30 万级 SUV 怎么分类:5 座 / 7 座、油 / 电一次说清》 | 「一句话:这个价位分为……四类,分野在 ××。」 |
| 价格型 | 《30 万以内 SUV 五年总成本测算(油/电/混各一份)》 | 「结论:按年行驶 1.5 万公里、有私桩测算,五年总成本 ±× 万元。」 |
| 对比型 | 《油车 vs 新能源:30 万级 6 维对照表》 | 「结论:看重 ×× 选前者,看重 ×× 选后者。」 |
| 决策型 | 《一家五口 + 老人,30 万预算该怎么选 SUV》 | 「结论:像你这种情况,优先 ××,其次 ××。」 |
| 风险型 | 《买 30 万级 SUV 最容易后悔的 5 件事》 | 「结论:最大的三个风险是……,识别方法是 ××。」 |
注意看这五条收口句:它们各自能单独摘出来读通。 这就是「分意图写内容」比「一篇大而全」更能被引用的底层原因。
自检:随机抽 10 条你的真实用户问句,能否在 30 秒内把它归入五层之一?如果不能,说明你的问句池还没有结构。
12.3 Query Fan-out:AI 到底怎么「听」一个问题(🟠 高阶)
12.3.1 传统搜索的「关键词匹配」 vs AI 的「意图解析」
这是全章、乃至全书最容易被低估的一处认知差。
| 维度 | 传统搜索 | 生成式引擎 |
|---|---|---|
| 输入处理 | 切词 → 匹配倒排索引 | 理解整句 → 推断意图 → 展开子问题 |
| 匹配对象 | 关键词是否出现 | 子问题的答案是否存在 |
| 用户没说的部分 | 忽略 | 补全并推理 |
| 你的优化单位 | 页面 / 关键词 | 可摘抄的答案块 |
一句话:传统搜索在问「你的页面里有没有这个词」,生成式引擎在问「你这里有没有这些子问题的答案」。 于是,「关键词有没有铺满」这件事的权重被大幅下调,取而代之的是「你有没有覆盖它展开出来的那一簇子问题」。
12.3.2 什么是 Query Fan-out:一个问句被「扇出」成一个问题簇
Query Fan-out(查询扇出) 指的是:生成式引擎收到一个笼统问句后,会在内部把它扇出(fan out)成若干更具体、可独立回答的子问题,分别检索、分别取材,最后合成一个整体答案。
用户问:30 万以下买什么 SUV?

        ┌─ 子问题 1:三口/五口之家,这个价位空间够不够?
        ├─ 子问题 2:油车和新能源,五年用车成本差多少?
母问题 ─┼─ 子问题 3:有哪些购车补贴/牌照政策?售后网点多不多?
        ├─ 子问题 4:这个价位段哪些车保值率高、三年后能卖多少?
        └─ 子问题 5:(还有引擎自己补的,比如)这个预算要不要上四驱?
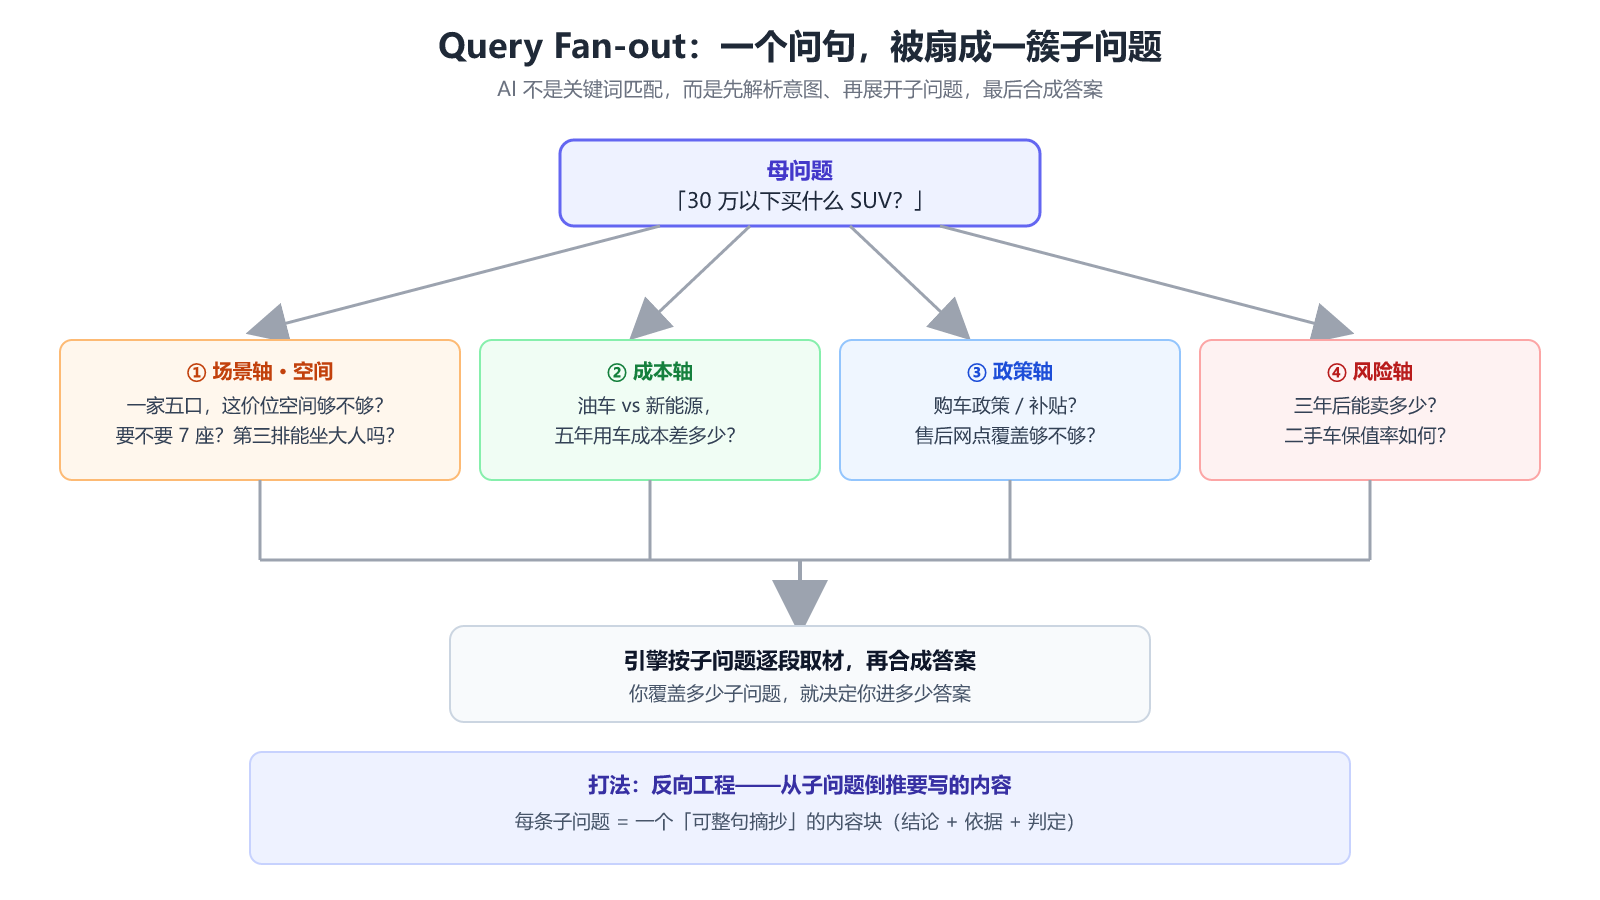
图 11-2 Query Fan-out:一个母问题沿四条扇轴被展开成一簇可独立回答的子问题(见图 11-2)。
引擎最终给出的答案,是这些子问题答案的合成。因此:
你能进答案,不是因为你的页面上有「30 万」和「SUV」,而是因为你恰好回答了它扇出的某一两个子问题。
12.3.3 Fan-out 的四条扇轴
子问题不是随机展开的,它大体沿着四条轴扇开。掌握这四条轴,你就能预判引擎会问什么:
| 扇轴 | 引擎在想 | 典型子问题 |
|---|---|---|
| 场景轴 | 用户是谁、什么处境? | 「一家五口出行」「通勤 30 公里」 |
| 成本轴 | 花多少、长期花多少? | 「首付 + 月供 + 用车成本」 |
| 政策轴 | 有哪些外部规则影响决策? | 「补贴 / 牌照 / 限购 / 售后网点」 |
| 风险轴 | 可能后悔的地方在哪? | 「保值率 / 交付 / 口碑 / 维权」 |
方法与内容形态的对应:场景轴 → 决策型内容;成本轴 → 价格型;政策轴 → 信息型 + 风险型;风险轴 → 风险型。四条轴铺满,五类意图自然覆盖。
12.3.4 为什么 Fan-out 决定「你能不能进答案」
引擎合成答案时,是按子问题逐段取材的。这意味着一个残酷但有用的结论:
| 你的内容覆盖情况 | 结果 |
|---|---|
| 覆盖了 0 个子问题 | 完全不出现在答案里 |
| 覆盖了 1 个子问题 | 出现在答案的一小段(可能是被引用的一句话) |
| 覆盖了多数子问题 | 成为该答案的主要信源,被反复引用 |
所以「进答案」不是一次二元的成败,而是一个覆盖度的连续量。这也就解释了为什么「多意图分层 + 覆盖展开」比「死磕一个关键词」更有效。
12.3.5 反向工程:从子问题倒推要铺的内容
实操上,Fan-out 的用法是反着走:
- 收集真实母问题(用户实际怎么问);
- 对每个母问题,沿四条扇轴列出「引擎大概会扇出哪些子问题」;
- 每个子问题 = 一个内容块(一段结论 + 一个动作 + 一条判定标准);
- 把内容块组织成篇、铺到对应信源。
这样产出的内容,天然是「引擎要好用的形状」。
12.3.6 深讲:Fan-out 与「可抽取块」的关系(呼应第 5 章)
第 5 章讲过「可抽取块」——引擎偏好能整句摘抄的表达。把两件事连起来看,你会得到一个非常实用的写作纪律:
为每一个子问题,写一个「能被整句摘出来」的块。
一个合格的子问题答案块长这样:
【子问题】30 万以下,一家五口,第三排座椅是刚需吗?
【结论】30 万以下的 7 座 SUV,第三排普遍只适合应急,不适合成年人长途乘坐。
【依据】轴距普遍在 2.8 米以内,第三排腿部空间多不足 20 厘米。
【判定】若每月有 ≥3 次满载 6–7 人出行,建议优先考虑 MPV 或加大预算。
引擎摘走「结论」那一句,就完成了一次引用。你不需要让引擎理解全文,你只需要让它摘走那一句。
12.3.7 陷阱与避坑
- 陷阱一:把 Fan-out 当成关键词堆砌。把子问题拆出来后,如果只是把子问题当成关键词塞进标题,等于没做。
- 陷阱二:只覆盖「商业意图」的子问题。只答「买哪个」不答「要不要买 / 买了会怎样」,会丢掉风险轴与场景轴。
- 陷阱三:假设引擎的扇轴固定。扇轴会随引擎版本漂移(第 8 章「机制漂移」),要定期用真实问句复核。
12.3.8 反向工程五步模板(照着填就行)
| 步 | 动作 | 产出 | 示例(沿用 SUV) |
|---|---|---|---|
| 1 | 收母问题 | 一批用户原话 | 「30 万以下买什么 SUV」 |
| 2 | 判意图层 | 每句归入五类之一 | 主要落在决策型 + 价格型 |
| 3 | 沿四轴扇出 | 一组可独立回答的子问题 | 空间 / 成本 / 政策 / 保值 四脉 |
| 4 | 写成内容块 | 结论 + 依据 + 判定 | 12.4.4 的四个组件 |
| 5 | 定信源落点 | 每块指定优先信源 | 12.4.5 的四个落点 |
心得:这五步里,最容易被跳过、也最值钱的是第 2 步(判意图层)。跳过它直接扇出子问题,子问题会「乱长」——看似很多,却没有一类能被引擎完整采纳。
12.3.9 Fan-out 的三种典型误用
| 误用 | 症状 | 修正 |
|---|---|---|
| 关键词化 | 把子问题当成关键词塞进标题,正文却没答 | 每个子问题配一个完整内容块 |
| 只扇一脉 | 只沿「成本轴」扇,场景/政策/风险全空 | 四条轴逐条检查是否都有子问题 |
| 无限扇出 | 子问题越列越多,没有优先级 | 按「引擎取材概率 × 你的优势」排序,滚动补 |
12.3.10 一个反直觉结论:你不需要覆盖「全部」子问题
很多人一听 Fan-out,就想去穷举所有子问题——这是不可能的,也没必要。因为覆盖度对引用率是递减收益:
| 覆盖度 | 你在答案里的角色 |
|---|---|
| 0 个子问题 | 完全不出现 |
| 1–2 个 | 被引用一句话 |
| 半数以上 | 成为主要信源,被反复引用 |
| 100% | 边际收益极低(最后一两个子问题很少有人问) |
打法含义:先把「每脉各答 1 个最好的子问题」做完,再谈铺量。 均匀覆盖优于局部饱和——这和传统 SEO「死磕一个关键词做到极致」的直觉正好相反。
5 分钟动作:从你的问句池里挑一个母问题,沿四条扇轴各写 1 条子问题,先只答这 4 条——用最小成本验证「Fan-out 反推内容」这条链路通不通。
12.3.11 Fan-out 与「一稿多发」的区别(别再混了)
这两个概念都涉及「多个版本的内容」,但方向完全相反:
| 维度 | 一稿多发(第 9 章) | Fan-out 承接(本章) |
|---|---|---|
| 起点 | 一份成稿 | 一个母问题 |
| 发数的方式 | 按平台改写 | 按子问题分写 |
| 产物 | 同一内容的多平台版本 | 同一问句的多子问题答案 |
| 作用 | 提高被不同信源收录的概率 | 提高被同一个答案采纳的覆盖度 |
| 共同点 | 都拒绝「一份内容打天下」 | 同左 |
一句话区分:一稿多发是「横向铺平台」,Fan-out 是「纵向填子问题」。 两者可以叠加,但不能互相代替。
自检:任取一个你行业里的笼统问句,能否在 5 分钟内沿四条扇轴写出 8 条子问题?这是本章最该练成的手感。
12.4 汽车赛道实战:「30 万以下 SUV」全推演(🟠 高阶)
前面两节讲的是原理,这一节用一个最常见的问句,把「意图定位 → Fan-out → 内容承接」从头走一遍。
12.4.1 起点:一个「看起来很像关键词」的问句
用户输入:「30 万以下买什么 SUV?」
如果按传统搜索的思维,这句话里只有两个关键词:「30 万」和「SUV」。于是很多团队会去写一篇《30 万元以内 SUV 车型推荐》,把车型列一长串,配几张参数表——这篇内容几乎永远不会被引用,原因下一节(12.4.8)细讲。
正确的第一步,是问:AI 在回答这句话之前,会先替用户补全什么?
12.4.2 AI 解析出的四条意图
生成式引擎不会把「30 万以下 SUV」当成「找一堆车型来罗列」。它会先解析出用户没说出口的处境,再围绕这些处境展开。至少四条意图会被解析出来:
| 序号 | 引擎解析出的意图 | 对应扇轴 | 为什么引擎认为用户在意 |
|---|---|---|---|
| ① | 家庭多成员出行的空间需求 | 场景轴 | 「SUV + 预算」常出现在家庭用车语境;是否 6/7 座、第三排能否坐人是高频子问题 |
| ② | 燃油 / 新能源车型的用车成本对比 | 成本轴 | 30 万是油电混战最激烈的价位带,「五年总成本」是决策分水岭 |
| ③ | 购车政策与售后网点覆盖 | 政策轴 | 牌照、补贴、限行、售后半径会直接改变「能不能买、买了省不省心」 |
| ④ | 二手车保值率 | 风险轴 | 高客单 + 3–5 年换车周期,保值率 = 隐性成本的另一半 |
这四条意图,就是引擎扇出的四条主脉。 注意:用户一个字都没提「空间」「成本」「政策」「保值」,但引擎会替他补上——这正是 12.3.1 讲的「补全并推理」。
反直觉点:用户问的是「买什么」,但引擎真正要回答的是「像你这种情况,该怎么权衡」。你的内容能不能被引用,取决于你有没有替他把这四条权衡讲清楚,而不是你有没有把车型列全。
12.4.3 把四条意图展开成子问题清单(Fan-out 结果)
接下来沿四条扇轴把子问题展开。这一步就是「Query Fan-out 的显式化」:
| 母意图 | 扇出的子问题(引擎内部会问的) |
|---|---|
| ① 空间 | 30 万以内有没有真正的 7 座?第三排适合成年人吗?5 座 + 大后备厢 vs 7 座怎么选? |
| ② 油电成本 | 同价位油车与新能源,5 年总成本差多少?家里没私桩能不能买纯电?插混算不算「两头不靠」? |
| ③ 政策与售后 | 本地有没有新能源牌照便利?补贴/置换政策是什么?品牌在本地的售后网点够不够密? |
| ④ 保值 | 这个价位段 3 年保值率排名大概什么水平?新能源保值率是不是普遍更低?哪些因素最影响出手价? |
做到这一步,你的内容矩阵其实已经自动生成了——上表每一格的「子问题」,都是一个可以独立成块去写的答案。把它们归到五类意图层:
| 子问题族 | 落到意图层 | 内容形态 |
|---|---|---|
| 空间 | 决策型 | 场景→方案 映射表 |
| 油电成本 | 价格型 | 五年总成本测算(带口径与日期) |
| 政策与售后 | 信息型 + 风险型 | 政策解读 + 服务半径清单 |
| 保值 | 风险型 | 保值率影响因素 + 正反例 |
12.4.4 从子问题到内容包:四个内容组件
把上面的子问题组织成四个「可整句摘抄」的内容组件(写法见 12.3.6),每个组件锁定一个意图:
组件 A|空间决策块(决策型)
【问题】30 万以内,一家五口 + 偶尔带老人,要不要买 7 座?
【结论】若每月满载 6–7 人出行 ≥3 次,7 座 SUV 值得;否则 5 座 + 大后备厢更实用、更省油、保值更好。
【依据】该价位 7 座 SUV 第三排多为「应急座」,腿部空间普遍不足 20 厘米。
【判定】把「满载频率」和「常坐人数身高」列成两行,就能自己算出来。
组件 B|油电五年总成本块(价格型)
【问题】同价位油车 vs 新能源,五年一共差多少钱?
【结论】对比必须按「购车 + 能源 + 保养 + 保险 + 残值」五项加总,只比油电单价会得出相反结论。
【依据】(示例口径)按年行驶 1.5 万公里、家充 0.5 元/度测算,并标注测算日期与假设。
【判定】列出你的年里程与是否有私桩;无私桩时结论会显著向油车/插混倾斜。
组件 C|政策与售后块(信息型 + 风险型)
【问题】买新能源在本地有什么政策便利?售后网点够不够?
【结论】政策与网点是「地域变量」,必须按城市分别说明;同一车型在不同城市的结论可能相反。
【依据】逐城列出:牌照/路权政策、补贴与置换、品牌授权服务点数量与半径。
【判定】以「最近服务点到你常活动区域的距离」为落地判据,超过某一阈值要提示风险。
组件 D|保值率块(风险型)
【问题】这个价位的车三年后能卖多少?
【结论】保值率受品牌、动力形式、车型热度、车况与出售渠道共同影响,不存在单一排名可以照抄。
【依据】按「动力形式 → 品牌 → 车型热度 → 车况」四层拆解影响因素(口径与时间窗必须标注)。
【判定】把「三年保值率」换算成「三年折旧金额」,用户才感知得到它的分量。
四个组件合起来,才是一个完整的「30 万以下 SUV」答案的物质基础。 缺任何一块,你在那一脉子问题里就是空白。
12.4.5 从内容包到信源:四个落点
同一批内容组件,要铺到它最容易被采信的信源上(12.2.4、第 9 章):
| 组件 | 优先信源类型 | 理由 |
|---|---|---|
| A 空间决策块 | 场景化指南 / 可核查的用户经验 | 决策型偏好「像我一类人」的实证 |
| B 油电成本块 | 带日期与口径的自有数据页 | 价格型偏好可回源的数字 |
| C 政策售后块 | 本地化的官方口径解读页 | 信息型/风险型偏好权威 + 地域精确 |
| D 保值率块 | 结构化对比 + 第三方测算 | 风险型偏好可核验的对照 |
提示:国内版引擎的检索与生态偏好,需以第 8 章的实测方法自行校准;本教材为国内版,面向外贸与跨境电商的国际版教程开发中,国际信源差异另章讨论。
12.4.6 汽车赛道的五维意图(把 SUV 例子放大到全赛道)
一个「30 万 SUV」问句只能覆盖选车环节。整个汽车赛道的意图还要往外扩——按用户与车的关系,可归为五维:
| 维度 | 用户在想 | 意图层重心 |
|---|---|---|
| 选车 | 买什么、值不值、有没有坑 | 对比型 / 决策型 / 风险型 |
| 用车 | 怎么开更省、日常注意什么 | 信息型 |
| 养车 | 保养周期、维修成本、保险 | 价格型 / 信息型 |
| 卖车 | 什么时候卖、能卖多少 | 价格型 / 风险型 |
| 服务 | 售后网点、救援、权益 | 信息型 / 风险型 |
关键:多数汽车内容只做「选车」,而 AI 与用户交互的触点遍布五维。只做选车 = 主动放弃五分之四的意图面。
12.4.7 汽车赛道的合规红线(写内容前先划界)
高卷入 + 强监管 = 汽车内容有明确的表述禁区。以下四类表述是高危的,写内容时必须以「可核查、不承诺、不绝对化」为纪律:
| 高危表述 | 风险 | 安全写法 |
|---|---|---|
| 续航/能耗的绝对化标称 | 实测口径与标注口径不一致,易被认定误导 | 注明工况、温度、载荷与测试条件 |
| 自动驾驶能力夸大 | 夸大辅助驾驶等级,涉安全与合规 | 只用规范性术语,注明「辅助」与责任边界 |
| 保值/回购承诺 | 承诺回购或保底残值,涉金融与承诺风险 | 只讲影响因素与历史区间,不做承诺 |
| 强制搭售(装潢包等) | 捆绑销售违规 | 明确「可选」与「不选也可提车」 |
纪律:能核查的写清楚,不能承诺的不写。 这条纪律在房地产赛道上会更严格(见 12.5.6)。
12.4.8 深讲:为什么「参数表」几乎进不了答案
回到 12.4.1 那篇《30 万元以内 SUV 车型推荐》。它为什么进不了答案?三个原因:
- 参数是「公共知识」,不是「答案」。车型参数引擎自己就能汇总,它需要的是判断——「像我这种情况该选哪个」,而不是一张谁都能列的表格。
- 表格违反「可摘抄」。一张大表里没有一句能直接摘出来当答案的结论句。
- 缺处境。没有「谁、什么预算、什么频率」,引擎无法把这张表与用户的处境对上号。
结论:汽车内容的竞争力不在「参数全」,而在「把参数翻译成用户处境下的判断」。一张表 + 一句结论,往往比十张表 + 零结论更有效。
12.4.9 空间脉深讲:把「要不要 7 座」写成一棵决策树
「要不要买 7 座」不是一个是非题,而是一棵三层的决策树。把它写出来,比写十句「空间大」都有用:
问:30 万以内,我该买几座?
 │
 ├─ 每月满载 6–7 人的次数 ≥ 3 次?
 │    ├─ 是 → 7 座 SUV(接受第三排为应急/短途座)或直接上 MPV
 │    └─ 否 → 继续
 ├─ 有固定车位、且不需要第三排?
 │    ├─ 是 → 5 座 + 大后备厢(更省油、更保值)
 │    └─ 否 → 继续
 └─ 常坐乘客里有 ≥ 2 人身高 > 175cm?
      ├─ 是 → 优先第二排腿部空间与坐垫长度,而非第三排
      └─ 否 → 按预算自由取舍
为什么决策树有效:引擎扇出的子问题本身就是「分叉型」的。你用一棵树回答,等于一次性覆盖了它可能问的所有分支——树比段落更接近引擎的取材方式。
12.4.10 成本脉深讲:五年总成本的「五项加总」口径
「油车和新能源哪个省」之所以吵不出结论,是因为多数人在比「油电价」,而不是比「总成本」。正确口径必须五项加总:
| 项 | 内容 | 最容易漏的地方 |
|---|---|---|
| 购车 | 车价 + 购置税/补贴后的落地价 | 补贴是否已退坡 |
| 能源 | 油费 / 电费(按年里程换算) | 有无私桩,电价差可达数倍 |
| 保养 | 周期 + 单次费用 × 次数 | 新能源并非「免保养」 |
| 保险 | 首年 + 逐年 | 新能源保费普遍偏高 |
| 残值 | 五年后卖出价(负成本) | 不折现也不标注口径 |
纪律:这张表每一个数字都必须带「口径 + 日期」(第 6 章「可核查」)。没有口径的总成本,引擎不会采信。
12.4.11 政策脉深讲:为什么政策内容必须「按城分说」
购车政策(牌照、路权、补贴、限行、置换)是地域变量,同一台车在不同城市的结论可能完全相反。于是:
| 做法 | 结果 |
|---|---|
| 写一篇「全国通用」的政策解读 | 对每座城市都只对一半 → 谁都不敢信 |
| 按城市分别成文(或按城市分区成节) | 每个用户都能对上号 → 可核查、可引用 |
打法含义:政策类内容天然是「一城一文 / 一城一节」的。这也是本系统把「区域」作为一层独立维度的原因——地域是政策的单位,也是用户信任的单位。
12.4.12 风险脉深讲:保值率不是一张排名,是四层归因
用户问「保值吗」,想要的其实不是排名,而是「为什么」。把保值率拆成四层归因,内容才有说服力:
| 层 | 影响因素 | 用户可做的判断 |
|---|---|---|
| 动力形式 | 新能源整体残值波动更大 | 打算 3 年内换车 → 更看重这一层 |
| 品牌 | 品牌口碑与二手流通性 | 小众品牌出手更难 |
| 车型热度 | 该车型的市场存量与需求 | 停产的车型残值会跳水 |
| 车况/里程 | 事故、里程、保养记录 | 自己可控,能拉高出手价 |
技巧:把「保值率」换算成「三年折旧金额」(例如:三年后大约少卖 ×× 元),用户的感知会立刻从「抽象百分比」变成「真金白银」。
12.4.13 四脉汇总:一张表看全「30 万以下 SUV」
把 12.4.2–12.4.12 的所有产出拉到一张表:
| 脉 | 母意图 | 代表子问题 | 内容块 | 信源落点 | 意图层 |
|---|---|---|---|---|---|
| 空间 | 家庭多成员出行 | 要不要 7 座?第三排能否坐大人? | 空间决策树(12.4.9) | 场景化指南 | 决策型 |
| 成本 | 燃油/新能源用车成本 | 五年总成本差多少?没私桩怎么办? | 五年五项加总(12.4.10) | 带口径数据页 | 价格型 |
| 政策 | 购车政策与售后网点 | 本地补贴/牌照?售后多远? | 按城分说(12.4.11) | 本地官方口径 | 信息型+风险型 |
| 风险 | 二手保值率 | 三年后能卖多少?为什么? | 四层归因(12.4.12) | 结构化对比 | 风险型 |
四个内容块 + 四类信源 = 一个完整答案的物质基础。 缺任何一块,你在那一脉子问题里就是空白。
12.4.14 小结与自检
- 用户问「30 万以下 SUV」,引擎实际在回答四条意图:空间 / 油电成本 / 政策售后 / 保值;
- 每条意图 → 一组子问题 → 一个内容块 → 一类信源;
- 汽车赛道有五维意图,别只做「选车」;
- 合规先行:不绝对化、不承诺、不搭售。
自检:把你行业里最热的一个笼统问句,按本节四步走一遍(解析意图 → 扇出子问题 → 写四个内容块 → 定四个信源)。若中途卡住,卡在哪一步就是你团队的短板。
12.5 房地产为什么必须区分意图类别(🟠 高阶)
12.5.1 房 vs 车:同是高卷入,房地产多了「位置不可再生」
房地产与汽车共享 11.1 的共同点,但房地产多了一个汽车没有的变量:位置不可再生,且强绑定生活半径。于是:
| 变量 | 汽车 | 房地产 |
|---|---|---|
| 标的可替代性 | 高(换个品牌即可) | 低(同一地段不可复制) |
| 决策锚点 | 产品参数 | 地理位置 + 生活场景 |
| 变量来源 | 厂商 + 政策 | 地段 + 政策 + 学区 + 规划 + 周期 |
| 意图分歧度 | 中 | 极高 |
位置不可再生,意味着用户为了「我这种情况」愿意反复追问——同一套房子,对甲是安家、对乙是投资、对丙是学区、对丁是退路。这就是为什么房地产比汽车更需要「区分意图」。
12.5.2 不区分意图的代价:把「投资」当「刚需」讲,两拨人都不买单
一个常见的失败案例:一个项目把内容写成「低总价、高潜力、稀缺江景」这类「万能卖点」。它在三类人眼里同时失效:
| 用户 | 看到「低总价、高潜力」时的反应 | 失效原因 |
|---|---|---|
| 刚需自住 | 「高潜力关我什么事,我只关心月供压不压得住」 | 讲了投资语言,没讲他的现金流 |
| 改善置换 | 「低总价说明品质一般,我要的是大空间和好学区」 | 价格诉求与他的诉求错位 |
| 投资 | 「净说潜力不给数字,没有可核查的租金/去化口径」 | 没有决策型证据,只有形容词 |
同一篇内容,三种人各自都「读不下去」。这就是「不区分意图」最典型的代价:内容成本照付,三类意图全落空。
12.5.3 五类意图层在房产上的具体形态
把 12.2.2 的五层意图落到房产,每一层都有鲜明的本地化形态:
| 意图层 | 房产上的典型问法 | 内容形态 |
|---|---|---|
| 信息型 | 「××板块是什么样的」「新房和二手房有啥区别」 | 板块指南、产品形态科普 |
| 价格型 | 「预算 300 万在××能买什么」「隐性费用有哪些」 | 价格带(带日期)+ 费用清单 |
| 对比型 | 「××板块 vs 相邻板块」「新房 vs 二手」 | ≥5 维对照表 + 适用人群 |
| 决策型 | 「首套 + 孩子上学,怎么选」 | 处境→方案映射、决策树 |
| 风险型 | 「买这个盘有什么坑」「学区会不会变」 | 风险清单 + 合规边界 |
12.5.4 意图决定内容形态:四套完全不同的内容
同一个楼盘,按意图要写四套内容,彼此不可互相替代:
| 意图 | 内容标题(示例) | 核心证据 |
|---|---|---|
| 学区型 | 《××盘对口学校与入学口径一次说清》 | 划片政策 + 落户/学位口径 |
| 通勤型 | 《在××上班,××盘通勤多久、路况如何》 | 通勤时间 + 路网 + 高峰实测 |
| 价格型 | 《××盘 2026 年 9 月总价带与隐藏成本》 | 总价区间 + 税费/物业/车位 |
| 风险型 | 《买××盘的 5 个风险点》 | 交付、规划、噪音、产权、配套 |
如果你把「学区」「通勤」「价格」「风险」塞进同一篇,引擎无法从中摘出一个完整子答案(回到 12.3.6)。
12.5.5 意图决定信源:房产的高权重与低权重信源
房产用户的信任结构很特殊——他们对「离钱近、离规则近」的信源更敏感:
| 信源类型 | 相对权重 | 适配意图 |
|---|---|---|
| 官方口径(规划/教育/权属) | 高 | 信息型 / 风险型 |
| 可核查的成交与价格数据 | 高 | 价格型 |
| 结构化区域对照 | 中高 | 对比型 |
| 场景化居住指南 | 中 | 决策型 |
| 纯营销物料 | 低 | —— |
打法含义:房产内容要「先立规则与事实,再谈感受」。感受类内容权重低,且最容易踩合规红线。
12.5.6 意图决定合规边界(本赛道最硬的一条)
这是房地产区别于汽车的关键:「投资升值」类表述在房地产营销里是高压线。
| 意图 | 合规要求 | 禁止的写法 |
|---|---|---|
| 投资型 | 只讲可核查的事实与影响因素,不承诺、不暗示升值 | 「稳涨」「必涨」「包租」「返租」「保值回购」 |
| 学区型 | 只引用划片口径,注明政策可能调整 | 「保入学」「直通名校」「学区承诺」 |
| 落户/资格型 | 只引政策原文,不做「不限购」保证 | 「不限购」「包落户」 |
| 价格型 | 价格必须带日期与口径 | 无来源的「抄底价」「历史最低」 |
铁律:意图决定了「什么能说、什么绝不能说」。 把「投资」当「刚需」讲,不只是无效,而是违规。本系统在房地产专版里内置合规红线校验,正是为了让这条边界在生成阶段就被拦住,而不是发布后再返工。
12.5.7 房产五类意图的「问法库样例」(可直接抄进问句池)
下表是每类意图的典型问法。建问句池时,每类至少保证有可用的样本,否则对应内容写出来也是「自嗨」:
| 意图层 | 问法样例(保留用户口吻) |
|---|---|
| 信息型 | 「首套房和改善房到底差在哪」「限竞房/共有产权是啥」 |
| 价格型 | 「预算 300 万在 ×× 能买多大」「买新房还要交哪些钱」 |
| 对比型 | 「×× 板块和 ×× 板块怎么选」「新房和二手,哪个流程简单」 |
| 决策型 | 「首套 + 孩子明年上学,预算 300 万怎么选」 |
| 风险型 | 「买这个盘有什么坑」「学区会不会划走」「二手会不会有产权问题」 |
用法:把问法库按「意图层 × 身份 × 阶段」三维挂架(见 12.6),每条问法都能定位到一个网格格。
12.5.8 四联表:意图 × 内容 × 信源 × 合规
把四个变量拉到一张表上,一张纸就能管整个房产内容矩阵:
| 意图层 | 内容形态 | 优先信源 | 合规边界(不可写) |
|---|---|---|---|
| 信息型 | 板块/产品指南 | 官方口径 + 百科式 | 不编造规划 |
| 价格型 | 总价带(带日期)+ 费用清单 | 带口径的数据页 | 不写无来源「抄底价」 |
| 对比型 | ≥5 维对照表 | 结构化区域对照 | 不贬低竞品到违规 |
| 决策型 | 处境→方案映射 | 场景化指南 | 不替用户做「包入学」类承诺 |
| 风险型 | 风险清单 + 正反例 | 监管/官方口径 | 不暗示升值、不包租返租 |
12.5.9 深讲:意图错配 = 最高成本的一种无效内容
把前面几点合起来看,会得到一个反直觉的成本结论:
在房地产赛道,「内容写错意图」比「内容写得不漂亮」贵得多。
因为「写得不漂亮」只是引用率低;而「写错意图」是内容成本照付 + 合规风险上身 + 用户体验受损三重损失。这也解释了为什么本系统的房地产专版不是「多写几篇」,而是先把意图分类固化成结构,再让内容在结构里对号入座。
12.5.10 陷阱与避坑
- 陷阱一:用「万能卖点」覆盖所有人。万能 = 对谁都无效。
- 陷阱二:只在价格型用力。价格型好写,但决策型与风险型才是转化入口。
- 陷阱三:把投资话术当通用话术。在房产上这是合规问题,不是风格问题。
自检:打开你项目的任一内容页,能否判断它是为「哪一类意图」写的?如果它同时想服务三类意图,基本可以判定三边都不讨好。
12.6 房地产专版:为什么必须做用户身份模拟(🟠 高阶)
11.5 解决了「问什么」(意图)。这一节解决更难的一层:谁在问(身份)。这是本系统房地产专版与通用版最大的差别所在。
12.6.1 意图是「问什么」,身份是「谁在问」
| 维度 | 意图 | 身份 |
|---|---|---|
| 回答的问题 | 用户在问什么 | 用户是谁、处于什么处境 |
| 例 | 「学区房怎么选」(决策型) | 刚需首套 / 改善置换 / 投资 / 学区刚需 / 租转买 / 返乡置业 |
| 不覆盖的后果 | 漏掉一类问法 | 同一条问法,答案答错人 |
关键洞察:同一条意图,不同身份需要的答案完全不同。 所以只做意图分层还不够——必须再把「身份」这一维叠上去。
12.6.2 同一条意图,不同身份的答案完全不同
以「学区/教育配套」这条意图为例,六类身份要的答案南辕北辙:
| 身份 | 他在意的是 | 他要的结论形态 |
|---|---|---|
| 刚需 | 能不能上车 + 月供压不压得住 | 总价带 + 月供测算 + 首付方案 |
| 改善 | 学校质量 + 居住品质是否同步提升 | 学位口径 + 户型/社区对照 |
| 投资 | 学区溢价是否可持续、流动性如何 | 可核查的溢价与去化口径 |
| 学区刚需 | 入学口径 + 落户时点 + 政策风险 | 划片政策 + 时间窗 + 变动风险 |
| 租转买 | 从租到买的成本跃迁可不可承受 | 租金 vs 月供对照 + 过渡方案 |
| 返乡置业 | 长期持有 + 异地管理是否可行 | 持有成本 + 出租/托管方案 |
如果把「学区」只写成一段「名校环绕」,这六类人里没有一类会觉得「这是给我的」。
12.6.3 六类身份人设(专版的身份维)
本系统房地产专版把「身份」固化为六类人设,作为问法生成的第二个维度:
| 人设 | 处境摘要 | 首要意图层 |
|---|---|---|
| 刚需 | 首次置业、预算紧、看重月供 | 价格型 / 决策型 |
| 改善 | 已有一套房、要换更好的 | 对比型 / 决策型 |
| 投资 | 追求保值与流动性 | 价格型 / 风险型 |
| 学区 | 孩子入学是硬约束 | 信息型 / 风险型 |
| 租转买 | 从租房过渡到买房 | 决策型 / 价格型 |
| 返乡置业 | 异地购房、长期持有 | 信息型 / 风险型 |
注意:这六类不是「编出来的用户画像」,而是问法生成的维度——目的是让问法池的覆盖不出现结构性盲区(见 12.6.6)。
12.6.4 五个决策阶段(专版的阶段维)
身份之外,还要叠上「阶段」。用户在不同阶段问法完全不同(12.2.6):
| 阶段 | 用户状态 | 典型问法 |
|---|---|---|
| 看房 | 开始接触标的 | 「这个盘怎么样」「板块如何」 |
| 对比 | 在几个选项间摇摆 | 「A 盘 vs B 盘」「新房 vs 二手」 |
| 决策 | 准备做决定 | 「我这种情况选哪个」 |
| 交易 | 走流程 | 「首付/税费/贷款怎么算」 |
| 持有 | 已购或长期持有 | 「持有成本」「出租/转手」 |
12.6.5 22 维决策 × 660 覆盖网格:身份模拟为什么需要「网格」
到这里,房地产专版的结构就清楚了——三条轴建一个网格:
22 维决策   (问什么 — 决策维度)
  ×  6 类身份 (谁在问 — 身份)
  ×  5 个阶段 (什么时候问 — 阶段)
  = 660 覆盖网格
| 要素 | 数量 | 作用 |
|---|---|---|
| 决策维度 | 22 | 划分「问什么」的坐标系 |
| 身份人设 | 6 | 划分「谁在问」 |
| 决策阶段 | 5 | 划分「什么时候问」 |
| 覆盖网格 | 660 | 22 × 6 × 5,用于检查覆盖是否有盲区 |
| 问法库总量 | 2,420 | 实际生成的问法条数 |
| 能力组件 | 102 | 承接与评估的组件化能力数 |
对外统一口径:22 维决策 · 2,420 问法 · 660 覆盖网格 · 102 能力组件。
📷 截图 TODO:房地产专版「身份 × 阶段 × 决策维度」覆盖网格的抽检界面——用一张图说明「哪一格是空的、哪一格已覆盖」。
为什么必须是网格,而不是「几篇好文章」? 因为只有网格才能回答一个可检查的问题:「刚需 + 看房阶段 + 第 7 个决策维度」这一格,我到底有没有内容? 内容矩阵一旦网格化,盲区就是可见的、可补的;而「挑几篇重点写」的写法,盲区永远不可见。
12.6.6 身份模拟的本质:不是「编人设」,而是「消灭单一人设假设」
有一个常见误解:既然要「模拟用户身份」,是不是要编造一个具体用户、然后假装跟他对话?不是。
身份模拟的真正作用,是强制系统不去假设「所有人都一样」:
| 做法 | 效果 |
|---|---|
| 不模拟身份(默认「一个用户」) | 问法池里 100% 是「通用问法」,盲区不可见 |
| 模拟 6 类身份 | 问法池里每一类身份都被覆盖,结构性盲区消失 |
它是「问题发生器」,不是「证据工厂」——它负责确保「该问的都问了」,不负责回答「答案是什么」。
12.6.7 身份模拟 ≠ 证据:绝不污染真实证据基座
这是本章最重要的一条工程纪律,必须讲清楚:
身份模拟只用来生成「问法」,绝不用来生成「AI 的应答」或「引用证据」。
为什么?因为整个系统的评估(谁被引用、被怎么提及、情感如何)都必须建立在真实 AI 应答之上。如果为了让某个身份「有数据」,就用模拟内容去填充证据层,那么后续的引用率、提及率、情感分析全部失真——这是数据污染,比缺数据更糟。
正确的分工是:
| 层 | 谁提供 | 用途 |
|---|---|---|
| 问法层(问题) | 身份模拟 + 阶段 + 维度 生成 | 确保提问覆盖无盲区 |
| 证据层(应答/引用) | 真实引擎采样 采集 | 唯一可信的评估依据 |
一句话:模拟负责「问得全」,采样负责「答得真」。两者绝不能混。
12.6.8 深讲:为什么「一套话术打天下」在这个赛道必然失效
把 12.6.2–12.6.5 连起来看,答案已经很清楚:因为「一套话术」等价于「在 660 格里只填了 1 格」。
| 做法 | 覆盖网格 | 结果 |
|---|---|---|
| 一套通用话术 | ≈ 1 / 660 | 极少数问法才命中,其余全盲 |
| 6 身份各一套 | ≈ 6 / 660 | 覆盖 6 倍,但仍缺阶段与维度差异 |
| 网格化覆盖 | 逐格补齐 | 覆盖度可持续提升,盲区可见 |
结论:在房地产这种「意图 × 身份 × 阶段」三重分歧的赛道,内容能否被引用,本质是一个覆盖度问题。这也是为什么本系统的房地产专版要把「身份模拟」做成一等公民,而不是写作时随手加点场景描述。
12.6.9 22 维决策清单(示例形态)
房地产决策的 22 个维度,可按「外部 / 产品 / 成本 / 长期」四组归类。这张清单本身就是一套内容大纲:
| 组 | 维度 |
|---|---|
| 外部环境(7) | 区位与板块 · 通勤半径 · 交通可达性 · 教育配套 · 商业配套 · 医疗配套 · 生态与噪音 |
| 产品本体(8) | 户型与得房率 · 面积与功能分区 · 采光与朝向 · 楼层与视野 · 装修标准 · 物业服务 · 社区品质 · 开发商与交付记录 |
| 成本价格(4) | 总价与单价 · 首付与月供 · 税费与持有成本 · 政策与购房资格 |
| 长期属性(3) | 产权与房龄 · 规划与兑现度 · 流动性与保值 |
7 + 8 + 4 + 3 = 22。每个维度都值得单独成文(对应内容块),而不应被塞进一篇「大而全」。
12.6.10 网格抽检三步法:怎么知道「哪一格是空的」
| 步 | 动作 | 产出 |
|---|---|---|
| 1 抽样 | 从 660 网格中按主题随机抽 N 格(如刚需×看房×教育配套) | 一份抽检清单 |
| 2 比对 | 逐格检查问法池与内容库:这一问题问了吗?有内容答吗? | 有/无 矩阵 |
| 3 补齐/记录 | 空格的补问法、排优先级;已覆盖的登记口径 | 更新后的覆盖表 |
要点:抽检的目的不是「证明覆盖了」,而是「找出没覆盖的那一格」。只报喜的抽检没有价值。
12.6.11 网格与评估的分工:网格管「问什么」,评估管「答得如何」
两件事必须分清,否则容易把「问题层」和「结果层」混为一谈:
| 层 | 作用 | 真源 |
|---|---|---|
| 覆盖网格(22×6×5) | 保证「该问的都问了」 | 问法库 / 意图结构 |
| 评估四维(AIVO) | 度量「答得怎么样」 | 真实引擎采样 |
AIVO 四维及其权重(强调可见性):
| 维度 | 含义 | 权重 |
|---|---|---|
| AI 搜索可见性 | 在 AI 答案里的曝光与引用 | 0.40 |
| 基建完备度 | 结构化、官网、事实源等技术基建 | 0.25 |
| 竞争位势 | 相对竞品的引用与推荐位置 | 0.20 |
| 情感健康度 | 被提及时的情感倾向 | 0.15 |
一句话:网格告诉你「问得够不够全」,AIVO 告诉你「答得够不够好」。两者都不可以互相代替。
12.6.12 网格抽样示例:一个真实的抽检片段
下面是一张抽检片段(列 × 行留空,填时照填)。它回答的问题是「哪一格是空的」:
| 身份 | 阶段 | 决策维度 | 该格该问什么 | 问法池有? | 内容库有? |
|---|---|---|---|---|---|
| 刚需 | 看房 | 教育配套 | 「预算 300 万,×× 学区能上车吗」 | ✅ | ⬜ |
| 改善 | 对比 | 户型与得房率 | 「×× 盘 120 平得房率多少」 | ⬜ | ⬜ |
| 投资 | 持有 | 流动性与保值 | 「×× 小区二手出手周期多长」 | ⬜ | ⬜ |
| 学区刚需 | 决策 | 政策与资格 | 「明年入学,×× 落户时点够吗」 | ✅ | ✅ |
| 租转买 | 决策 | 首付与月供 | 「租金 6000,买房月供多少才划算」 | ⬜ | ⬜ |
| 返乡置业 | 持有 | 税费与持有成本 | 「异地持有,物业/税费怎么算」 | ⬜ | ⬜ |
读法:⬜ 越多,说明「系统以为自己覆盖了,实际上是空的」。这份表就是行动清单:先把「问法池有、内容库无」的格补上(最容易见效)。
12.6.13 陷阱与避坑
- 陷阱一:把身份模拟当成「编故事」。它的产出应当是可归类的问法,不是虚构的叙事。
- 陷阱二:用模拟内容充当评估证据。违者数据失真(12.6.7)。
- 陷阱三:只覆盖「好写」的格子。网格的价值在于暴露你没写的那一格。
- 陷阱四:身份越多越好。维度失控会让网格爆炸;6 类是经验收敛的结果。
自检:你的项目能否回答「刚需 + 决策阶段 + 某个具体决策维度」这一格有没有内容?如果答不上来,说明你还在「挑着写」,没有网格化。
12.7 新房承销 vs 二手房中介:两套意图结构的打法差异(🟠 高阶)
房地产专版内部还有一条最容易被忽视、也最容易做错的分界线:新房承销与二手房中介,虽然都在「房地产」这个赛道里,但它们的意图结构完全不同。用一套打法通吃,结果往往是「越铺越不被引用」。
12.7.1 先分清两种生意:一个「项目制」,一个「门店制」
| 维度 | 新房承销 | 二手房中介 |
|---|---|---|
| 生意单元 | 一个楼盘 / 一批房源(项目制) | 一片小区 / 一张房源表(门店制) |
| 供给 | 集中、可控(开发商 + 渠道) | 分散、长尾(业主挂牌) |
| 标的数量 | 少(一个项目) | 多(成百上千套) |
| 时效 | 强(有销售节点/周期) | 中(随挂牌变化) |
| 交付主体 | 开发商 | 业主 + 中介居间 |
项目制决定了新房的内容是「一个标的,多个切面」;门店制决定了二手的内容是「多个标的,一个片区的可比性」。这个差别会一路传导到意图、信源、内容形态与合规。
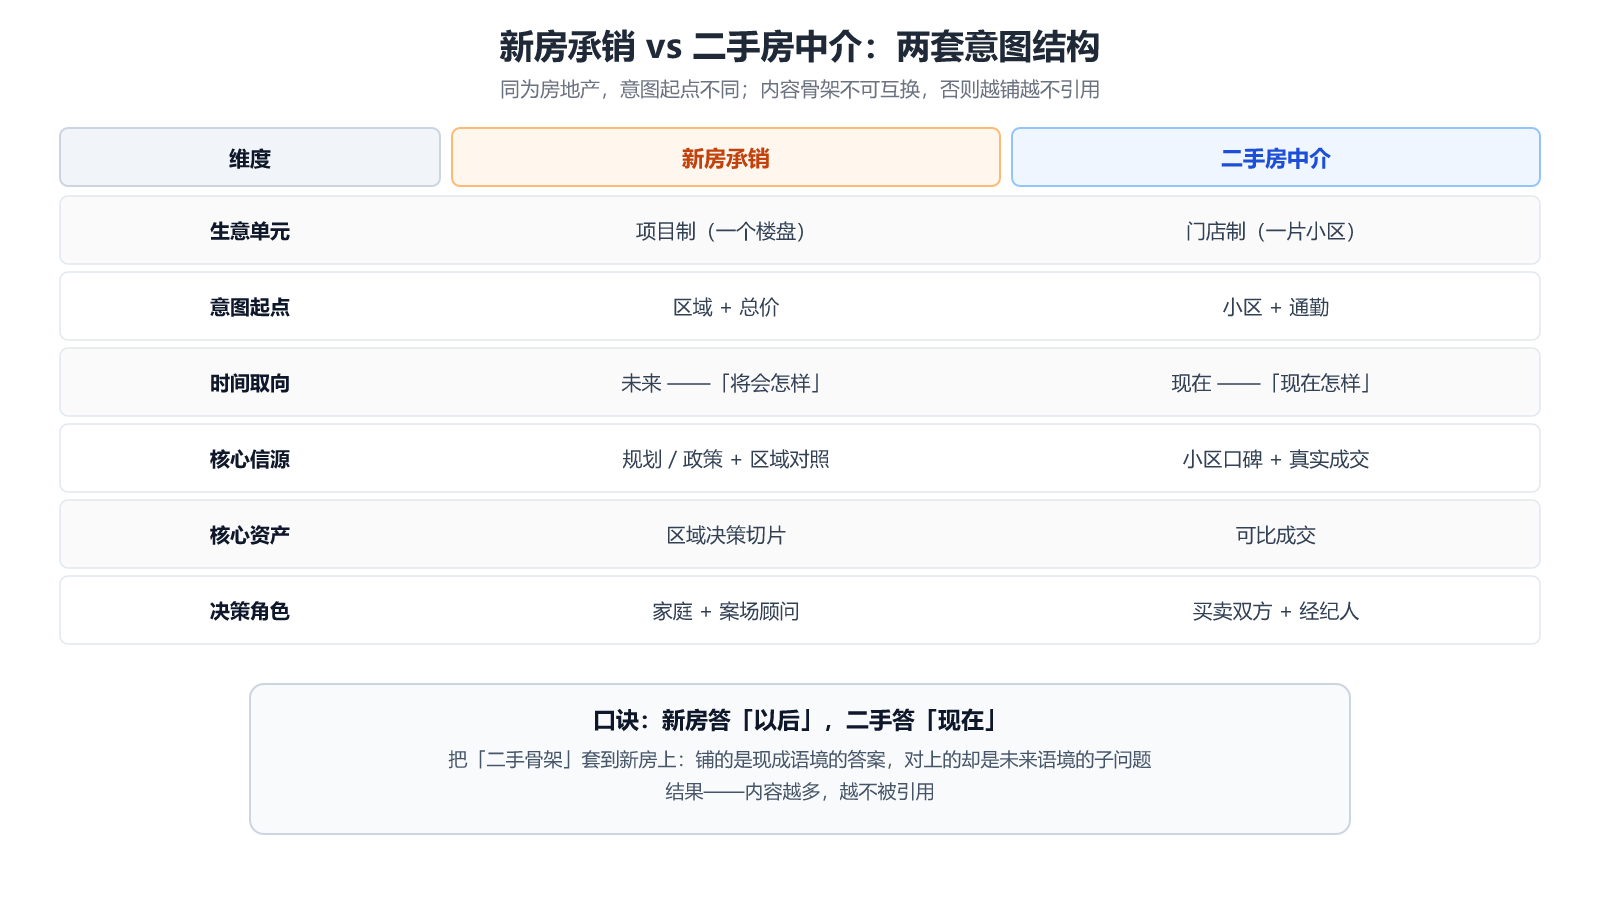
图 11-3 新房承销 vs 二手房中介:同赛道、不同经营形态,内容骨架不可互换(见图 11-3)。
12.7.2 意图起点不同:新房从「区域/总价」起,二手从「小区/通勤」起
| 新房承销 | 二手房中介 | |
|---|---|---|
| 用户第一句话常是 | 「××区域/××总价,有什么新房」 | 「××小区怎么样」「××上班买哪块」 |
| 意图锚点 | 区域 + 总价 + 规划预期 | 小区 + 通勤 + 房龄/学区现况 |
| 核心隐性意图 | 「未来会怎样」(规划、配套兑现) | 「现在是什么样」(现状、真实成交) |
| 时间取向 | 偏未来 | 偏现在 |
打法含义:新房内容要回答「将会怎样」(规划、兑现节奏、风险),二手内容要回答「现在怎样」(现状、可比成交、通勤实测)。把「未来叙事」用在二手、把「现状数据」用在新房,两边都别扭。
12.7.3 决策角色不同:新房是「家庭决策 + 案场」,二手是「买卖双方 + 撮合」
| 新房承销 | 二手房中介 | |
|---|---|---|
| 决策角色 | 家庭(夫妻 + 长辈)+ 案场顾问 | 买方 + 卖方 + 经纪人 |
| 决策摩擦点 | 「要不要买这个盘」 | 「价格谈不谈得拢」「房子有没有硬伤」 |
| 内容要替谁说话 | 替购房家庭把账算清 | 既要替买方看懂现状,也要替卖方讲清定价 |
| 最容易踩的坑 | 只讲项目优点,不讲家庭处境 | 只讲房源优点,不讲小区与楼层硬伤 |
12.7.4 信源结构不同:新房靠「区域决策切片 + 政策解读」,二手靠「小区口碑 + 真实成交」
| 信源类型 | 新房承销 | 二手房中介 |
|---|---|---|
| 规划/政策解读 | 高权重(未来兑现的依据) | 中(影响长期持有) |
| 区域对照(板块切片) | 高权重 | 高权重 |
| 小区口碑/居住体验 | 低(项目太新,缺历史) | 高权重 |
| 真实成交与可比价格 | 中(新房缺二手成交) | 高权重 |
| 通勤/生活实测 | 中高 | 高权重 |
一个产品细节:新房侧的核心资产是「区域决策切片」——把一个大区域拆成若干可比较的决策切片(按板块、通勤、总价、规划兑现度等),让用户与 AI 都能「切片级」地理解项目的位置。二手侧的核心资产则是「可比成交」——同小区、同户型、近期的真实成交对照。两者的内容骨架不同,不能互换。
12.7.5 内容形态不同:新房做「决策切片」,二手做「可比成交」
| 意图层 | 新房承销的内容形态 | 二手房中介的内容形态 |
|---|---|---|
| 信息型 | 板块指南 + 项目形态科普 | 小区全景 + 户型/楼层说明 |
| 价格型 | 总价带(带日期)+ 隐藏成本 | 挂牌 vs 成交对照 + 税费测算 |
| 对比型 | 板块间对照(≥5 维) | 小区间/楼栋间对照 |
| 决策型 | 「预算 N + 家庭处境 → 推荐切片」 | 「通勤 + 学区 + 预算 → 推荐小区」 |
| 风险型 | 规划兑现/交付/配套风险 | 产权/房龄/噪音/采光/税费风险 |
12.7.6 合规红线不同
两者共享 12.5.6 的房产高压线(不承诺升值、不承诺入学、不保落户),但各有侧重:
| 新房承销 | 二手房中介 | |
|---|---|---|
| 特有高压线 | 规划「承诺兑现」、学区「承诺划入」 | 「保证过户」「包办税费」「独家/低价保证」 |
| 容易出问题的地方 | 用规划利好做绝对化承诺 | 用「房源稀缺 + 逼单」话术 |
共同底线:能核查的写清楚,不能承诺的不写。 这条纪律在两种形态下都要前置到生成阶段。
12.7.7 一张对照表:14 个维度看两种打法
| # | 维度 | 新房承销 | 二手房中介 |
|---|---|---|---|
| 1 | 生意单元 | 项目制 | 门店制 |
| 2 | 供给结构 | 集中可控 | 分散长尾 |
| 3 | 标的数量 | 少 | 多 |
| 4 | 意图锚点 | 区域 + 总价 | 小区 + 通勤 |
| 5 | 时间取向 | 未来(规划) | 现在(现状) |
| 6 | 核心信源 | 规划/政策 + 区域切片 | 口碑 + 真实成交 |
| 7 | 核心资产 | 区域决策切片 | 可比成交 |
| 8 | 决策角色 | 家庭 + 案场 | 买卖双方 + 经纪人 |
| 9 | 内容骨架 | 决策切片 | 可比成交 |
| 10 | 最强意图层 | 决策型 / 风险型 | 对比型 / 价格型 |
| 11 | 时效压力 | 高(销售节点) | 中(挂牌变动) |
| 12 | 特有合规线 | 规划/学区承诺 | 过户/税费/低价保证 |
| 13 | 最易犯的错 | 只讲优点不讲处境 | 只讲房源不讲硬伤 |
| 14 | 覆盖网格重心 | 未来预期相关维度 | 现状与可比相关维度 |
12.7.8 深讲:为什么把二手打法套到新房上会「越铺越不引用」
一个真实常见的错误:新房团队照搬了二手的「小区口碑 + 真实成交」打法,于是拼命在内容里堆「小区评价」「历史成交」。结果是:
| 问题 | 原因 |
|---|---|
| 内容同质化严重 | 新房缺历史成交与真实口碑,只能反复堆同样的营销语 |
| 引擎摘不到子答案 | 因为新房用户关心的「规划兑现」「交付风险」这些子问题根本没被回答 |
| 越铺越不引用 | 铺的是「二手语境的答案」,对上的却是「新房语境的子问题」 |
根因:意图结构不同,内容再多也对不上号。 新房的子问题长在「未来轴」上(规划、兑现、风险),二手的子问题长在「现况轴」上(口碑、成交、通勤)。方向错了,量不解决任何问题。
12.7.9 对照案例:同一个「学区」诉求,新房与二手各写一篇
同样是「学区」,两种形态要写的内容完全不同:
| 新房承销 | 二手房中介 | |
|---|---|---|
| 标题 | 《××项目学区口径与入学时间窗》 | 《××小区对口学校与近年划片变化》 |
| 回答的核心问题 | 「以后会不会划进来」 | 「现在划在哪、学位有没有被占用」 |
| 关键证据 | 划片口径原文 + 落户时点 | 历年划片 + 真实成交 |
| 不可写 | 保证入学、承诺划入 | 保证入学、包办学位 |
判断口诀:新房答「以后」,二手答「现在」。两篇都写「名校环绕」的开头,两篇都会失效。
12.7.10 决策角色分工表:内容要替谁说话
高卷入赛道上,内容不能只讨好一个人,而要服务「一个决策结构」:
| 角色 | 新房承销 | 二手房中介 | 内容要照顾他什么 |
|---|---|---|---|
| 主决策人 | 家庭(夫妻) | 买方 | 算账 + 处境匹配 |
| 影响者 | 长辈(出资/同住) | 卖方(定价) | 居住体验 / 定价参考 |
| 专业方 | 案场顾问 | 经纪人 | 规则与流程口径 |
结论:房产内容不是「写给一个人看」,而是「帮一个决策结构把话说清」。
12.7.11 小结与自检
- 新房 = 项目制,答「将会怎样」,核心资产是「区域决策切片」;
- 二手 = 门店制,答「现在怎样」,核心资产是「可比成交」;
- 两者共享合规底线,但各有特有高压线;
- 绝不互换内容骨架。
自检:你手里的房地产内容,能否一眼看出它是「新房骨架」还是「二手骨架」?如果它既不是切片也不是可比成交,它大概谁都不服务。
12.8 方法清单:双赛道意图承接 SOP(🟠 高阶)
把本章方法落成一套可执行的流程。它同时适用于房地产与汽车。
12.8.1 七步 SOP
| 步骤 | 动作 | 产出 | 判定标准 |
|---|---|---|---|
| 1 | 收集真实问句 | 一批用户实际怎么问的话 | 保留原话,不改写成关键词 |
| 2 | 归意图层 | 每条问句归入五类意图之一 | 30 秒内能归类(12.2.5) |
| 3 | 展开 Fan-out | 每条母问题沿四扇轴展开子问题 | 每个母问题 ≥6 条子问题 |
| 4 | 叠身份与阶段(房产) | 子问题映射到 6 身份 × 5 阶段网格 | 能指出覆盖了哪几格、缺哪几格 |
| 5 | 写内容块 | 每个子问题一个「可整句摘抄」的块 | 结论 + 依据 + 判定三件齐全 |
| 6 | 定信源落点 | 每个块指定优先信源类型 | 与意图层匹配(12.2.4) |
| 7 | 合规前置校验 | 过一遍红线清单 | 无承诺、无绝对化、无搭售 |
12.8.2 一页速查表
┌─────────────────────────────────────────────────────────┐
│  双赛道意图承接 · 一页速查                                │
├─────────────────────────────────────────────────────────┤
│  ① 五类意图层  信息型 / 价格型 / 对比型 / 决策型 / 风险型  │
│  ② 四扇轴      场景 / 成本 / 政策 / 风险                  │
│  ③ 房产身份    刚需 · 改善 · 投资 · 学区 · 租转买 · 返乡   │
│  ④ 五阶段      看房 · 对比 · 决策 · 交易 · 持有            │
│  ⑤ 覆盖网格    22 维 × 6 身份 × 5 阶段 = 660              │
│  ⑥ 内容块      结论 + 依据 + 判定(可整句摘抄)            │
│  ⑦ 红线        不承诺 · 不绝对化 · 不搭售                  │
└─────────────────────────────────────────────────────────┘
12.8.3 常驻文档三件套
每个项目应常驻三份可复用的文档(与第 13 章工作流衔接):
- 意图—内容对照表:意图层 ↔ 内容形态 ↔ 信源类型,一张表管到底;
- Fan-out 子问题清单:母问题 → 子问题 → 内容块编号,滚动维护;
- 合规红线清单:按赛道分列禁区表述,发布前逐条勾选。
12.8.4 两周首轮闭环(呼应第 13 章)
- 第 1 周:完成步骤 1–4(收集 → 归层 → 展开 → 网格化),产出意图矩阵与子问题清单;
- 第 2 周:完成步骤 5–7(写块 → 定信源 → 过红线),先小批发布并回测引用,再决定放量。
写内容之前先测引用、先小后大,这条纪律与第 11 章「先测引用再投入」同源。
12.8.5 一个完整的 SOP 落地日程表(参考排期)
把七步 SOP 压进两周,可参考下面这张排期(按一人多角的小团队估算):
| 天 | 动作 | 产出 |
|---|---|---|
| D1 | 收集真实问句(≥50 条) | 问句池 v0 |
| D2 | 归入五类意图层 | 意图分布表(找出为零的那层) |
| D3 | 对 Top 5 母问题沿四轴扇出 | 子问题清单 v0 |
| D4 | 房产:叠 6 身份 × 5 阶段 | 覆盖网格初稿(标出空格) |
| D5–D7 | 写第一批内容块(每块≥6) | 内容块 v1 |
| D8 | 定信源落点 | 内容—信源对照表 |
| D9 | 合规前置校验 | 合规勾选记录 |
| D10 | 小批发布 + 挂监测 | 发布记录 |
| D11–D13 | 回收引用与提及,回填空格 | 覆盖表 v2 |
| D14 | 复盘:哪类意图最有效 | 下一轮优先级 |
关键纪律:D10 一定要「小批发布」,不要一周写完一次铺完——先用小成本验证哪类意图真的被引用,再放大(第 11 章的方法)。
12.9 思考与练习
🔵 入门级(概念确认)
- 用一句话说明「意图层」和「行业赛道」的区别。
- 举一个你知道的例子,说明「同一句问话,不同身份要不同答案」。
- 什么是 Query Fan-out?它和「关键词匹配」最本质的差别是什么?
🟡 进阶级(动手做一轮)
- 取一个你行业里的笼统问句,沿四条扇轴(场景/成本/政策/风险)写出 ≥8 条子问题。
- 把第 4 题的子问题归入五类意图层,并说明每类该配什么信源。
- 找出你现有的一篇内容,判断它是为「哪一类意图」写的;若不是单一意图,指出该怎么拆。
🟠 高阶(做成一件事)
- 用「30 万以下 SUV」的推演方法,把你自己的一个母问题做成「四个内容组件 + 四个信源落点」,并写出每个组件的结论句。
- 为你项目的房地产内容画一张「身份 × 阶段」小网格(6 × 5),标出你已有内容的格子和空白格子。
- 判断你手里的房产内容是「新房骨架」还是「二手骨架」;若混用,指出要重构哪些部分。
- 写一条你会踩的合规红线,并给出安全改写。
🔴 专家级(带一个团队跑一轮)
- 用 11.8 的七步 SOP,带一个 2–3 人小队跑完一轮两周闭环,产出一份「意图矩阵 + 子问题清单 + 内容块」三件套。
- 为你的项目画出完整的 660 覆盖网格(或按业务裁剪后的网格),并标出首轮要补的 10 个空格。
- 设计一张「抽检—回测」表,能回答「哪一格是空的」与「哪一格补完后真的被引用了」。
- 写一份《新房与二手内容骨架不可互用的说明》,附上各 3 条反例。
参考答案要点
- 第 1 题:赛道是「哪一类生意」,意图是「哪一种问法」;意图层更细、可直接对应内容形态与信源。
- 第 4 题:评分看「扇轴是否四条都覆盖」「子问题是否可独立回答」。
- 第 8 题:评分看「是否诚实标出空白格」——空白格可见即是进步。
- 第 10 题:评分看「是否做到不承诺、不绝对化」。
- 第 11 题(专家):评分看三件套是否齐全(意图矩阵 / 子问题清单 / 内容块),以及是否真的跑了回测而非只交文档。
- 第 12 题:评分看「是否诚实标出空格」与「是否给出补齐优先级」——只报喜的网格没有价值。
- 第 13 题:评分看抽检表能不能同时回答「哪格是空的」与「哪格补完真被引用了」这两问。
- 第 14 题:评分看反例是否真实(是否来自你自己的项目),而非泛泛而谈。
附 A:全赛道意图分层速查表
| 意图层 | 汽车问法 | 房产问法 | 内容形态 | 信源重心 |
|---|---|---|---|---|
| 信息型 | 「××是什么配置」 | 「××板块什么样」 | 科普/指南 | 官方口径 / 百科式 |
| 价格型 | 「油电五年差多少」 | 「预算 N 能买什么」 | 价格带 + 成本表 | 带日期与口径的数据页 |
| 对比型 | 「A 车 vs B 车」 | 「A 板块 vs B 板块」 | ≥5 维对照表 | 结构化测评 |
| 决策型 | 「一家五口怎么选」 | 「首套+学区怎么选」 | 处境→方案映射 | 场景化指南 |
| 风险型 | 「保值率/交付坑」 | 「学区会不会变」 | 风险清单 + 正反例 | 监管口径 / 真实经验 |
附 B:术语与代称对照
| 术语 | 含义 |
|---|---|
| 意图层 | 把用户问法归入的五类可操作层级(信息/价格/对比/决策/风险) |
| Fan-out(查询扇出) | 引擎把一个笼统问句展开为若干可独立回答的子问题 |
| 扇轴 | 子问题展开的四条方向:场景 / 成本 / 政策 / 风险 |
| 身份人设 | 房地产专版的六类用户处境(刚需/改善/投资/学区/租转买/返乡置业) |
| 决策阶段 | 看房 / 对比 / 决策 / 交易 / 持有 |
| 覆盖网格 | 22 维 × 6 身份 × 5 阶段 = 660,用于检查覆盖盲区 |
| 区域决策切片 | 新房侧把区域拆成可比决策单元的内容资产 |
| 可比成交 | 二手侧以真实成交为锚的对照资产 |
| 可整句摘抄的内容块 | 结论 + 依据 + 判定三件齐全的答案块(见第 5 章) |
代称说明:本教材为国内版,涉真实品牌、平台、工具、客户一律用「某××」代称;面向外贸与跨境电商的国际版教程开发中。国内主流 AI 引擎与本地信源的口径,以第 8 章实测方法自行校准。
附 C:一个代称化全案——把整章方法走一遍
场景:某区域新房项目(代称「A 区域某项目」)希望被 AI 在「A 区域买房」类问题中稳定引用。
第 1 步|收集真实问句(节选,均保留用户原话)
- 「预算 300 万在 A 区域能买什么样的房?」
- 「A 区域和隔壁 B 区域哪个更适合自住?」
- 「孩子明年上学,A 区域怎么选?」
第 2 步|归意图层
| 问句 | 意图层 |
|---|---|
| 预算 300 万能买什么 | 价格型 |
| A 区域 vs B 区域 | 对比型 |
| 孩子上学怎么选 | 决策型(+ 风险型) |
第 3 步|展开 Fan-out(以「预算 300 万能买什么」为例)
- 场景轴:三口之家 / 三代同住,分别要多大面积?
- 成本轴:总价 300 万的首付、月供、税费、物业各多少?
- 政策轴:本地首套资格、贷款政策、公积金如何使用?
- 风险轴:这个总价带里,交付与配套兑现的风险点在哪?
第 4 步|叠身份与阶段:把上述子问题映射到「刚需 + 看房阶段 + 价格维度」等具体格子。
第 5 步|写内容块(示例)
【问题】预算 300 万在 A 区域,三口之家能买多大?
【结论】按近期口径(须标注日期),300 万在 A 区域可覆盖约 ×× 平的改善型户型为主。
【依据】总价区间 + 单价口径 + 税费估算(标注来源时间窗)。
【判定】把「月供占家庭月收入比例」作为可承受性判据。
第 6 步|定信源落点:价格带 → 带日期的自有数据页;对比 → 结构化区域对照;风险 → 规划/交付的官方口径解读。
第 7 步|合规校验:全篇不出现「升值/保值/保入学」类承诺;价格全部带日期与口径。
第 8 步|回测与迭代
- 用真实采样回测上述内容块的引用情况,回填 12.6.10 的覆盖网格;
- 把「没被引用到的块」列出来,逐一问三个问题:子问题判错了吗?内容块不够可摘抄吗?信源落点选错了吗?
- 迭代后重测,形成「抽检 → 补块 → 回测」的小循环。
注意本全案的一条纪律:以上问法与内容块都由方法生成(属「问题层 / 内容层」);而引用率、提及率等评估结论,必须来自真实引擎采样,不得用模拟内容充当证据(12.6.7)。
附 D:双赛道常见问题 FAQ
Q1:我资源有限,五类意图层能只做两类吗? 能,但要明确代价:只做信息型与价格型,等于放弃决策型与风险型这两块转化入口。建议至少先做「价格型 + 风险型」,因为这两类最容易见效。
Q2:Fan-out 展开出来的子问题太多,写不完怎么办? 按「意图层 × 扇轴」排优先级:先写「引擎最可能取材 + 你最可能有优势」的格子,其余进滚动清单。覆盖是连续量,不是一次做完。
Q3:身份模拟会不会让系统「编造」用户? 不会,只要守住 12.6.7 的分工——模拟只生成问法,不生成证据。
Q4:汽车赛道也要做身份模拟吗? 汽车的用户身份分歧小于房产(主要是单人/家庭、首购/换购),可用更轻的维度;但五维意图(选/用/养/卖/服务)必须覆盖。
Q5:为什么承销和中介不能共用一套内容? 因为意图起点(未来 vs 现在)与核心资产(切片 vs 可比成交)不同,共用会导致「子问题对不上号」,越铺越不引用(12.7.8)。
Q6:本地政策经常变,内容怎么维护? 政策类内容天然有「保鲜期」。做法:每篇政策文头部标注「口径日期」,并设「季度复核」节奏;内容里把「会变的」与「不会变的」分开写,前者可整段替换。
Q7:内容块写得很短,会不会显得单薄? 不会。「可整句摘抄」优先于「篇幅长」。一个 5 行的结论块,比一段 30 行的铺垫更容易被引擎采纳。单薄的是「只写结论不写依据」,不是「块本身短」。
Q8:意图层和身份、阶段,到底先做哪个? 先做意图层(5 类),再做身份(6 类),最后叠阶段(5 个)。理由:意图层是所有赛道通用的底座;身份与阶段是房产专版的加成。汽车赛道可以只用「意图 × 五维」。
Q9:这套方法适合小团队吗? 适合,且小团队更该用——因为小团队最怕「铺了很多没人引用」。七步 SOP 的第 1—4 步(收集 → 归层 → 扇出 → 网格)几乎不花钱,却能把「铺得准不准」提前管住。
Q10:怎么验证我做的「意图分层」是对的? 用真实问句回归检验:把你分好类的问法丢回用户侧,看真实用户是不是也这么问;再回测内容,看「按意图分写的版本」是否比「大而全版本」被引用得更多。用数据验证分类,而不是靠感觉。
附 E:双赛道问法库样例集(20 条,可直接入库)
以「用户原话」形态入库,不要改写成关键词。左列为汽车,右列为房地产。
| # | 汽车问法 | 房地产问法 |
|---|---|---|
| 1 | 30 万以内买什么 SUV 全家都能坐 | 预算 300 万在 ×× 能买什么样的房 |
| 2 | 油车和新能源五年到底差多少钱 | 首付和月供怎么算才不踩坑 |
| 3 | 家里没充电桩能不能买纯电 | 新房和二手哪个流程更简单 |
| 4 | 这个价位哪款保值率最高 | 现在是不是买房的好时机 |
| 5 | 7 座 SUV 第三排能坐大人吗 | 学区房现在买还有意义吗 |
| 6 | 保养一年要花多少 | 买这个盘以后配套能兑现吗 |
| 7 | 新能源保费是不是更贵 | 二手房的税费都有哪些 |
| 8 | 换车什么时候卖最划算 | 租房还是买房,怎么比才算公平 |
| 9 | 本地有什么购车补贴 | 落户/购房资格怎么查 |
| 10 | 售后网点离我远不远 | 这个小区通勤到 ×× 要多久 |
用法:每条问法归入五类意图层 → 挂到「身份 × 阶段」网格 → 对应到一个内容块编号。
附 F:意图 × 扇轴 交叉矩阵(空白模板,可直接复制)
把下面的空白表复制进你的项目文档,逐格填「该格要答的子问题」。没填的格就是盲区。
| 意图层 \ 扇轴 | 场景轴 | 成本轴 | 政策轴 | 风险轴 |
|---|---|---|---|---|
| 信息型 | ||||
| 价格型 | ||||
| 对比型 | ||||
| 决策型 | ||||
| 风险型 |
填法:每格至少写 1 条子问题;写不出来的格,就是下一轮内容的优先项。填满后,把每个子问题编号,与内容块一一对应。
附:全章快速自查卡片(可直接用于项目评审)
□ 收集的是「用户原话」,不是改写成关键词的版本?
□ 每条问句都能归入五类意图层之一?
□ 每个母问题都沿四扇轴展开了 ≥6 条子问题?
□ 房产项目是否叠了「6 身份 × 5 阶段」,并标出空白格?
□ 每个子问题都有「结论 + 依据 + 判定」三件齐全的内容块?
□ 每个内容块都指定了优先信源类型?
□ 全篇无「承诺/绝对化/搭售」类表述?
□ 评估结论来自真实采样,未混入模拟内容?
□ 新房/二手内容骨架未混用?
🔗 下一章:第 13 章《GEO 工作流五步》——本章产出的「意图矩阵 + 子问题清单 + 内容块」,将在下一章被装进「Query 研究 → 信源选择 → 内容生产 → 分发矩阵 → 监测迭代」的五步闭环里,跑成一个可复用的两周周期。请带着你的意图矩阵进入下一章。
附录:术语表 · 案例速查 · 参考答案 · 实操挂钩
附录 · 4 节 / 30 小节 · 约 1.5 万字
全教材速查总汇:本附录是全教材的「终极速查入口」——把正文 12 章散落的跨章术语、关键案例、参考答案与实操闭环串成一张总表:名词以附录 A 为准、动作照附录 B、答案对附录 C、落地走附录 D,与前言的导航和各级路径及各章互链保持同源一致。
说明:本章是全书的「知识速查与学习配套」。它不做新知识输出,而是把正文散落在各章的概念、案例、练习与学习中心的操作串成三样东西——一张能随时查的术语地图(附录 A)、一张能照着套的案例动作清单(附录 B)、一份能在课后自查的参考答案(附录 C),以及一个把这个教材和平台学习中心绑在一起的实操挂钩表(附录 D)。读正文时遇到名词记不清,回附录 A;做完练习没把握,对照附录 C;想把方法论变成能力,用附录 D 的流程走一遍。
附录 A · 术语表
全表按主题分七组:「技术 SEO」是机器看得见的入场资格;「国际化与算法」讲跨语言一致与排序机制;「内容生产」讲怎么写才可被抽取;「答案引擎优化」讲怎么让机器「找」到你;「生成式 GEO 核心」讲怎么让机器「信」你;「监测与数据」讲怎么把效果测出来;「Agent 时代」讲怎么让机器「调」你。组内按拼音排序,方便快速检索。
A1 · 技术 SEO(机器看得见的入场资格)
| 术语 | 含义 |
|---|---|
| SEO | 传统搜索排名优化:在搜索索引里为关键词争排名。GEO 以它为地基延伸,而非推翻(第 1 章) |
| LSO | 本地搜索优化:让本地商家在区域搜索与 AI 推荐里被看见、被引用(第 3 章) |
| 技术五关 | 可达 → 可渲染 → 可理解 → 可抽取 → 可信 的五关自检链,用于定位"机器为何看不见你" |
| 可达(Crawlability) | 第一关:AI 爬虫进不进得来。核对 robots、放行爬虫 UA、排查 CDN/WAF/托管静默拦截 |
| 可渲染(Renderability) | 第二关:抓进来的原始 HTML 是不是真内容。纯 JS 渲染(CSR/SPA)对多数 AI 爬虫几乎是空壳 |
| 可理解(Understandability) | 第三关:结构能否分清主次。靠标题层级、语义化标签、Schema 传达"这是标题、这是答案" |
| 可抽取(Extractability) | 第四关:能否整段干净取出。结论前置、Q&A 结构、可抽取块让机器干净地"拿答案" |
| 可信稳定 | 第五关:能否持续回抓。服务器稳定、负载可控、不频繁 5xx |
| 抓取(Crawl) | 爬虫按链接发现并下载页面。抓取是花预算的,结构越清晰越省 |
| 索引(Index) | 把抓到的内容分析归类进索引库。进不了索引 = 不在 AI 的候选池里 |
| 排名(Rank) | 用户提问时从索引挑最相关结果的排序。传统 SEO 优化这一环,GEO 优化"AI 作答选谁当引用" |
| Core Web Vitals | 加载(LCP)、交互(INP)、布局稳定(CLS)三项核心体验指标 |
| INP | Interaction to Next Paint,衡量"点击到下一帧"的响应速度,已取代 FID |
| LCP / CLS | 最大内容绘制(加载)/ 累计布局偏移(视觉稳定)的体验指标 |
| Schema | 结构化数据(如 JSON-LD),告诉机器页面里哪些是价格、评价、问题、答案 |
| Canonical | 规范标签,标注"一页的原版 URL",避免重复内容损耗索引资源 |
| robots / 爬虫 UA | robots 协议与爬虫标识;判断是否放行 AI 爬虫、排查"为防白嫖一刀切" |
| CSR / SPA | 客户端渲染/单页应用;浏览器看着完整,但爬虫拿到的原始 HTML 可能是空壳 |
| 重定向 301 | 把旧地址永久指到新地址,把索引与信任过渡到新页;用错(302/链式跳转)会损耗权重 |
| 规范化域名 | 统一 www 与非 www、http 与 https 的主域口径,避免同一内容被当成多个站点 |
| 站点地图 | 机器可读的页面清单,帮爬虫优先发现与核对「该收的页」;配合全网文件控制抓取预算 |
| 页面速度 | 压缩、缓存、图片格式等减少加载时间的动作,同时影响抓取配额与用户/机器体验 |
| 内容安全策略 | 控制外部资源的加载范围,避免关键脚本被拦导致页面「看起来完整、抓起来是空壳」 |
A2 · 国际化与算法(跨语言一致 + 排序机制)
| 术语 | 含义 |
|---|---|
| hreflang | 标注同一内容的多语言/多区域版本,避免被当重复内容,帮本地用户看到对的语言 |
| 本地化 ≠ 翻译 | 按数字/称呼/计量/文化适配内容,而非逐字翻译。翻译解决"词",本地化解决"人对词的认知" |
| 多语言 vs 多区域 | 同一市场多语种(重一致性)vs 品牌广泛铺开(重地域差异) |
| 实体一致性 | 品牌/作者等跨来源能否被机器识别为同一对象。口径不一致会分散信任 |
| 实体核心字段 | 公司名、成立时间、主营、核心产品等"机器判断是不是同一个你"的关键字段 |
| 算法训练管线 | 标注 → 训练 → 上线 → 迭代 的学习式排序机制,替代工程师手写权重 |
| 质量评估员标注 | 评估员对"查询-结果"打质量分,不作为直接排位,而作"金标准训练样本" |
| 信息增益 | 内容相对既有结果"多给了什么"的独特性。水文(抄一遍)是负资产 |
| YMYL | 与钱/健康/法律相关的 Your Money Your Life 高敏查询,更看权威与时效 |
| 中文转写 | 品牌名的拼音/音译转写需多语言统一,避免 AI 把同一品牌当成不同实体 |
| 反向链接即推荐信 | 高质量、主题相关站的引用传递信任,也让 AI 验证"你确实被可信上下文提及" |
| 国际域名结构 | 用子域/子目录/独立域组织多语言站,每种策略对「实体一致」与抓取的影响不同 |
| 多语言时间一致 | 价格/活动/政策在同一时点的多语言版本口径一致,避免机器看到过期或冲突版本 |
| 术语转写表 | 专名(人名/地名/专有词)的拼音、音译、官方译名统一成一张表,供多语言复用 |
| 排序随任务变化 | 同一个 query 换一个任务(导航/比较/购买)排序就变,内容要匹配「用户此刻的意图」 |
A3 · 内容生产(怎么写才被"抽到")
| 术语 | 含义 |
|---|---|
| 一稿多发 | 同一主题按平台属性改写为多平台版本(改写,不是复制),让同一个「信息核」在各生态长出不同形态(第 9 章 §9.3) |
| VSO | 视频与语音搜索优化:为口语化、带场景的视频/语音 query 优化内容形态(第 4 章) |
| easy_win | 明确、带日期、可一次说清的高性价比内容(价格/政策/对比表等),优先铺 |
| 答案胶囊 | 一口气能念完的答案(40–60 字含结论+数字),语音用户与机器抽取都最爱 |
| 结论前置 | 开头 40–60 字就给出结论+关键数字,铺垫后置 |
| 长尾词 / 口语化长尾 | 用户"张嘴会说"的具体长句;语音 query 尤甚,别只做短词 |
| 增量 | 先看已有高排名内容缺什么(数据/对比/坑),再补,而非重复 |
| 追问式写作 | 用"用户原话"当问题/标题,而非行业术语名 |
| 分人群结论 | 对"值不值/智商税"类问题,分人群给明确结论(对 A 值、对 B 不值,因为…) |
| 分流式平衡答案 | 对比型问题 AI 通常不评第一,而是给"值得考虑的名单"——你要挤进名单 |
| 榜单类内容 | 把"XX 值得用/值得考虑/有哪些好的"铺满多平台,提高被列进名单的概率 |
| 对比表 | 至少 5 个维度的结构化对比(价格/功能/规模/优缺/适用人群),是 AI 最爱抽取的信息块 |
| 数字可回源 | 结论里的数字能指回可信出处,是「可核查」的最小单元,也是「信任」的抓手 |
| 内容四条硬指标 | 判断一篇内容是否「可被引用」的四条硬性标准——结论前置带数字、对比表≥5 维、价格带日期、数字可回源(第 13 章) |
| 一段一意 | 一个段落只讲一个点,配合结论前置,让机器能干净地切块取走 |
| 分平台改写 | 同一主题按平台属性改写而非复制,兼顾「生态绑定」与「信息增益」 |
A4 · 答案引擎优化(AEO:教机器"找"答案)
| 术语 | 含义 |
|---|---|
| AEO | 答案引擎优化:用结构化问答/可抽取块/FAQ 教机器「找」到答案;是 GEO 让机器「信」你之前先要被「找」到的前提(第 5 章) |
| 位置零(Featured Snippet) | 精选摘要/被引擎直接展示的单个答案;赢家通吃、自带信用背书 |
| FAQPage | JSON-LD 结构化数据,给机器一张"这些问题这里能答"的问题面单 |
| Speakable | 标注可被语音引擎朗读的段落 |
| 结构化问答 | "Q:用户原话 A:一句话结论+数字"的组织方式 |
| 可抽取块 | 结论独立成段、不依赖上下文,机器可干净整段拿走 |
| 唯一权威答案 | 同一问题站内只保留一个口径,避免多页打架让机器不知道该引哪个 |
| 语义化标题层级 | H1/H2/H3 层级与内容语义对齐,避免机器分不清主次 |
| 直接答案式开头 | 首段直接回应问句、给出「答案声明」,不做绕圈铺垫 |
| 问题面单 | 把用户会问的高频问题列全,作为 FAQ 与内容的索引骨架,也防漏答 |
| 答案的一致性 | 同一问题在不同页面/新旧内容里的口径一致,才不会被机器识别为「自相矛盾」 |
A5 · 生成式 GEO 核心(教机器"信"答案)
| 术语 | 含义 |
|---|---|
| GEO | 生成式引擎优化:让 AI 引用/推荐你、替你说话,而非抢排名 |
| 引用(Citation) | 引擎作答时把你列为信源。是"持续的被认可",难靠付费直接买走 |
| 默认答案 | 某个品类下 AI 长期反复选择的答案,形成心智 = 复利 |
| 生态绑定 | 有内容生态的引擎优先引用自家生态(如:某引擎吃自家内容平台、某引擎吃长图文轨道等)(第 9 章 §9.1) |
| n=1 单次测试 | 方向性信号,判断"有没有戏",快但波动大 |
| 多次采样 | 统计口径,验证稳定结论、修正刻板印象 |
| 三层价值(排名/引用/信任) | 排名解决"被看见",引用解决"被提到",信任解决"被采信",一层比一层难买 |
| 被引用 / 被信任 | 从「被找到」到「被采信」的跃迁:被引用是持续被选为信源,被信任是让它长期采信你;信任比引用更难买(第 6 章) |
| 可核查 | 给机器「可核验的事实」(含可回源的数字、口径一致的结构化信息),是 AI 判断可信的最小依据(第 2、6 章) |
| 窗口期 | 现阶段多数引擎"答案不敢卖广告",有机引用最干净,是"花内容的钱占信任的坑"的最值钱期 |
| 引用属性 | 引擎作答时把来源列名,是「持续被认可」的可观测信号,难靠一次性投放买断 |
| 正面共识积累 | 跨来源一致的正面描述,是 AI 判断「靠不靠谱」的重要输入 |
| 名称口径统一 | 品牌名/简称/英文名全局一致,避免同一实体被拆成多个对象 |
| 业内第三方背书 | 行业协会/媒体/公开报告的正面提及,强化「不只你自夸」的可信度 |
A6 · 监测与数据(把效果测出来)
| 术语 | 含义 |
|---|---|
| 引用份额 | 你的内容在 AI 回答中被引用的占比 KPI |
| 变化看板 | 记录"上次被引/未被引 → 这次被引/未被引"的连续监测输出 |
| 固定问题集 | 锁定一组核心 query 作长期观测样本,才有趋势意义 |
| 限速 / 风控 | 自动化提问要有分钟级间隔+每日上限;实测某引擎高频提问约 30 次会触发风控 |
| AI 亮相基线 | 用"品牌名+品类"去几个引擎记录的起点快照,没有基线就谈不了变化 |
| 引用率 | 固定题目集中内容被引用的次数占比,是最高层可量化的 GEO 指标 |
| 采样轮次 | 每轮测几个引擎、每轮标记「被引/未被引+引用源」,决定结论是方向还是口径 |
| 采样口径 | n=1 单测作方向信号 vs 多次采样(如 117 条)定统计口径;报告分出「方向」与「口径」,别拿一次 n=1 偶然当结论(第 8 章) |
| 变化对照日志 | 记录「上次被引→这次如何」的连续轨迹,避免只看单点截图定结论 |
| 阈值裁定规则 | 事先定好的「多少次算多、多少样本算数」裁定口径,防止临时改标准 |
A7 · Agent 时代(让机器"调"你)
| 术语 | 含义 |
|---|---|
| Agent 时代 | 优化对象从"被说到"变成"被调到"——让 AI/Agent 执行任务时调用你的产品/数据/服务 |
| 被调用 | AI Agent 在执行任务时直接调用你的产品/数据/服务;是「被信」之上再进一步的「被用」(第 14 章) |
| Agent 选中率 | AI 代理执行任务时选中你的比例 |
| 数据基建三层 | 结构化(机器可读)→ API 化(接口可调)→ 官方事实页(价格可核) |
| 实时可刷新 | 价格/库存数据更新延迟过大,Agent 会认为你不靠谱而略过 |
| 机器可读信任层 | 退货政策、资质、评分等"程序可核验"信息用结构化方式表达 |
| 可调用字段 | 为 Agent 预留的机器可读字段(接口字段名、数据格式),让任务能接上你的数据 |
| 服务目录 | 结构化列出「能提供什么服务、覆盖什么范围」,供 Agent 按任务匹配 |
| 就绪度评分 | 按「结构化 → API → 事实页」给品牌打的可执行性分,定位「最缺哪一层」 |
| 幂等调用 | 接口多次调用返回一致结果,是 Agent 敢信任你的前置条件之一 |
| 实体护城河 | 品牌在 AI 心中形成的稳定、正面形象(跨来源实体一致 + 正面共识积累慢慢沉淀),让 AI 长期、正确地认识你(第 14 章 §14.5) |
检索提示:这张术语表是"地图"不是"字典"。遇到哪个词,先判断它属于七组里的哪一组,就能联想到它能解决哪一层问题——技术五关管"能不能看见",生态绑定管"铺在哪",引用份额/变化看板管"有没有效"。把地图装在脑子里,比背定义有用。
附录 B · 参考案例要点速查
用法:做完一章、要动手执行、或复盘项目时,按你的场景找对应行,先对"关键动作"是否做到,再看"反例"有没有踩。这里把正文里的做法压缩成"做了什么 vs 千万别做什么",是一张贴着用的检查单。
B1 · 技术 / 内容干货
| 场景 | 关键动作 | 反例(别这样做) |
|---|---|---|
| 技术可达 | 先跑"技术五关",排查 AI 爬虫是否被静默拦掉 | 不做技术自检就埋头改内容;把技术当"加分项"而非"入场资格" |
| 技术优先级 | 用艾森豪威尔四象限(紧急/重要)排序,Quick Wins 先行 | 胡子眉毛一把抓,或只追下次更新 |
| 全文索引 | 修模板级 Canonical、解除误 Disallow、统一 hreflang 恢复数万页索引 | 放任 noindex/空壳页/乱码 URL 吞噬索引预算 |
| 关键词研究 | 把"行业词"翻译成"用户原话/疑问句",建一主题多问法 | 只堆 "名词词典"、堆砌关键词当优化 |
| 内容资产观 | 做"完整可反复引用的 FAQ/指南",看重可累积 | 只做蹭热点短文;把"排名是租的"当成"内容能一直租" |
| 核心体验 | 盯 LCP/INP/CLS,性能与 AI 抓取、转化双重关联 | 忽略性能,让首屏空壳页骗过眼睛却没骗过爬虫 |
B2 · 本地 / 多语言 / 国际化
| 场景 | 关键动作 | 反例(别这样做) |
|---|---|---|
| 本地商家 | 四大盘面 NAP 一字不差、地图钉校准、引导真实评价 | 买好评、十条五星刷上去、对差评视而不见 |
| 知识度运营 | 两百条真实评价 + 认真回差评,把"处理态度"当加分项 | 以为知名度=好评率,少评少回也自认"还行" |
| 本地 AI 覆盖 | 在 2–3 个 AI 问答入口自测"品牌+城市+服务"出现率 | 只盯地图包第一,误以为 AI 推荐里也必有你 |
| 多语言 | hreflang 分版本 + 本地化重写(数字/称呼/计量/文化) | 逐字翻译、忽略文字方向、半吊子本地化 |
| 跨语言一致 | 品牌名/实体核心字段跨语言一字不差,URL 清晰 | 中英文品牌名各自为政,AI 认不出是同一个实体 |
| 多语言时间一致 | 价格/活动/政策各语言版本同一时点口径一致 | 只更新其中一个语言、另一个语言留着过期版本 |
| 多区域差异 | 汇率为计量单位、区域口径分开维护 | 用一套全球默认轮子打天下,忽略区域差异 |
B3 · 视频 / 语音
| 场景 | 关键动作 | 反例(别这样做) |
|---|---|---|
| 视频标题 | 标题贴用户原句、字幕做成章节化逐字稿 | 自嗨式"震撼!重磅!",机器读不到关键词 |
| 视频合集 | 建"答案专辑"合集,让引擎知道同一主题集合 | 零散发布,引擎不知道该归到哪一主题 |
| 语音搜索 | 单独做口语化长句 + 答案胶囊(40–60 字含数字) | 只做短词,忽略语音 query 的口语长句特征 |
| how-to 兜底 | 图文/官方文档兜底,别让视频单独扛 | 症状型问题只上视频,结果引擎纯模型作答、没引用 |
| 口播脚本 | 前 3 秒给结论、口语化逐字稿 | 自我介绍式拖时长,前 3 秒抓不住人也读不出关键词 |
| 视频元数据 | 标题/描述/标签与「用户原句」对齐,字幕带时间戳章节 | 元数据写行业黑话,机器与用户都对不上 |
B4 · 从业者 / 教育赛道
| 场景 | 关键动作 | 反例(别这样做) |
|---|---|---|
| 教育负面词 | 分人群算清账、给判断框架(对 A 值/对 B 不值) | 公关式否认"不是智商税",把定义权让给别人 |
| 教育投入 | 先用 3–5 个真实家长 query 测引擎引不引用,再定投入体量 | 闷头铺 10 篇高成本内容换来零引用 |
| 对比型问题 | 挤进 AI 的"分流名单",铺榜单/评测/选型内容 | 死磕"当第一",目标定错白费 |
| 价格内容 | 带日期、分版本、可核查的官方价格页 | 陈旧模糊报价、价格写在 PDF 里机器读不到 |
| B2B 长链条 | 漏斗每层(认知/比较/决策)都配可被引答案 + 供应商身份机器可读 | 只追购买/成交词,把弹药全压在最后 |
B5 · Agent 准备
| 场景 | 关键动作 | 反例(别这样做) |
|---|---|---|
| 数据可读 | 结构化可回答字段(价格/库存/服务范围) | 数据只给人看,机器读不到或缺字段被跳过 |
| 数据时效 | 价格/库存实时可刷新 | 库存更新延迟大,Agent 认为你不靠谱而略过 |
| 信任层 | 退货政策/资质/评分做成程序可核验 | 关键信息只有自然语言、无可机器核验 |
| 页面可达 | 关键页稳定可抓、不 5xx、不空壳 | 页面 5xx/超时,让 Agent 抓不到你 |
| 服务目录结构化 | 把「能做什么、覆盖什么范围」结构化成机器可读字段 | 服务能力只用自然语言写在长文里,机器匹配不到 |
| 就绪度自检 | 按「结构化 → API → 事实页」三层打分定位缺口 | 只看「有官网」就以为 Agent 就绪,其实关键数据读不到 |
B6 · 数据与监测
| 场景 | 关键动作 | 反例(别这样做) |
|---|---|---|
| 引用监测 | 固定问题集 + 固定采样节奏 + 变化看板 | 散落截图、单次定论、没有趋势 |
| 实验纪律 | n=1 与多采样分开标注,报告写明是方向还是口径 | 拿一次 n=1 偶然当"结论" |
| 风控 | 自动化内置限速(间隔+每日上限+退避) | 高频猛问,把账户/工具测挂 |
使用建议:这张表对应正文 12 章,覆盖"技术/内容/本地/多语言/视频/从业者/教育/Agent/监测"九类场景。做法可以记,但别照搬——每个场景落到你行业,都要加入你自己的实测(尤其引用率),因为它会随时间与引擎版本变化。
附录 C · 思考与练习参考答案(部分)
说明:正文每章"思考与练习"按 🔵 入门 / 🟡 进阶 / 🟠 高阶 分档。这里给的是关键判断题与开放题的参考答案,判断题给对错+理由,开放题给"作答要点"而非唯一答案——你的行业、案例、数据不同,落点可以不同。先独立作答,再对照本篇。
核心判断题对错速查
先把几道最常被问、也最容易答反的判断题汇成一张「对错卡」,复习时一眼看清。
| 判断题 | 答案 | 一句话理由 |
|---|---|---|
| 多语言项目只需翻译一遍就够? | 错 | 还要做本地化重写(数字/称呼/计量/文化适配) |
| 知名度 = 好评率? | 错 | 知名度是可经营的综合信号,评价数量质量与回应态度都算 |
| 语音搜索要不要专门优化? | 要 | 语音是口语化长句,需单独喂长尾 + 答案胶囊 |
| AEO 和 GEO 是一个东西吗? | 否 | AEO 教机器「找」答案,GEO 教机器「信」答案,AEO 是 GEO 的基础 |
| 对比型问题要争「第一名」? | 否 | 目标是挤进 AI 给出的「分流式平衡答案」名单 |
| 高成本教育内容闷头铺就对? | 错 | 先用 3–5 个真实 query 测引用,再决定投入体量 |
| GEO 意味着把 SEO 扔掉? | 否 | GEO 建在 SEO 地基上,是延伸而非推翻 |
| n=1 单次测试能当结论用吗? | 否 | 只当方向信号,结论要靠多次采样的统计口径 |
开放题作答框架(通用)
开放题没有标准抄写,但有稳定的作答骨架。遇到拿不准的题,按「是什么 → 为什么 → 怎么做 → 我怎么验证」四步展开,通常就对:
- 是什么:先给结论(把判断/立场说清楚,别绕圈);
- 为什么:给出 2–3 个支撑的理由或机制解释;
- 怎么做:落成可执行的动作或清单(别停在抽象层);
- 我怎么验证:说明用什么 query、什么手段去测、用 n=1 还是多次采样来确认。
这一框架和正文「结论前置、数字可回源、可执行」的写作纪律是同一套逻辑,作答时复用不但省时间,也更贴「数据驱动」的评量取向。
第 1 章 SEO 地基
- 🔵 入门档·列出"用户问法 vs 行业词"不一致的例子:示例——行业说"CRM",用户问"适合 20 人团队还便宜的客户管理是啥",行业说"全屋定制",用户问"全屋定制和木工打哪个划算"。要点:用"人话/疑问句/场景"组织内容,而非术语名。
- 🟡 进阶档·长期资产选谁:选 B(完整可复引的 FAQ/指南)。理由:内容像房产可累积,AI 时代会被反复引用;蹭热点短文是"租的",时效一过就没价值。
- 🟡 进阶档·技术五关 curl 自查:对站点跑
curl -A <爬虫 UA> 你的网址,逐关记录"可达(返回 200/403/429)→ 可渲染(源码里有没有正文)→ 可理解(有没有标题层级/Schema)→ 可抽取(结论是否前置)→ 可信(能否稳定回抓)",结论写入文档。 - 🟠 高阶档·艾森豪威尔四象限排序:第一象限(紧急且重要,如误 Disallow/noindex)立刻修;第二象限(重要不紧急,架构/Schema/性能)排 Sprint;第三象限(紧急不重要,低价值 404 重定向)委派/自动化;第四象限(不紧急不重要)删除或忽略。每条说明归类依据(影响面/投入/时效)。
- 展开·为什么「结论前置」第一优先:AI 抽取与用户扫读都先看开头 40–60 字;开头就给结论和关键数字,等于替机器标出「答案」,也符合「可抽取块」的要求,是所有内容动作的通用前提。
第 2 章 国际化与算法
- 🔵 入门档·判断:多语言项目只需翻译一遍? 错。多语言项目要做"本地化重写"(数字/称呼/计量/文化适应),只翻译一遍既不专业、又会让机器难理解。
- 🟡 进阶档·本地化≠翻译的重写清单:至少覆盖四轴——数字与格式(货币/日期/小数分隔)、称呼与措辞(敬语/"您/你")、计量单位(米/英尺、摄氏/华氏、字符方向)、文化约定(颜色/图片/举例场景)。每个都给出"源语言→目标市场"的改写示例。
- 🟠 高阶档·用算法训练管线解释某项 SEO 直觉:例如"为什么原创/实体/可核查一直被验证有效"——因为模型从大量质量标注里反推哪些特征组合能预测高分,而原创性、实体一致、数据可核查正是"评估员一看就觉得这页质量高"的稳定信号;所以持续做对的事,比追某次更新更稳。
- 展开·实体字段怎么列:至少写全「公司名 / 成立时间 / 主营 / 核心产品 / 一句话定位 / 官网字段口径」,并核对跨语言、跨平台是否一致——这是机器「认不认得出你是同一个」的依据。
- 展开·为什么「中文转写」单独留意:中文品牌名有拼音、音译、英文名多套写法,若各自为政,AI 会把同一个品牌当成好多个实体来对待,可信度和引用都被摊薄。
第 3 章 本地搜索优化
- 盘点 NAP 应在哪四个盘面一致:地图、点评/评论、本地生活平台、短视频本地生活(也可含品牌官网)。名称/地址/电话/品类/营业时间一字不差。
- 判断:知名度 = 好评率? 错。知名度是可经营的综合信号(评价数量质量、被提及、活跃度、权威背书),拉到两百条真实评价+认真回差评,胜于十条五星刷量。
- 展开·本地 AI 覆盖怎么自测:在 2–3 个 AI 问答入口用「品牌 + 城市 + 服务」去问,看自己有没有出现在回答里;只盯地图包第一是不够的,因为 AI 推荐和地图排名是两套机制。
第 4 章 视频与语音搜索优化
- 改写答案型视频脚本:把口播改写成"标题贴用户原句 + 前 3 秒给结论 + 字幕按章节(结论/原因/步骤)+ 归合集"。示例:原口播自我介绍式开场,改为"孩子初二理化不行怎么办?答案是分三步…"。
- 判断:语音搜索要不要专门优化? 要。语音 query 是口语化长句、带场景情绪,需单独喂口语长尾 + 答案胶囊;只做短词会漏掉语音流量。
- 进阶级·五步改造视频:定答案(问题写成标题)→ 分章节(结论→原因→步骤)→ 逐字稿化(字幕)→ 归合集 → 兜底(how-to 配图文/文档)。
- 展开·语音为什么不一样:语音 query 是口语化长句、带场景与情绪(「我孩子初二理化不好怎么办」而非「初二物理辅导」),所以要有单独的答案胶囊和口语长尾,不能只优化短词。
第 5 章 答案引擎优化
- 写 5 条 FAQ:遵循"Q 说用户原话 / A 结论前置带数字"。示例——Q:工具适合多少人团队?A:20–50 人团队,人均月成本约 30 元,支持分群与自动化跟进。
- 判断 AEO 与 GEO 的关系:AEO 教机器"找"答案(结构+FAQ,让人能被抽出来),GEO 教机器"信"答案(可核查+可信,让人被采信),AEO 是 GEO 的基本功——先能被找到,才谈得上被信任。
- 进阶级·3 个问题页 Schema 清单:对每个问题页列出要配的精准属性——产品页加价格/库存/评分,FAQ 页加 Question-Answer 结构;结论前置、带数字、结构可拆。
第 6 章 GEO 核心概念
- 用三层分析品牌最缺哪层:分别答"能不能被搜到(排名)→ AI 作答时选不选你(引用)→ 说了算不算数(信任)",指出最弱一层并给对应动作(缺引用→补内容/信源;缺信任→改口径/一致性/可核查)。
- 为什么国内引擎暂不敢卖 AI 答案广告:AI 答案里带广告会瞬间透支信任,用户立刻怀疑 AI"偏袒",整套信任塌方;所以宁可短期不赚这个钱。对你的含义:现阶段有机引用最干净、没有付费入口跟你抢,是"花内容成本占信任坑"的窗口期。
- 展开·三层分析的行文模板:对任意品牌都按「现状 → 最缺 → 动作 → 验证」写——「它现在排名(概况),最缺的是引用/信任(理由),对应动作是补内容/信源 或 改口径/一致性(具体项),用某类 query、某个引擎、n=1 先验方向再多次采样验证」。
第 8 章 实测方法论(数据发动机)
- 设计 5 个 query 采样计划:固定同一套题,覆盖 how-to/对比/带价格/品牌词等不同 query 类型;明确每次测几个引擎、每轮标记"被引/未被引+引用源";n=1 作方向、多次采样作口径分开记录。
- 防风控限速方案:分钟级间隔 + 每日上限 + 指数退避(触发后拉长间隔);明确阈值(如每小时不超过某次)、超限自动停、第二天自动恢复。
- 展开·采样计划怎么定题:5 个题至少覆盖「how-to(教怎么做)」「对比(A 还是 B)」「带价格(多少钱)」「品牌词(某品牌怎么样)」「测评/真相(值不值/是不是智商税)」五类;每类代表一类用户的「决策动作」,覆盖面够才能当长期样本用。
第 9 章 信源选择
- 为什么给某引擎喂问答社区内容常常没用(生态绑定):有内容生态的引擎优先引用自家生态;该引擎吃自家内容平台,问答社区不在它的"供应链"里,铺再多也难进它的引用(且问答社区在部分引擎引用弱,别迷信)。应对:先确认目标引擎,把内容铺进它爱吃的生态。
- 决策树补充:通用引擎打底用「官方博客 + 结构化文档」;结论要标「是哪家引擎、哪个时点测的」,别写死「永远如此」。
- 设计"一分主题×三个平台"改写矩阵:同一主题按平台属性改写——B 端长文方法论喂某长文平台,干货技术文喂某技术社区平台,答案型短视频喂某短视频平台;改写而非复制。
- 进阶级·决策树:先定目标引擎,再走分支——喂某引擎→其生态轨道;喂通用引擎→官方博客+结构化文档打底;最后每季度复核演化。
第 10 章 从业者赛道
- 判断:对比型问题应追求的排名目标? 挤进 AI 的"分流名单",而非争第一。因为对比型问题的答案形态是"分流式平衡答案",AI 通常给一份值得考虑的名单;你要做的是铺榜单/评测/选型内容、让品牌名高频出现在"对比/推荐"语境里。
- 帮"三件套"里的帮助中心建 5 个症状章节:按症状组织,如"为什么投不出去/掉量怎么办/怎么开通/费用怎么算/常见报错",每节结论前置、步骤清晰。
- 展开·帮助中心为什么按症状分:用户搜的是「问题 / 报错」而不是「功能名」,按症状组织标题才和真实 query 对上,机器也更容易把一段结论当可抽取答案取走。
第 11 章 教育赛道
- 设计 3 个家长 query 的负面占位标题:示例——"XX 到底是不是智商税?一文拆清适合谁""花这钱值不值?分人群算笔账""XX 话好还是家学好?给家长一张对照表"。要点:覆盖"值不值/智商税/对错对比"字眼,标题即给判断框架。
- 判断:教育高成本内容如何决定投入? 先测引用再投入:用 3–5 个真实家长 query 去引擎看内容是否出现在引用里,再决定投入体量——别闷头铺 10 篇换零引用。
- 高阶级·健康税模板:用"分人群+算清账"——"XX 适合【某类人群】,因为【收益】;对【另一类】可能不值,因为【成本/上手】;关键看【核心诉求】是否匹配"。带真实数据/成本/有效期,可核查。
- 展开·分人群为什么重要:同一产品对不同人群价值天差地别,给「对谁值、对谁不值」的判断框架,才能让 AI 在「值不值」类问题上引用你,也避免无脑站队。
第 13 章 GEO 工作流
- 首轮两周行动清单:第一周 Query 研究+信源决策+首批 3 篇(产出问题面单、定档矩阵);第二周分发上架+首轮回测 n=1(产出引用率基线)。首轮重点是"跑通+拿基线",不是做大量。
- 用四条硬指标自检一篇内容:逐条核对——结论前置 40–60 字带数字?对比表≥5 维度?价格带日期?数字可回源?不过关列出具体要改的点(如"第三段结论后置,需前置到开头 60 字")。
- 展开·首轮为什么只要 3 篇:目的是「跑通闭环 + 拿基线」,不是追求量。先确认链路各环节都通、能稳定测出引用率,再扩量,才不浪费资源在还没验证的打法上。
第 14 章 Agent 时代
- 推演行业 2 年后 Agent 会"调用"哪些数据类型:建议按"结构化字段/接口/官方事实页"展开——如你的行业最常被 Agent 查询的是价格、库存、资质、服务范围,评估是否已开始埋结构(结构化+API+事实页)。
- 用三层数据基建审计品牌缺哪层:对照"结构化(机器可读)→ API 化(接口可调)→ 官方事实页(价格可核)",指出当前最缺的一层与补法(例如只有自然语言价格、没有结构化+可核页面,则优先补结构化+事实页)。
组合大作业:一周上手清单
如果你不确定从哪里开始,用这张「第一周」清单把整本书串成一次真实落地。每天做的事都很小,但连起来就是一次完整闭环。
| 天 | 任务 | 产出 |
|---|---|---|
| 第 1 天 | 学前测:用一个「品牌名+品类」问法去 2 个引擎各问一次 | 各自的「AI 到底怎么说我」截图 + 《曝光快照》初稿 |
| 第 2 天 | 技术自检:对品牌站跑技术五关 curl 自查 | 逐关结论(可达/渲染/理解/抽取/可信)文档 |
| 第 3 天 | 定 5 个核心 query(覆盖 how-to/对比/价格/品牌/真相) | 一张问题面单 + 一份定档矩阵 |
| 第 4 天 | 按四条硬指标写第 1 篇「重内容」(结论前置/对比≥5 维/价格带日期/数字可回源) | 1 篇可复跑的内容样品 |
| 第 5 天 | 把第 1 篇按「生态绑定」铺到目标平台(改写而非复制) | 分发后的内容 + 落地链接记录 |
| 第 6 天 | 首轮回测 n=1:重问相同 query,标记「被引/未被引+引用源」 | 引用率基线首笔数据 |
| 第 7 天 | 复盘:写 3 条「下周调整优先级」,归入个人作品集 | 一份可存档的复盘与基线看板底稿 |
落点提示:这周清单默认「你已有一条能访问、能改的线上内容」。若你刚开始做、手头没有品牌资料,就把「品牌」替换成本教材或你正在学习的产品,用同样方法走完一遍——方法不变,练的是「走通闭环」本身。
对照提醒:参考答案给的是"作答要点",不是"标准抄写"。判断题看理由,开放题看是否覆盖了关键维度。若你的答案和参考不一致但逻辑成立、且有自己数据支撑,同样合格——这恰恰是这个领域"数据驱动"的体现。
附录 D · 延伸阅读与学习中心实操挂钩
本教材与平台学习中心是一套配套:读一章 → 在学习中心即时自测 → 期考解锁 → 用"学习信号"反哺内容改进。下表把 15 个延伸方向分别映射到"学习中心的具体操作"和"你要完成的一个收尾动作",让你的学习不只在"读"上,而在"练—测—改—存"的闭环里。它呼应的正是前言的「A 一星级入门级 G1 / B 二星级基础级 G2 / C 三星级进阶级 G3 / D 四星级高阶级 G4 / E 五星级专家级 G5」五级路径(星级与 G 编号一一对应,口径见前言「路径总览」表),并把前面各章的方法串进同一条学—练—测—改闭环。
| # | 延伸方向 | 学习中心实操挂钩 | 完成动作 |
|---|---|---|---|
| 1 | 把本章概念立即巩固 | 节级自测:读一节的"课后自测"本地即时判分 | 逐章逐节过一遍自测,答错回看正文对应小节 |
| 2 | 验证阶段掌握程度 | 正式/阶段考试:入门→基础→进阶→高阶→专家五级解锁 | 完成对应层级考试(客观/简答/方案);客观达标+简答人审达标才发证 |
| 3 | 简答/方案题的快速反馈 | AI 辅助判分:审题界面"AI 预评"给建议分 | 提交简答→看 AI 预评→人工复核→修正后填入 |
| 4 | 让学习数据驱动内容改进 | 学习信号→自进化:薄弱题聚合→FIX 提案 | 看通过率低的题,评估是否固化为内容改进候选 |
| 5 | 用真实引擎做实测 | 在学习中心用真实引擎做 n=1 快测,积累多轮行为数据 | 每轮测"品牌+品类"query,记录被引/未被引 |
| 6 | 建立可持续引用监测 | 用学习中心信号/统计作"变化看板"底稿 | 保存每轮对比,周/月复查趋势 |
| 7 | 关注引擎生态演化 | 关注学习中心的引擎实测与更新说明 | 每季度重测核心 query,刷新自己的引用基线 |
| 8 | 面向 Agent 落地 | 用第 14 章方法清单对品牌做"可调用"自查 | 输出一份 Agent 就绪度清单,回填学习记录 |
| 9 | 国际化实操 | 用第 2 章 hreflang/本地化清单对海外站自查 | 完成多语言重写清单并记录差异 |
| 10 | 技能到产出闭环 | 每章完成"方法清单+自查清单"后归入个人作品集 | 把 GEO 小样/提案/监测看板存档,作为能力证明 |
| 11 | 概念与动作的分工 | 对照「附录 A 术语地图」按主题组检索 | 遇陌生词归到七组之一,联想到它解决哪一层问题 |
| 12 | 执行时对着抄动作 | 用「附录 B 案例速查」当检查单 | 按场景核对「关键动作」做到没、踩没踩反例 |
| 13 | 作答自查 | 用「附录 C 参考答案」对答案 | 先独立答,再对照理由与作答维度,别直接抄 |
| 14 | 一周闭环验证 | 用「一周上手清单」跑一次真实闭环 | 走通 Query→内容→分发→回测,留基线数据 |
| 15 | 把学习信号回流 | 关注学习中心的统计与「自进化」提示 | 每季度复盘薄弱点,生成一轮内容改进候选 |
教材与学习中心的三线对照
把整个学习体验比作三条互相咬合的线,你同时踩住「地图、训练场、检验场」三端才最有效:
| 线 | 载体 | 在哪儿 | 作用 |
|---|---|---|---|
| 知识线(地图) | 正文各章 + 术语总览 | 教材 | 讲清「是什么、为什么」 |
| 动作线(训练场) | 方法清单 / 自查清单 / 附录 B | 教材 + 学习中心 | 给出「怎么做」的可执行步骤 |
| 检验线(检验场) | 节级自测 / 正式考试 / 人机环 | 学习中心 | 验证「做没做到、学没学会」 |
一句话:教材装的是「地图」,学习中心是「训练场」和「检验场」。三线并进,第 0 部分(前言)的约定、目录导航、五级锁、红线说明才都不是摆设——它们共同把你从「读得懂」推向「做得出」。
推荐使用流程(建议顺序)
- 选路径:按第 0 部分(前言)的路径总览,选定你的主线(A 一星级入门级 G1 / B 二星级基础级 G2 / C 三星级进阶级 G3 / D 四星级高阶级 G4 / E 五星级专家级 G5),与学习中心门控一致。
- 逐节学跳:读正文一节 → 过"节级自测"即时判分,答错回看,把"概念"变成"能做"。
- 逐章作业:完成每章"方法清单 + 自查清单",产出可存档的成果(模板/清单/小样)。
- 逐级考:考对应层级试卷(客观 + AI 辅助判分的简答/方案),客观达标 + 简答人审达标 → 解锁下一级。
- 持续闭环:关注"学习信号",把薄弱点反哺回内容改进,形成"学→测→改"的迭代。
一句话定位:教材是"知识地图",学习中心是"训练场"。地图告诉你哪里有坑、怎么走;训练场让你真踩一遍、真改一遍。两者结合,方法论才变成能力——这也是本附录存在的意义:把 12 章散落的词、案、题、练,串成一张你随时能用的速查表。
本教材为内部培训资料,数据口径以学习中心实测为准;涉及具体引擎行为请以其当下实测为准。